Hugging Face 解读 BigBird 的块稀疏注意力机制
Understanding BigBird's Block Sparse Attention
Hugging Face 发布长文解读 BigBird 的块稀疏注意力,说明其如何用全局、滑动和随机三种注意力近似 BERT 的全注意力,从而以更低计算成本处理最长 4096 的序列。
原文用伪代码和图示拆解 BigBird 的全局、滑动、随机三种注意力,读者可以借此理解块稀疏注意力的实现细节。
引言
基于 Transformer 的模型已被证明对许多 NLP 任务非常有用。然而,基于 Transformer 的模型的一个主要限制是其 O(n2)O(n^2) 时间和内存复杂度(其中 nn 是序列长度)。因此,将基于 Transformer 的模型应用于长序列 n>512n > 512 在计算上非常昂贵。最近有几篇论文,例如 Longformer、Performer、Reformer、Clustered attention 试图通过近似完整注意力矩阵来解决这个问题。如果你对这些模型不熟悉,可以查看 🤗 最近的博客文章。
BigBird(在论文中提出)是最近解决此问题的此类模型之一。BigBird 依赖于块稀疏注意力而非普通注意力(即 BERT 的注意力),并且与 BERT 相比,能以低得多的计算成本处理长度高达 4096 的序列。它在涉及超长序列的各种任务上取得了 SOTA,例如长文档摘要、长上下文问答。
BigBird RoBERTa-like 模型现已在 🤗Transformers 中可用。本文的目标是让读者深入理解 BigBird 的实现,并让使用 BigBird 与 🤗Transformers 变得轻松。但在深入之前,重要的是要记住 BigBird's 注意力是 BERT 完整注意力的近似,因此并不力求比 BERT's 完整注意力更好,而是更高效。它只是允许将基于 Transformer 的模型应用于长得多的序列,因为 BERT 的二次内存需求很快变得难以承受。简而言之,如果我们有 ∞\infty 计算量和 ∞\infty 时间,BERT 的注意力会比块稀疏注意力(我们将在本文中讨论)更受青睐。
如果你想知道为什么在处理更长序列时需要更多计算,这篇博客文章正适合你!
在使用标准 BERT 类注意力时,人们可能会遇到的一些主要问题包括:
- 所有 token 真的都必须关注所有其他 token 吗?
- 为什么不只对重要 token 计算注意力?
- 如何决定哪些 token 重要?
- 如何以非常高效的方式只关注少数 token?
在这篇博客文章中,我们将尝试回答这些问题。
应该关注哪些 token?
我们将通过考虑句子“BigBird is now available in HuggingFace for extractive question answering”来给出注意力如何工作的实际示例。
在 BERT 类注意力中,每个词都会简单地关注所有其他 token。用数学方式表达,这意味着每个查询 token query-token∈{BigBird,is,now,available,in,HuggingFace,for,extractive,question,answering} \text{query-token} \in \{\text{BigBird},\text{is},\text{now},\text{available},\text{in},\text{HuggingFace},\text{for},\text{extractive},\text{question},\text{answering}\} ,
都会关注完整的 key-tokens=[BigBird,is,now,available,in,HuggingFace,for,extractive,question,answering] \text{key-tokens} = \left[\text{BigBird},\text{is},\text{now},\text{available},\text{in},\text{HuggingFace},\text{for},\text{extractive},\text{question},\text{answering} \right] 列表。
让我们通过编写一些伪代码,来思考如何明智地选择查询令牌实际应关注的键令牌。我们将假设查询的是令牌 available,并构建一个合理的应关注键令牌列表。
>>> # let's consider following sentence as an example
>>> example = ['BigBird', 'is', 'now', 'available', 'in', 'HuggingFace', 'for', 'extractive', 'question', 'answering']

>>> # further let's assume, we're trying to understand the representation of 'available' i.e.
>>> query_token = 'available'

>>> # We will initialize an empty `set` and fill up the tokens of our interest as we proceed in this section.
>>> key_tokens = [] # => currently 'available' token doesn't have anything to attend
邻近的令牌应当很重要,因为在句子(词序列)中,当前词高度依赖于相邻的过去和未来令牌。这一直觉正是 sliding attention 概念背后的思想。
>>> # considering `window_size = 3`, we will consider 1 token to left & 1 to right of 'available'
>>> # left token: 'now' ; right token: 'in'
>>> sliding_tokens = ["now", "available", "in"]

>>> # let's update our collection with the above tokens
>>> key_tokens.append(sliding_tokens)
长距离依赖:对于某些任务,捕捉令牌间的长距离关系至关重要。例如,在`问答任务中,模型需要将上下文中的每个令牌与整个问题进行比较,以便找出上下文中的哪部分对正确答案有用。如果大多数上下文令牌只关注其他上下文令牌,而不关注问题,模型就更难从不太重要的上下文令牌中筛选出重要的上下文令牌。
现在,BigBird 提出了两种方法,在保持计算效率的同时允许长期注意力依赖。
- 全局令牌:引入一些令牌,它们会关注每个令牌,并被每个令牌关注。例如:“HuggingFace 正在构建优秀的库以简化 NLP”。现在,假设将 ‘building’ 定义为全局令牌,模型需要知道 ‘NLP’ 与 ‘HuggingFace’ 之间的关系以完成某些任务(注意:这两个令牌位于两端);让 ‘building’ 全局关注所有其他令牌,很可能有助于模型将 ‘NLP’ 与 ‘HuggingFace’ 关联起来。
>>> # let's assume 1st & last token to be `global`, then
>>> global_tokens = ["BigBird", "answering"]

>>> # fill up global tokens in our key tokens collection
>>> key_tokens.append(global_tokens)
- 随机令牌:随机选择一些令牌,它们通过传递给其他令牌来传递信息,这些令牌又可以传递给其他令牌。这可以减少信息从一个令牌传播到另一个令牌的成本。
>>> # now we can choose `r` token randomly from our example sentence
>>> # let's choose 'is' assuming `r=1`
>>> random_tokens = ["is"] # Note: it is chosen compleletly randomly; so it can be anything else also.

>>> # fill random tokens to our collection
>>> key_tokens.append(random_tokens)

>>> # it's time to see what tokens are in our `key_tokens` list
>>> key_tokens
{'now', 'is', 'in', 'answering', 'available', 'BigBird'}

# Now, 'available' (query we choose in our 1st step) will attend only these tokens instead of attending the complete sequence
这样,查询令牌仅关注所有可能令牌的一个子集,同时产生对完整注意力的良好近似。同样的方法将用于所有其他查询令牌。但请记住,这里的重点是尽可能高效地近似 BERT 的完整注意力。像 BERT 那样简单地让每个查询令牌关注所有键令牌,在现代硬件(如 GPU)上可以通过一系列矩阵乘法非常高效地计算。然而,滑动、全局和随机注意力的组合似乎意味着稀疏矩阵乘法,这在现代硬件上更难高效实现。
BigBird 的主要贡献之一是提出了一种 block sparse 注意力机制,允许有效计算滑动、全局和随机注意力。让我们深入了解一下!
通过图理解全局、滑动、随机键的必要性
首先,让我们使用图更好地理解 global、sliding 和 random 注意力,并尝试理解这三种注意力机制的组合如何产生对标准 Bert-like 注意力的极好近似。


上图分别以图的形式展示了 global(左)、sliding(中)和 random(右)连接。每个节点对应一个令牌,每条线代表一个注意力分数。如果两个令牌之间没有连接,则假定注意力分数为 0。
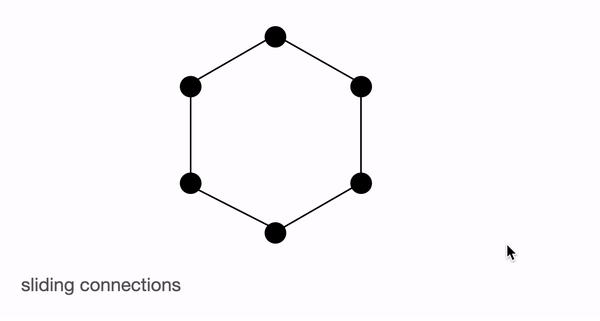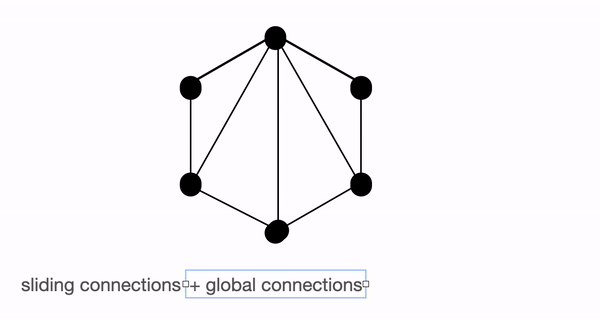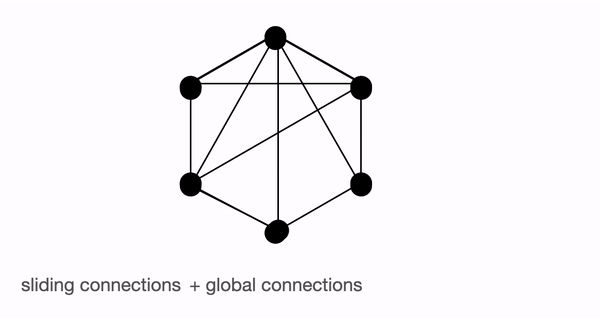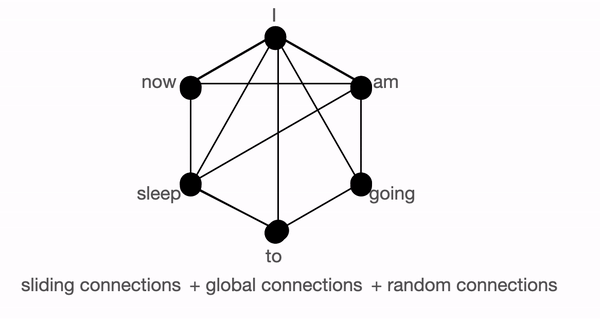

BigBird 块稀疏注意力是滑动、全局和随机连接的组合(总共 10 个连接),如左侧的 gif 所示。而普通注意力的图(右侧)则拥有全部 15 个连接(注意:共有 6 个节点)。你可以简单地将普通注意力理解为所有 token 都进行全局关注1 {}^1 。
普通注意力:模型可以在单层内将信息从一个 token 直接传递到另一个 token,因为每个 token 都会查询所有其他 token,并被所有其他 token 关注。让我们考虑一个与上图类似的例子。如果模型需要将 'going' 与 'now' 关联起来,它只需在单层中即可完成,因为存在一条直接连接这两个 token 的连接。
块稀疏注意力:如果模型需要在两个节点(或 token)之间共享信息,对于某些 token 而言,信息必须沿着路径穿过各种其他节点;因为在单层中并非所有节点都直接相连。
例如,假设模型需要将 'going' 与 'now' 关联起来,那么如果只存在滑动注意力,这两个 token 之间的信息流动就由路径定义:going -> am -> i -> now(即它必须经过另外 2 个 token)。因此,我们可能需要多层才能捕获序列的完整信息。普通注意力可以在单层中捕获这一点。在极端情况下,这可能意味着需要与输入 token 数量一样多的层。然而,如果我们引入一些全局 token,信息就可以通过路径:going -> i -> now(更短)传播。如果我们再引入随机连接,它就可以通过:going -> am -> now 传播。借助随机连接和全局连接,信息可以非常迅速(仅需几层)地从一个 token 传递到下一个 token。
如果我们有许多全局 token,那么我们可能就不需要随机连接,因为会有多条短路径可供信息传播。这就是在处理 BigBird 的一个变体 ETC 时保留 num_random_tokens = 0 背后的想法(更多内容将在后续章节中介绍)。
1 {}^1 在这些图形中,我们假设注意力矩阵是对称的,即 Aij=Aji\mathbf{A}_{ij} = \mathbf{A}_{ji},因为在图中如果某个 token A 关注 B,那么 B 也会关注 A。你可以从下一节展示的注意力矩阵图中看到,这一假设对 BigBird 中的大多数 token 都成立
| 注意力类型 | global_tokens |
sliding_tokens |
random_tokens |
|---|---|---|---|
original_full |
n |
0 | 0 |
block_sparse |
2 x block_size |
3 x block_size |
num_random_blocks x block_size |
original_full 表示 BERT 的注意力,而 block_sparse 表示 BigBird 的注意力。想知道 block_size 是什么吗?我们将在后续章节中介绍。现在,为简单起见,将其视为 1
BigBird 块稀疏注意力
BigBird 块稀疏注意力只是我们上面讨论内容的一种高效实现。每个 token 关注一些全局 token、滑动 token和随机 token,而不是关注所有其他 token。作者为多个查询组件分别硬编码了注意力矩阵;并使用了一个巧妙的技巧来加速 GPU 和 TPU 上的训练/推理。
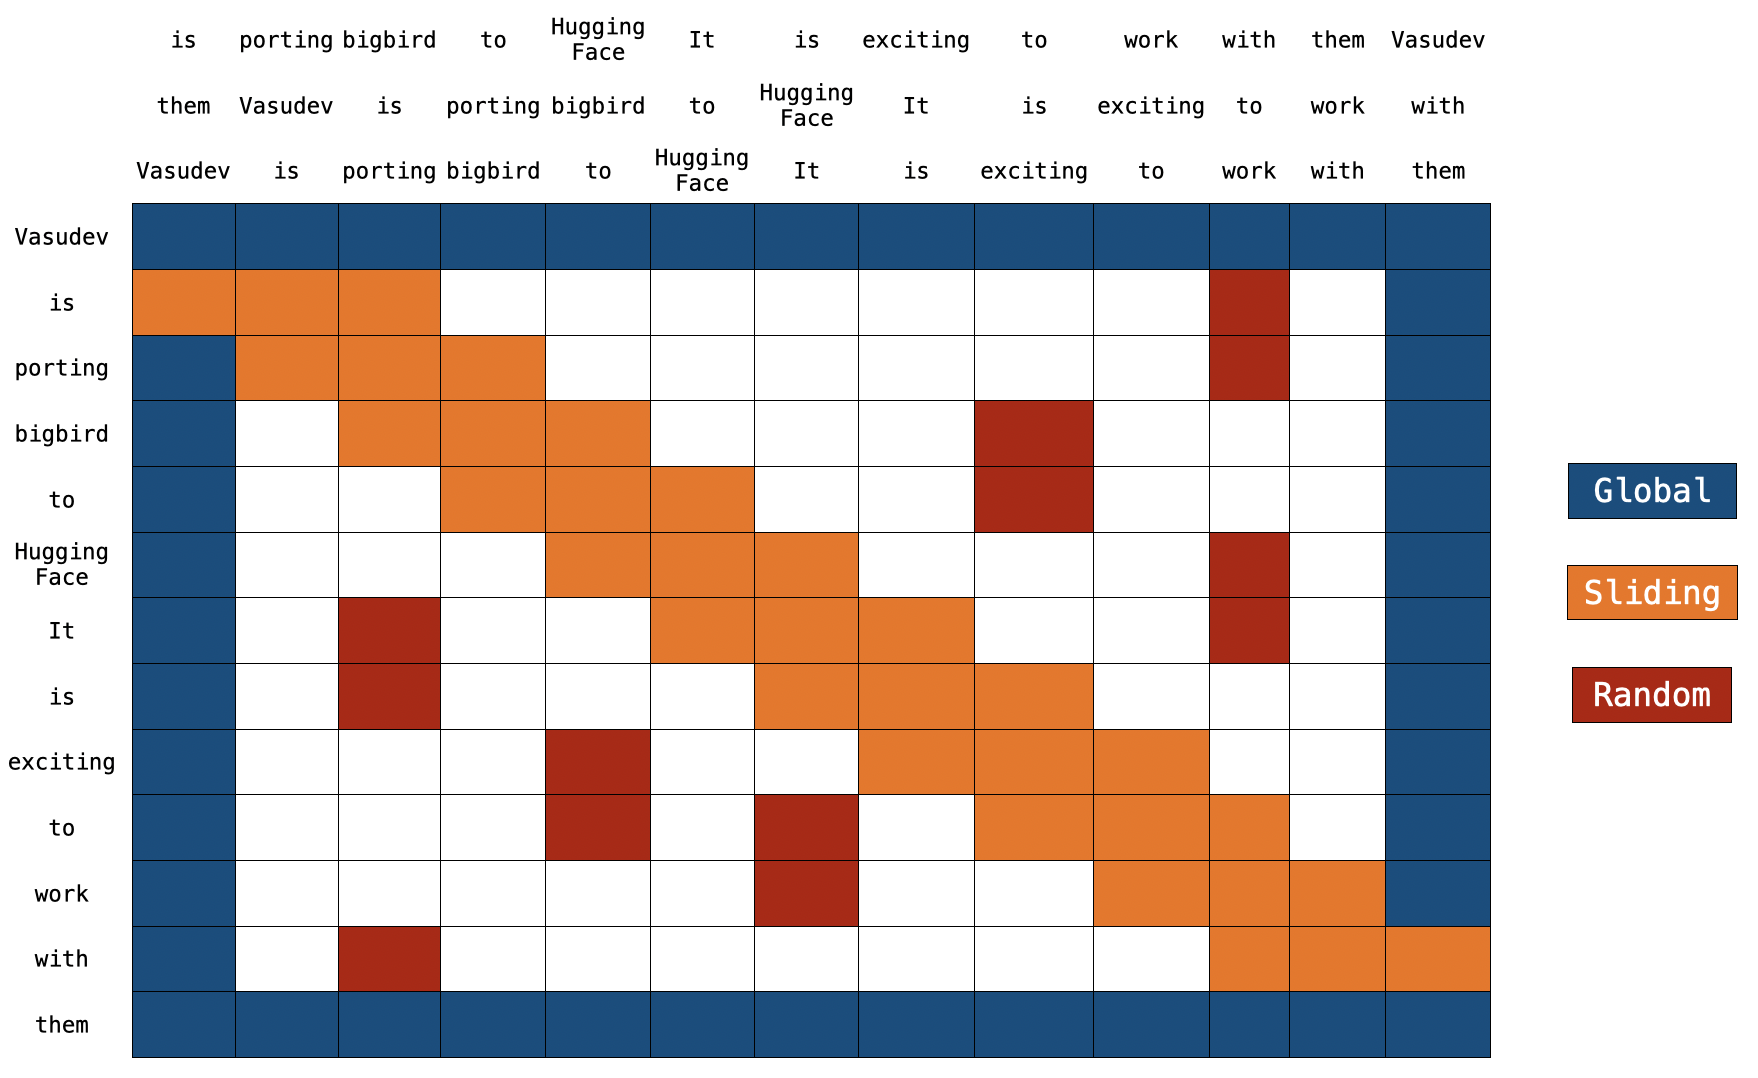 注意:在顶部,我们多了 2 个句子。如你所见,每个 token 在两个句子中都只是被移动了一个位置。这就是滑动注意力的实现方式。当
q[i] 与 k[i,0:3] 相乘时,我们会得到 q[i] 的滑动注意力分数(其中 i 是序列中元素的索引)。
你可以在这里找到 block_sparse 注意力的实际实现。现在这看起来可能非常吓人 😨😨。但这篇文章一定会让你在理解代码时轻松许多。
全局注意力
对于全局注意力,每个 query 只是简单地关注序列中的所有其他 token,并被其他每个 token 关注。让我们假设 Vasudev(第 1 个 token)和 them(最后一个 token)是全局的(在上图中)。你可以看到这些 token 直接与所有其他 token 相连(蓝色框)。
# pseudo code

Q -> Query martix (seq_length, head_dim)
K -> Key matrix (seq_length, head_dim)

# 1st & last token attends all other tokens
Q[0] x [K[0], K[1], K[2], ......, K[n-1]]
Q[n-1] x [K[0], K[1], K[2], ......, K[n-1]]

# 1st & last token getting attended by all other tokens
K[0] x [Q[0], Q[1], Q[2], ......, Q[n-1]]
K[n-1] x [Q[0], Q[1], Q[2], ......, Q[n-1]]
滑动注意力
key token 的序列被复制 2 次,其中一个副本中的每个元素向右移动,另一个副本中的每个元素向左移动。现在,如果我们将 query 序列向量与这 3 个序列向量相乘,我们就会覆盖所有滑动 token。计算复杂度就是 O(3xn) = O(n)。参考上图,橙色框表示滑动注意力。你可以看到图顶部的 3 个序列,其中 2 个偏移了一个 token(1 个向左,1 个向右)。
# what we want to do
Q[i] x [K[i-1], K[i], K[i+1]] for i = 1:-1

# efficient implementation in code (assume dot product multiplication 👇)
[Q[0], Q[1], Q[2], ......, Q[n-2], Q[n-1]] x [K[1], K[2], K[3], ......, K[n-1], K[0]]
[Q[0], Q[1], Q[2], ......, Q[n-1]] x [K[n-1], K[0], K[1], ......, K[n-2]]
[Q[0], Q[1], Q[2], ......, Q[n-1]] x [K[0], K[1], K[2], ......, K[n-1]]

# Each sequence is getting multiplied by only 3 sequences to keep `window_size = 3`.
# Some computations might be missing; this is just a rough idea.
随机注意力
随机注意力确保每个 query token 也会关注一些随机 token。对于实际实现,这意味着模型随机收集一些 token 并计算它们的注意力分数。
# r1, r2, r are some random indices; Note: r1, r2, r3 are different for each row 👇
Q[1] x [K[r1], K[r2], ......, K[r]]
.
.
.
Q[n-2] x [K[r1], K[r2], ......, K[r]]

# leaving 0th & (n-1)th token since they are already global
注意:当前实现进一步将序列划分为块,并且每个符号都是相对于块而不是 token 定义的。我们将在下一节中更详细地讨论这一点。
实现
回顾:在常规 BERT 注意力中,一个 token 序列,即 X=x1,x2,....,xn X = x_1, x_2, ...., x_n ,通过一个全连接层投影为 Q,K,V Q,K,V ,注意力分数 Z Z 计算为 Z=Softmax(QKT) Z=Softmax(QK^T) 。在 BigBird 块稀疏注意力的情况下,使用相同的算法,但只使用一些选定的 query 和 key 向量。
让我们看看 bigbird 块稀疏注意力是如何实现的。首先,让我们假设 b,r,s,gb, r, s, g 分别表示 block_size、num_random_blocks、num_sliding_blocks、num_global_blocks。在视觉上,我们可以用 b=4,r=1,g=2,s=3,d=5b=4, r=1, g=2, s=3, d=5 来说明 big bird 块稀疏注意力的组成部分,如下所示:

q1,q2,q3:n−2,qn−1,qn{q}_{1}, {q}_{2}, {q}_{3:n-2}, {q}_{n-1}, {q}_{n} 的注意力分数按如下所述分别计算:
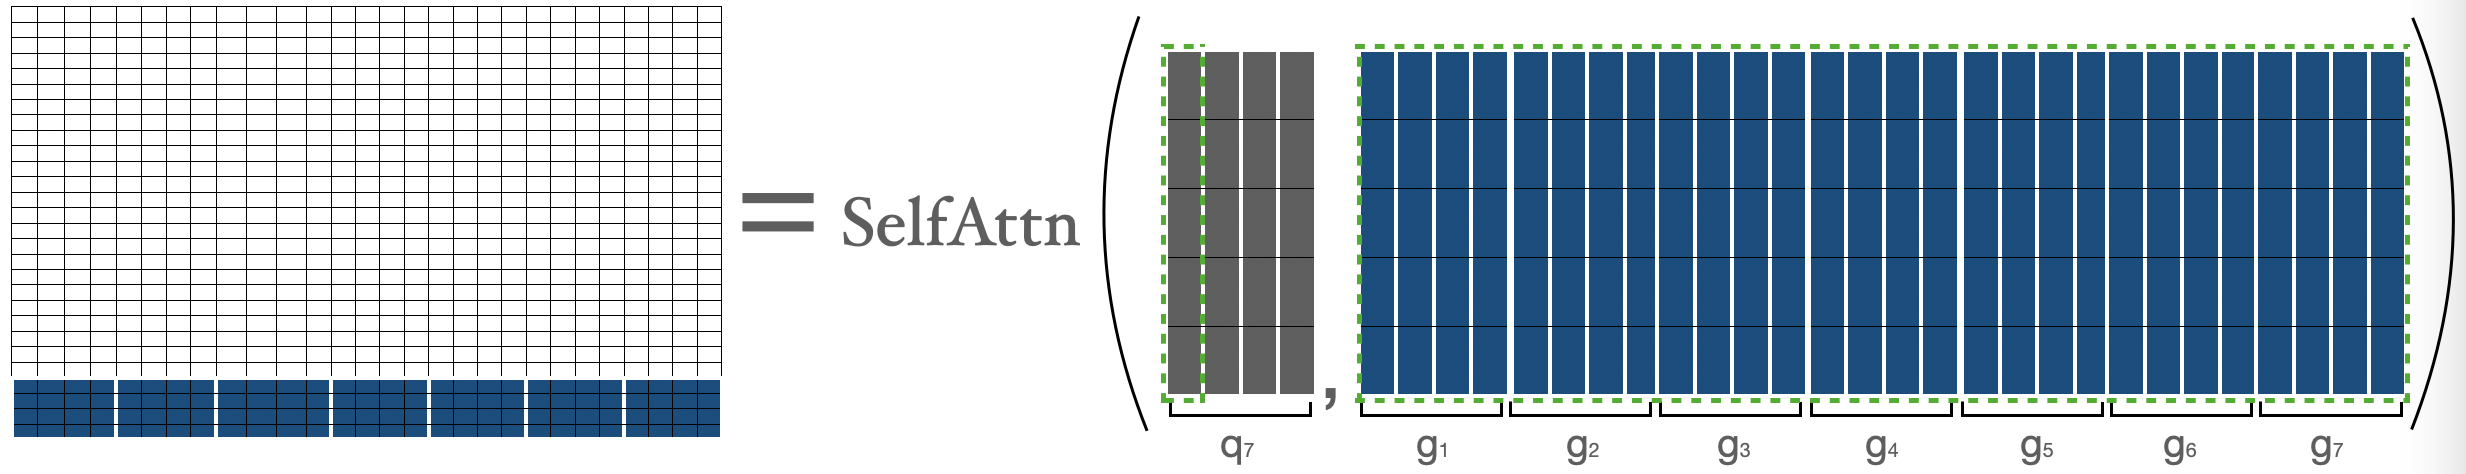
q1\mathbf{q}_{1} 的注意力分数由 a1a_1 表示,其中 a1=Softmax(q1∗KT)a_1=Softmax(q_1 * K^T),它不过是第 1 个块中的所有 token 与序列中所有其他 token 之间的注意力分数。
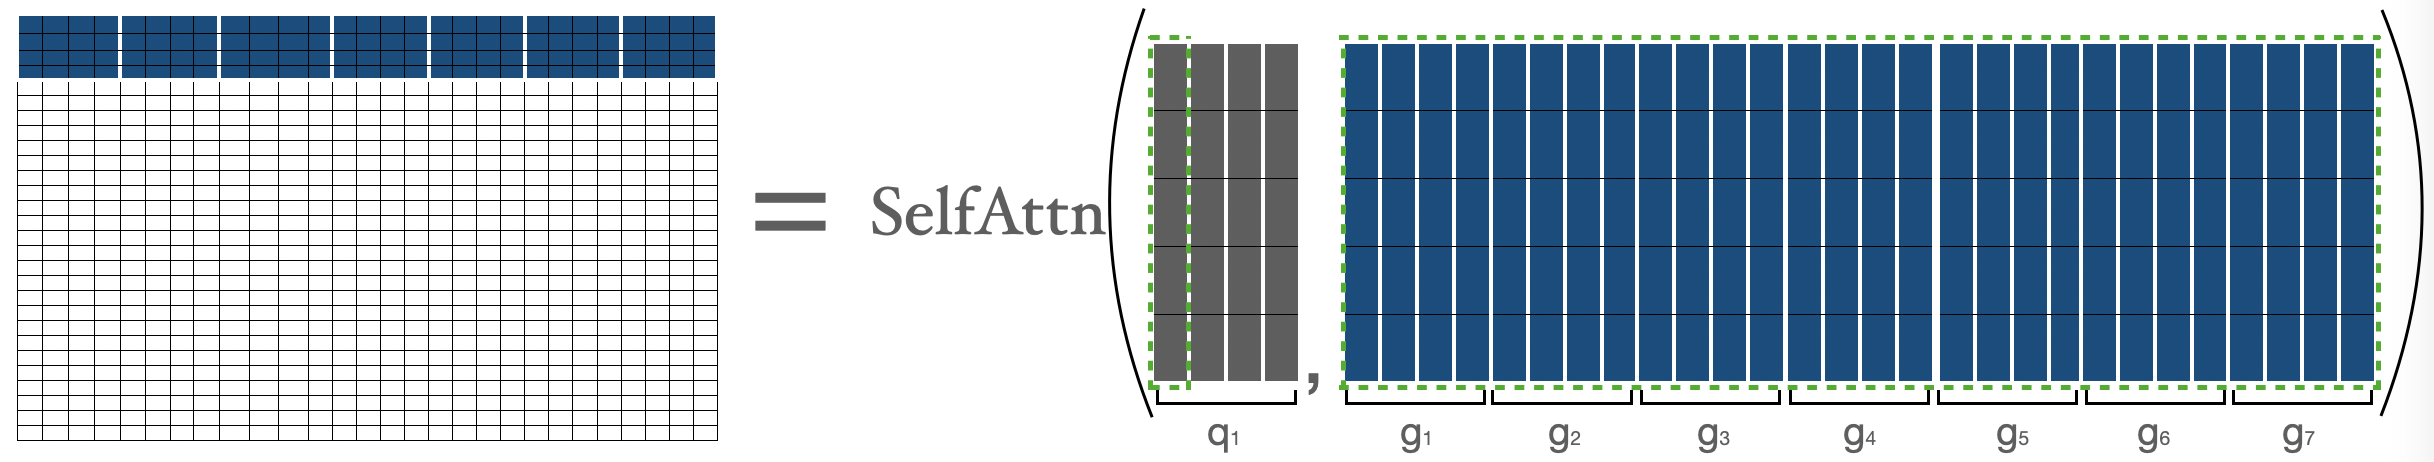 q1q_1 表示第 1 个块,gig_i 表示第 ii 个块。我们只是在 q1q_1 和 gg(即所有 key)之间执行普通的注意力操作。
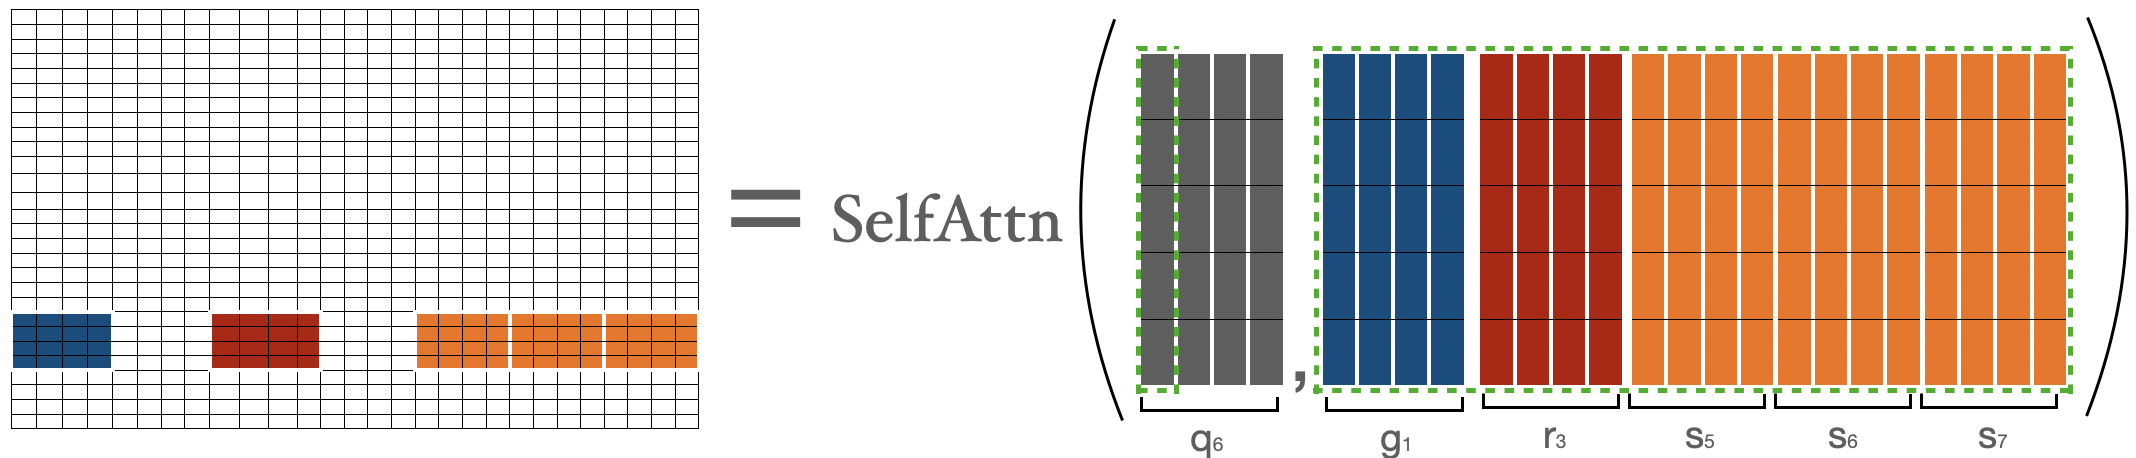
为了计算第二个块中 token 的注意力分数,我们收集前三个块、最后一个块和第五个块。然后我们可以计算 a2=Softmax(q2∗concat(k1,k2,k3,k5,k7)a_2 = Softmax(q_2 * concat(k_1, k_2, k_3, k_5, k_7)。
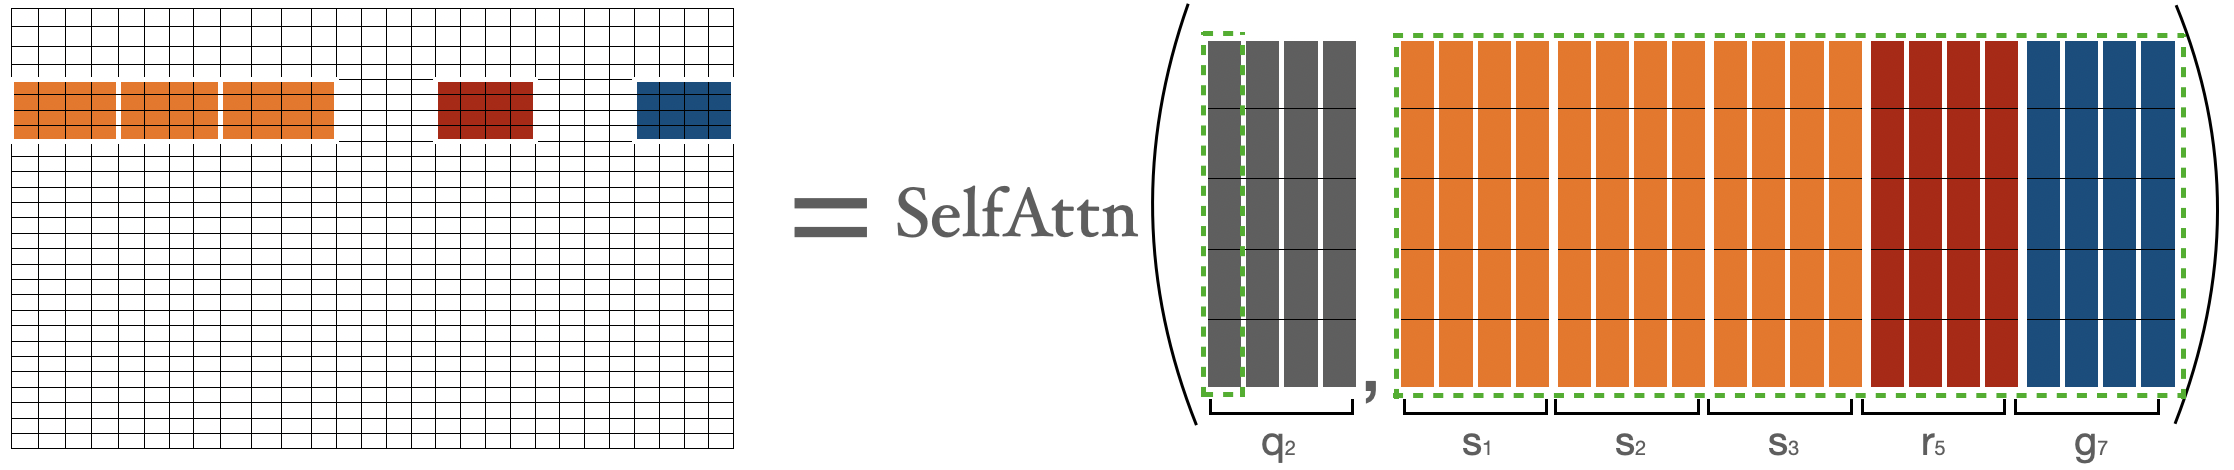
我用 g,r,sg, r, s 来表示 token,只是为了明确表示它们的性质(即表示全局、随机、滑动 token),否则它们只是 kk。
为了计算 q3:n−2{q}_{3:n-2} 的注意力分数,我们将收集全局、滑动、随机键,并将在 q3:n−2{q}_{3:n-2} 和收集到的键上计算正常的注意力操作。注意,滑动键是使用之前在滑动注意力部分讨论的特殊移位技巧收集的。
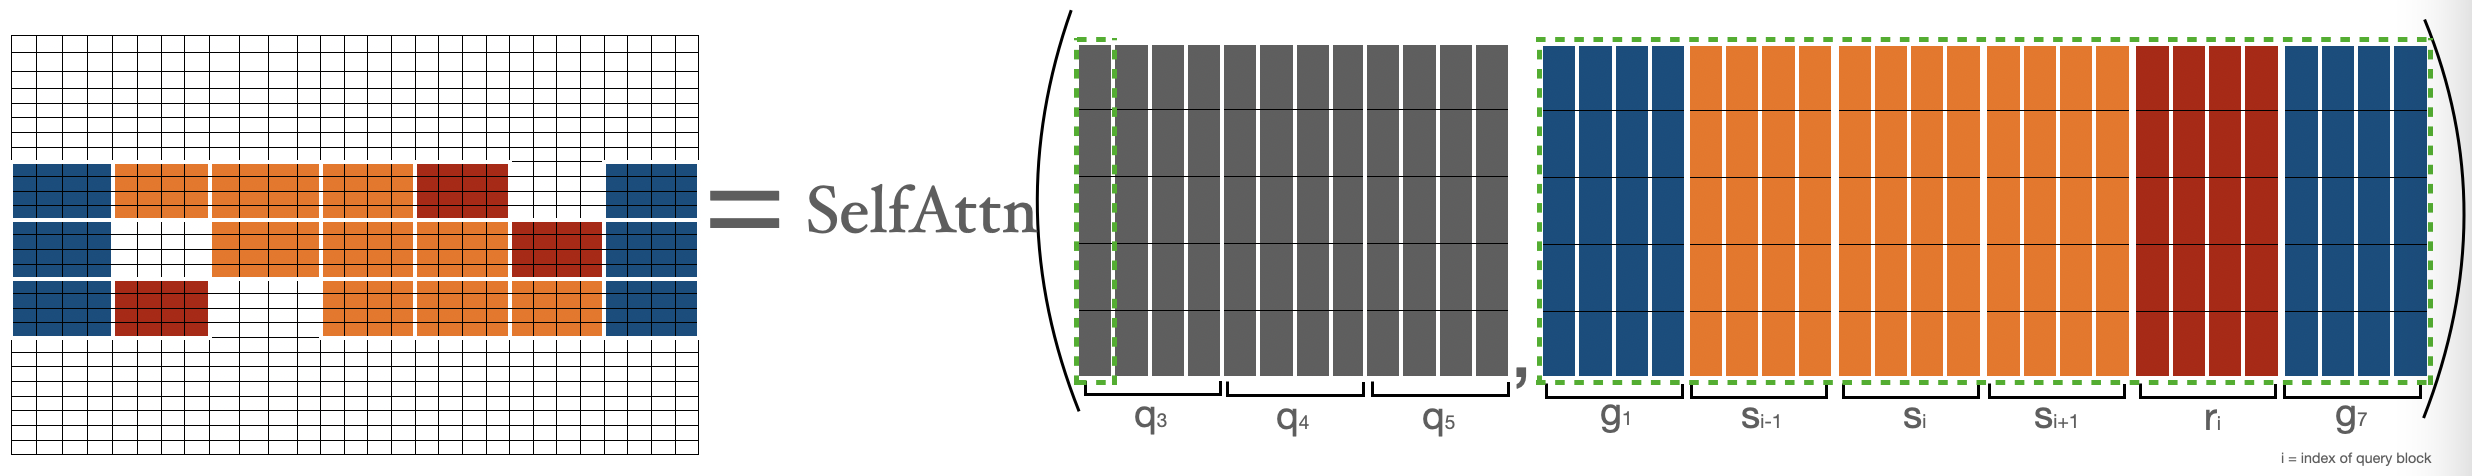
为了计算倒数第二个块中 token(即 qn−1{q}_{n-1})的注意力分数,我们收集第一个块、最后三个块和第三个块。然后我们可以应用公式 an−1=Softmax(qn−1∗concat(k1,k3,k5,k6,k7)){a}_{n-1} = Softmax({q}_{n-1} * concat(k_1, k_3, k_5, k_6, k_7))。这与我们对 q2q_2 所做的非常相似。
qn\mathbf{q}_{n} 的注意力分数由 ana_n 表示,其中 an=Softmax(qn∗KT)a_n=Softmax(q_n * K^T),它不过是最后一个块中所有 token 与序列中所有其他 token 之间的注意力分数。这与我们对 q1 q_1 所做的非常相似。
让我们将上述矩阵组合起来,得到最终的注意力矩阵。这个注意力矩阵可用于获取所有 token 的表示。
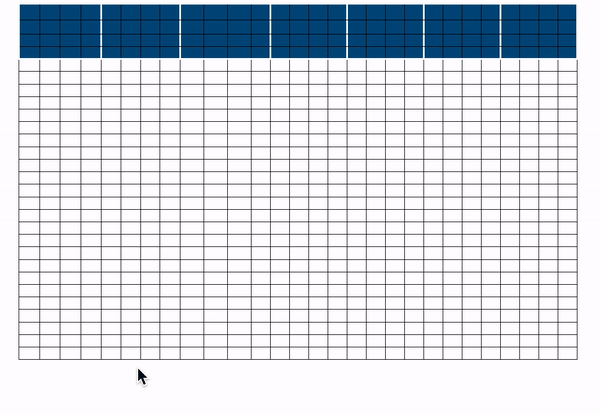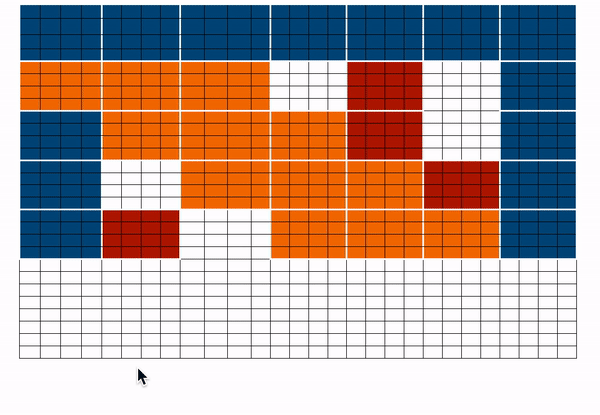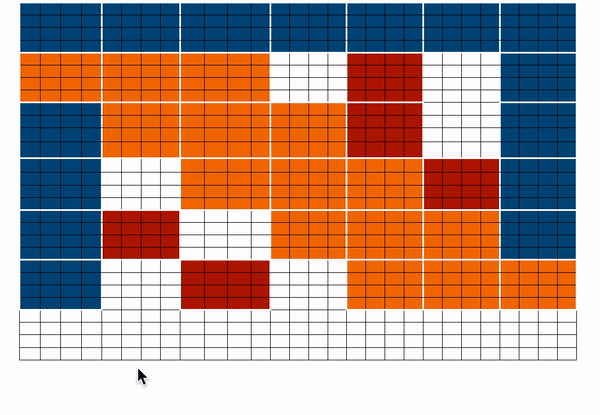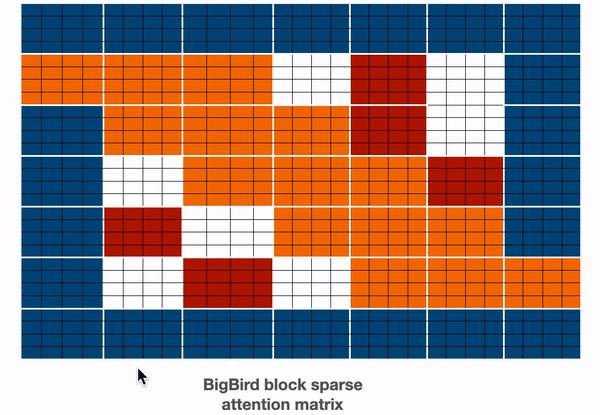
blue -> global blocks、red -> random blocks、orange -> sliding blocks 这个注意力矩阵仅用于说明。在前向传播过程中,我们并不存储 white 个块,而是如上所述直接为每个分离的组件计算加权值矩阵(即每个 token 的表示)。
现在,我们已经涵盖了块稀疏注意力中最困难的部分,即其实现。希望你现在有了更好的背景来理解实际代码。请随意深入研究,并将代码的每个部分与上述组件之一联系起来。
时间与内存复杂度
| 注意力类型 | 序列长度 | 时间与内存复杂度 |
|---|---|---|
original_full |
512 | T |
| 1024 | 4 x T |
|
| 4096 | 64 x T |
|
block_sparse |
1024 | 2 x T |
| 4096 | 8 x T |
BERT 注意力与 BigBird 块稀疏注意力的时间与空间复杂度比较。
如果你想查看计算过程,请展开此片段
BigBird time complexity = O(w x n + r x n + g x n)
BERT time complexity = O(n^2)

Assumptions:
    w = 3 x 64
    r = 3 x 64
    g = 2 x 64

When seqlen = 512
=> **time complexity in BERT = 512^2**

When seqlen = 1024
=> time complexity in BERT = (2 x 512)^2
=> **time complexity in BERT = 4 x 512^2**

=> time complexity in BigBird = (8 x 64) x (2 x 512)
=> **time complexity in BigBird = 2 x 512^2**

When seqlen = 4096
=> time complexity in BERT = (8 x 512)^2
=> **time complexity in BERT = 64 x 512^2**

=> compute in BigBird = (8 x 64) x (8 x 512)
=> compute in BigBird = 8 x (512 x 512)
=> **time complexity in BigBird = 8 x 512^2**
ITC 与 ETC
BigBird 模型可以使用 2 种不同的策略进行训练:ITC 和 ETC。ITC(内部 Transformer 构造)就是我们上面讨论的内容。在 ETC(扩展 Transformer 构造)中,一些额外的 token 被设为全局,以便它们会关注所有 token / 被所有 token 关注。
ITC 需要的计算量更少,因为全局 token 非常少,同时模型可以捕获足够的全局信息(也借助随机注意力)。另一方面,ETC 对于需要大量全局 token 的任务非常有用,例如 `问答,其中整个问题应被上下文全局关注,以便能够正确地将上下文与问题关联起来。
注意:Big Bird 论文表明,在许多 ETC 实验中,随机块的数量被设置为 0。鉴于我们在图部分的讨论,这是合理的。
下表总结了 ITC 与 ETC:
| ITC | ETC | |
|---|---|---|
| 带全局注意力的注意力矩阵 | A=[111111111111111111111111] A = \begin{bmatrix} 1 & 1 & 1 & 1 & 1 & 1 & 1 \\ 1 & & & & & & 1 \\ 1 & & & & & & 1 \\ 1 & & & & & & 1 \\ 1 & & & & & & 1 \\ 1 & & & & & & 1 \\ 1 & 1 & 1 & 1 & 1 & 1 & 1 \end{bmatrix} | B=[11111111111111111111111111111111111111111111111111111111] B = \begin{bmatrix} 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 \\ 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 \\ 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 \\ 1 & 1 & 1 & & & & & & 1 \\ 1 & 1 & 1 & & & & & & 1 \\ 1 & 1 & 1 & & & & & & 1 \\ 1 & 1 & 1 & & & & & & 1 \\ 1 & 1 & 1 & & & & & & 1 \\ 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 \end{bmatrix} |
global_tokens |
2 x block_size |
extra_tokens + 2 x block_size |
random_tokens |
num_random_blocks x block_size |
num_random_blocks x block_size |
sliding_tokens |
3 x block_size |
3 x block_size |
使用 BigBird 与 🤗Transformers
你可以像使用任何其他 🤗 模型一样使用 BigBirdModel。让我们看看下面的代码:
from transformers import BigBirdModel

# loading bigbird from its pretrained checkpoint
model = BigBirdModel.from_pretrained("google/bigbird-roberta-base")
# This will init the model with default configuration i.e. attention_type = "block_sparse" num_random_blocks = 3, block_size = 64.
# But You can freely change these arguments with any checkpoint. These 3 arguments will just change the number of tokens each query token is going to attend.
model = BigBirdModel.from_pretrained("google/bigbird-roberta-base", num_random_blocks=2, block_size=16)

# By setting attention_type to `original_full`, BigBird will be relying on the full attention of n^2 complexity. This way BigBird is 99.9 % similar to BERT.
model = BigBirdModel.from_pretrained("google/bigbird-roberta-base", attention_type="original_full")
在 🤗Hub 中总共有 3 个检查点可用(截至撰写本文时):bigbird-roberta-base、bigbird-roberta-large、bigbird-base-trivia-itc。前两个检查点来自使用 masked_lm loss 预训练 BigBirdForPretraining;而最后一个对应于在 trivia-qa 数据集上微调 BigBirdForQuestionAnswering 后的检查点。
让我们看看你可以编写的最简代码(如果你喜欢使用自己的 PyTorch 训练器),以使用 🤗 的 BigBird 模型微调你的任务。
# let's consider our task to be question-answering as an example

from transformers import BigBirdForQuestionAnswering, BigBirdTokenizer
import torch

device = torch.device("cpu")
if torch.cuda.is_available():
    device = torch.device("cuda")

# lets initialize bigbird model from pretrained weights with randomly initialized head on its top
model = BigBirdForQuestionAnswering.from_pretrained("google/bigbird-roberta-base", block_size=64, num_random_blocks=3)
tokenizer = BigBirdTokenizer.from_pretrained("google/bigbird-roberta-base")
model.to(device)

dataset = "torch.utils.data.DataLoader object"
optimizer = "torch.optim object"
epochs = ...

# very minimal training loop
for e in range(epochs):
    for batch in dataset:
        model.train()
        batch = {k: batch[k].to(device) for k in batch}

        # forward pass
        output = model(**batch)

        # back-propogation
        output["loss"].backward()
        optimizer.step()
        optimizer.zero_grad()

# let's save final weights in a local directory
model.save_pretrained("<YOUR-WEIGHTS-DIR>")

# let's push our weights to 🤗Hub
from huggingface_hub import ModelHubMixin
ModelHubMixin.push_to_hub("<YOUR-WEIGHTS-DIR>", model_id="<YOUR-FINETUNED-ID>")

# using finetuned model for inference
question = ["How are you doing?", "How is life going?"]
context = ["<some big context having ans-1>", "<some big context having ans-2>"]
batch = tokenizer(question, context, return_tensors="pt")
batch = {k: batch[k].to(device) for k in batch}

model = BigBirdForQuestionAnswering.from_pretrained("<YOUR-FINETUNED-ID>")
model.to(device)
with torch.no_grad():
    start_logits, end_logits = model(**batch).to_tuple()
    # now decode start_logits, end_logits with what ever strategy you want.

# Note:
# This was very minimal code (in case you want to use raw PyTorch) just for showing how BigBird can be used very easily
# I would suggest using 🤗Trainer to have access for a lot of features
在使用 big bird 时,牢记以下几点很重要:
- 序列长度必须是块大小的倍数,即
seqlen % block_size = 0。你无需担心,因为如果批次序列长度不是block_size的倍数,🤗Transformers 会自动<pad>(到大于序列长度的最小块大小倍数)。 - 目前,HuggingFace 版本不支持 ETC,因此只有第 1 个和最后一个块是全局的。
- 当前实现不支持
num_random_blocks = 0。 - 作者建议当序列长度 < 1024 时设置
attention_type = "original_full"。 - 必须满足:
seq_length > global_token + random_tokens + sliding_tokens + buffer_tokens,其中global_tokens = 2 x block_size、sliding_tokens = 3 x block_size、random_tokens = num_random_blocks x block_size&buffer_tokens = num_random_blocks x block_size。如果你未能做到这一点,🤗Transformers 会自动将attention_type切换为original_full并发出警告。 - 当使用 big bird 作为解码器(或使用
BigBirdForCasualLM)时,attention_type应为original_full。但你无需担心,如果你忘记这样做,🤗Transformers 会自动将attention_type切换为original_full。
接下来是什么?
@patrickvonplaten 制作了一个非常酷的 notebook,介绍如何在 trivia-qa 数据集上评估 BigBirdForQuestionAnswering。请随意使用该 notebook 来体验 BigBird。
你很快会在库中找到用于长文档摘要的 BigBird Pegasus 类模型💥。
结束语
来源:Hugging Face:Blog(RSS) · huggingface.co