Hugging Face Trainer 实测 DeepSpeed 与 FairScale 的 ZeRO 加速与显存优化
Fit More and Train Faster With ZeRO via DeepSpeed and FairScale
Hugging Face fellow Stas Bekman 介绍 transformers v4.2.0 起通过 --deepspeed 和 --sharded_ddp 参数实验性支持 DeepSpeed 与 FairScale 的 ZeRO 特性。
作者用同一套 t5 基准实测六种配置,读者可以直接对照表格选择适合自己 GPU 数量的 ZeRO 方案。
Hugging Face 研究员 Stas Bekman 撰写的客座博客文章
由于近期机器学习模型的增长速度远超新发布显卡所增加的 GPU 内存量,许多用户无法训练,甚至无法将一些庞大的模型加载到他们的硬件上。虽然目前正在努力将其中一些庞大的模型蒸馏为更易于管理的规模——但这项工作并未足够快地产生足够小的模型。
2019 年秋季,Samyam Rajbhandari、Jeff Rasley、Olatunji Ruwase 和 Yuxiong He 发表了一篇论文: ZeRO:面向训练万亿参数模型的内存优化,其中包含大量巧妙的新想法,关于如何让硬件发挥出远超以往想象的能力。不久之后,DeepSpeed 发布,向世界提供了该论文中大部分想法的开源实现(少数想法仍在开发中),与此同时,Facebook 的一个团队发布了 FairScale,它也实现了 ZeRO 论文中的一些核心思想。
如果你使用 Hugging Face Trainer,从 transformers v4.2.0 开始,你就获得了对 DeepSpeed 和 FairScale 的 ZeRO 功能的实验性支持。新的 --sharded_ddp 和 --deepspeed 命令行 Trainer 参数分别提供了 FairScale 和 DeepSpeed 集成。这里是完整文档。
这篇博客文章将描述无论你只有一块 GPU 还是拥有一整堆 GPU,你都能如何从 ZeRO 中受益。
多 GPU 设置带来的巨大加速
让我们使用一个 t5-large 模型和 finetune_trainer.py 脚本做一个小的翻译任务微调实验,你可以在 transformers GitHub 仓库的 examples/seq2seq 下找到该脚本。
我们有 2 块 24GB(Titan RTX)GPU 用于测试。
这只是一个概念验证基准测试,所以肯定还有进一步改进的空间,因此我们将在一个小样本上进行基准测试,使用 2000 个训练项目和 500 个评估项目来进行比较。评估默认执行大小为 4 的束搜索,因此在相同样本数量下比训练更慢,这就是为什么在这些测试中使用了少 4 倍的评估项目。
以下是我们基线的主要命令行参数:
export BS=16
python -m torch.distributed.launch --nproc_per_node=2 ./finetune_trainer.py \
--model_name_or_path t5-large --n_train 2000 --n_val 500 \
--per_device_eval_batch_size $BS --per_device_train_batch_size $BS \
--task translation_en_to_ro [...]
我们只使用 DistributedDataParallel(DDP),没有其他任何东西来提升基线的性能。在遇到内存不足(OOM)错误之前,我能够容纳的批大小(BS)为 16。
请注意,为了简单起见并使其更易于理解,我只展示了对此演示重要的命令行参数。你可以在这篇文章中找到完整的命令行。
接下来,我们将每次添加以下其中一项来重新运行基准测试:
--fp16--sharded_ddp(fairscale)--sharded_ddp --fp16(fairscale)--deepspeed不使用 CPU 卸载--deepspeed使用 CPU 卸载
由于这里的关键优化是每种技术都能更高效地部署 GPU 内存,我们将尝试不断增加批大小,并期望训练和评估能更快完成(同时保持指标稳定甚至有所改善,但这里我们不会关注这些)。
请记住,训练和评估阶段彼此非常不同,因为在训练期间模型权重会被修改,梯度会被计算,优化器状态会被存储。在评估期间,这些都不会发生,但在这个特定的翻译任务中,模型会尝试搜索最佳假设,因此它实际上必须进行多次运行才能满意。这就是为什么它不快,尤其是当模型很大时。
让我们看看这六次测试运行的结果:
| 方法 | 最大 BS | 训练时间 | 评估时间 |
|---|---|---|---|
| 基线 | 16 | 30.9458 | 56.3310 |
| fp16 | 20 | 21.4943 | 53.4675 |
| sharded_ddp | 30 | 25.9085 | 47.5589 |
| sharded_ddp+fp16 | 30 | 17.3838 | 45.6593 |
| deepspeed 无 cpu 卸载 | 40 | 10.4007 | 34.9289 |
| deepspeed 有 cpu 卸载 | 50 | 20.9706 | 32.1409 |
很容易看出,FairScale 和 DeepSpeed 在总训练和评估时间以及批量大小方面都比基线有巨大改进。截至本文撰写时,DeepSpeed 实现了更多魔法,似乎是短期赢家,但 Fairscale 更容易部署。对于 DeepSpeed,你需要编写一个简单的配置文件并更改命令行的启动器,而使用 Fairscale,你只需要添加 --sharded_ddp 命令行参数,因此你可能想先尝试它,因为它是最容易实现的目标。
遵循 80:20 法则,我只在这些基准测试上花了几个小时,我没有试图通过优化命令行参数和配置来榨取每一 MB 和每一秒,因为从简单的表格中已经很明显地看出你接下来想尝试什么。当你面对一个将运行数小时甚至数天的真实项目时,一定要花更多时间确保你使用最优超参数,以更快、最低成本地完成工作。
如果你想自己尝试这个基准测试,或者想了解更多关于运行它所用的硬件和软件的细节,请参考这篇文章。
将巨大模型装入单个 GPU
虽然 Fairscale 只在多 GPU 时给我们带来提升,但 DeepSpeed 甚至为我们这些只有单个 GPU 的人也带来了礼物。
让我们尝试不可能的事情——在 24GB RTX-3090 卡上训练 t5-3b。
首先让我们尝试使用普通的单 GPU 设置来微调巨大的 t5-3b:
export BS=1
CUDA_VISIBLE_DEVICES=0 ./finetune_trainer.py \
--model_name_or_path t5-3b --n_train 60 --n_val 10 \
--per_device_eval_batch_size $BS --per_device_train_batch_size $BS \
--task translation_en_to_ro --fp16 [...]
不行,即使 BS=1 我们也会得到:
RuntimeError: CUDA out of memory. Tried to allocate 64.00 MiB (GPU 0; 23.70 GiB total capacity;
21.37 GiB already allocated; 45.69 MiB free; 22.05 GiB reserved in total by PyTorch)
注意,和之前一样,我只展示重要部分,完整的命令行参数可以在这里找到。
现在将你的 transformers 更新到 v4.2.0 或更高版本,然后安装 DeepSpeed:
pip install deepspeed
让我们再试一次,这次在命令行中添加 DeepSpeed:
export BS=20
CUDA_VISIBLE_DEVICES=0 deepspeed --num_gpus=1 ./finetune_trainer.py \
--model_name_or_path t5-3b --n_train 60 --n_val 10 \
--per_device_eval_batch_size $BS --per_device_train_batch_size $BS \
--task translation_en_to_ro --fp16 --deepspeed ds_config_1gpu.json [...]
瞧!我们得到了一个批量大小为 20 的训练,运行良好。我可能还能推得更高。程序在 BS=30 时因 OOM 失败。
以下是相关结果:
2021-01-12 19:06:31 | INFO | __main__ |   train_n_objs = 60
2021-01-12 19:06:31 | INFO | __main__ |   train_runtime = 8.8511
2021-01-12 19:06:35 | INFO | __main__ |   val_n_objs = 10
2021-01-12 19:06:35 | INFO | __main__ |   val_runtime = 3.5329
我们无法将这些与基线进行比较,因为基线甚至无法启动,并立即因 OOM 失败。
简直太神奇了!
我只使用了一个很小的样本,因为我主要感兴趣的是能够用这个通常无法装入 24GB GPU 的巨大模型进行训练和评估。
如果你想自己尝试这个基准测试,或者想了解更多关于运行它所用的硬件和软件的细节,请参考这篇文章。
ZeRO 背后的魔法
由于 transformers 只是集成了这些出色的解决方案,而不是发明了它们,我将分享一些资源,你可以自己发现所有细节。但这里有一些快速见解,可能有助于理解 ZeRO 如何实现这些惊人的壮举。
ZeRO 的关键特性是将分布式数据存储添加到我们非常熟悉的数据并行训练概念中。
每个 GPU 上的计算与数据并行训练完全相同,但参数、梯度和优化器状态以分布式/分区方式存储在所有 GPU 上,仅在需要时获取。
下图来自这篇 博客文章,展示了其工作原理:
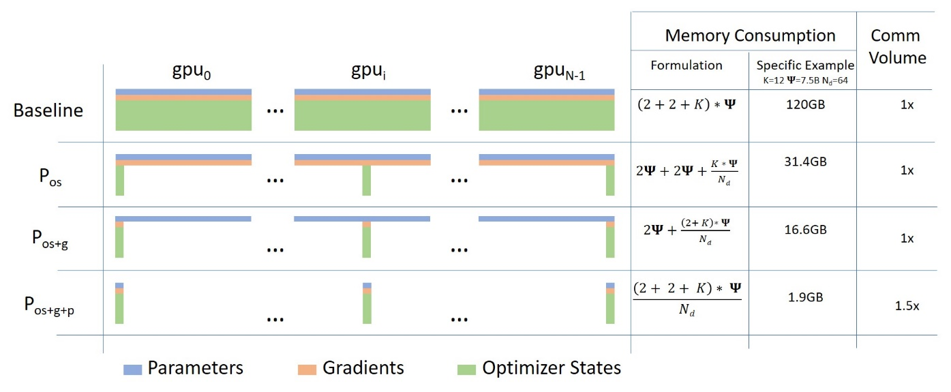
ZeRO 的巧妙之处在于将所有 GPU 上的参数、梯度和优化器状态均等分区,并给每个 GPU 只分配一个分区(也称为分片)。这导致 GPU 之间的数据存储零重叠。运行时,每个 GPU 通过请求参与的 GPU 发送其缺少的信息,动态构建每一层的数据。
这个想法可能难以理解,你可以在这里找到我的解释尝试。
截至撰写本文时,FairScale 和 DeepSpeed 仅对优化器状态和梯度执行分区(分片)。模型参数分片据称即将在 DeepSpeed 和 FairScale 中推出。
另一个强大的功能是 ZeRO-Offload(论文)。此功能将一些处理和内存需求卸载到主机的 CPU,从而允许更多内容装入 GPU。你在 24GB GPU 上成功运行 t5-3b 中看到了其巨大影响。
许多人在 pytorch 论坛上抱怨的另一个问题是 GPU 内存碎片化。人们经常会遇到看起来像这样的 OOM 错误:
RuntimeError: CUDA out of memory. Tried to allocate 1.48 GiB (GPU 0; 23.65 GiB total capacity;
16.22 GiB already allocated; 111.12 MiB free; 22.52 GiB reserved in total by PyTorch)
程序想要分配约 1.5GB,而 GPU 仍有约 6-7GB 未使用内存,但它报告只有约 100MB 的连续空闲内存,并以 OOM 错误失败。这是因为不同大小的块被反复分配和释放,随着时间的推移,空洞被创建,导致内存碎片化,即有很多未使用内存但没有所需大小的连续块。在上面的例子中,程序可能可以分配 100MB 的连续内存,但显然无法获得 1.5GB 的单个块。
DeepSpeed 通过自行管理 GPU 内存来解决这个问题,确保长期内存分配不与短期分配混合,从而大大减少碎片化。虽然论文没有详细说明,但源代码可用,因此可以了解 DeepSpeed 如何实现这一点。
由于 ZeRO 代表零冗余优化器,很容易看出它名副其实。
未来
除了预计即将在 DeepSpeed 中支持模型参数分片外,它已经发布了我们尚未探索的新功能。这些包括 DeepSpeed Sparse Attention 和 1-bit Adam,它们应该减少内存使用并大幅降低 GPU 间通信开销,从而实现更快的训练并支持更大的模型。
我相信我们也会看到 FairScale 团队的新礼物。我认为他们也在开发 ZeRO 第 3 阶段。
更令人兴奋的是,ZeRO 正在被集成到 pytorch 中。
部署
如果你觉得这篇博客文章中分享的结果很吸引人,请前往这里了解如何将 DeepSpeed 和 FairScale 与 transformers Trainer 一起使用的详细信息。
当然,你可以根据自己的训练器修改以集成 DeepSpeed 和 FairScale,基于每个项目的说明,或者你可以“作弊”看看我们在 transformers Trainer 中是如何做的。如果你选择后者,为了在 grep 中找到方向,请查看 deepspeed 和/或 sharded_ddp 的源代码。
好消息是 ZeRO 不需要修改模型。唯一需要修改的是训练代码。
问题
如果你在集成这两个项目中的任何一个时遇到任何问题,请在 transformers 中提交 Issue。
但如果你在 DeepSpeed 和 FairScale 的安装、配置和部署方面遇到问题——你需要咨询各自领域的专家,因此,请改用 DeepSpeed Issue 或 FairScale Issue。
资源
虽然你并不真的需要了解这些项目的工作原理,只需通过 transformers Trainer 部署它们即可,但如果你想弄清楚其中的缘由和方法,请参考以下资源。
论文:ZeRO: Memory Optimizations Toward Training Trillion Parameter Models。这篇论文非常有趣,但非常简洁。
这里有一个很好的视频讨论,配有可视化内容
论文:ZeRO-Offload: Democratizing Billion-Scale Model Training。刚刚发表——这篇深入介绍了 ZeRO Offload 功能的细节。
DeepSpeed 配置和教程
除了论文之外,我强烈推荐阅读以下带有图表的详细博客文章:
DeepSpeed GitHub 上的示例
致谢
在将这些项目集成到 transformers 的过程中,FairScale 和 DeepSpeed 开发团队给予我们的支持水平之高,令我们十分惊讶。
特别感谢:
- Benjamin Lefaudeux @blefaudeux
- Mandeep Baines @msbaines
来自 FairScale 团队,以及:
来自 DeepSpeed 团队,感谢你们慷慨而贴心的支持,以及对我们所遇问题的迅速解决。
以及 HuggingFace 为基准测试运行提供硬件访问。
来源:Hugging Face:Blog(RSS) · huggingface.co