Hugging Face 教程:用 Transformers 和 Tokenizers 从零训练一个世界语语言模型 EsperBERTo
How to train a new language model from scratch using Transformers and Tokenizers
Hugging Face 发布教程,演示用 transformers 和 tokenizers 从零训练 84M 参数的 RoBERTa 风格模型 EsperBERTo,并微调到世界语词性标注任务。
Hugging Face 官方教程完整走通从语料、分词器到预训练和下游微调的全流程,步骤和代码可直接复用到其他低资源语言。

在过去几个月中,我们对 transformers 和 tokenizers 库进行了多项改进,目标是让从头训练一个新的语言模型变得前所未有的简单。
在这篇文章中,我们将演示如何在世界语上训练一个“小型”模型(84 M 参数 = 6 层,768 隐藏大小,12 个注意力头)——这与 DistilBERT 的层数和头数相同。然后,我们将在词性标注的下游任务上对该模型进行微调。
世界语是一种人造语言,其目标是易于学习。我们选择它进行此演示有以下几个原因:
- 它是一种资源相对较少的语言(尽管有约 200 万人使用),因此这个演示比再训练一个英语模型更有趣 😁
- 它的语法高度规则(例如,所有普通名词以 -o 结尾,所有形容词以 -a 结尾),因此即使在小数据集上,我们也应该能得到有趣的语言学结果。
- 最后,该语言的根本目标是拉近人们的距离(促进世界和平与国际理解),可以说这与 NLP 社区的目标是一致的 💚
注意:你不需要懂世界语就能理解这篇文章,但如果你确实想学习它,Duolingo 有一门不错的课程,有 28 万活跃学习者。
我们的模型将被称为……等等……EsperBERTo 😂

1. 寻找数据集
首先,让我们找到世界语的文本语料库。这里我们将使用 INRIA 的 OSCAR 语料库中的世界语部分。 OSCAR 是一个庞大的多语言语料库,通过对网络 Common Crawl 转储进行语言分类和过滤获得。

数据集中的世界语部分只有 299M,因此我们将与 Leipzig Corpora Collection 的世界语子语料库连接,该子语料库包含来自新闻、文学和维基百科等多种来源的文本。
最终训练语料库大小为 3 GB,这仍然很小——对于你的模型,你能获取用于预训练的数据越多,结果就越好。
2. 训练分词器
我们选择训练一个字节级字节对编码分词器(与 GPT-2 相同),并使用与 RoBERTa 相同的特殊标记。我们任意将其大小设为 52,000。
我们推荐训练字节级 BPE(而不是像 BERT 那样的 WordPiece 分词器),因为它将从单字节字母表开始构建词汇表,所以所有单词都可以分解为标记(不再有 <unk> 标记!)。
#! pip install tokenizers

from pathlib import Path

from tokenizers import ByteLevelBPETokenizer

paths = [str(x) for x in Path("./eo_data/").glob("**/*.txt")]

# Initialize a tokenizer
tokenizer = ByteLevelBPETokenizer()

# Customize training
tokenizer.train(files=paths, vocab_size=52_000, min_frequency=2, special_tokens=[
    "<s>",
    "<pad>",
    "</s>",
    "<unk>",
    "<mask>",
])

# Save files to disk
tokenizer.save_model(".", "esperberto")
以下是输出的略微加速捕获:
 在我们的数据集上,训练大约花了 ~5 分钟。
🔥🔥 哇,真快!⚡️🔥
我们现在有了一个 vocab.json,它是按频率排序的最频繁标记列表,以及一个 merges.txt 合并列表。
{
    "<s>": 0,
    "<pad>": 1,
    "</s>": 2,
    "<unk>": 3,
    "<mask>": 4,
    "!": 5,
    "\"": 6,
    "#": 7,
    "$": 8,
    "%": 9,
    "&": 10,
    "'": 11,
    "(": 12,
    ")": 13,
    # ...
}

# merges.txt
l a
Ġ k
o n
Ġ la
t a
Ġ e
Ġ d
Ġ p
# ...
很棒的是,我们的分词器针对世界语进行了优化。与为英语训练的通用分词器相比,更多的母语单词由单个未拆分的标记表示。变音符号,即世界语中使用的重音字符——ĉ、ĝ、ĥ、ĵ、ŝ 和 ŭ——被原生编码。我们还以更高效的方式表示序列。在这个语料库上,编码序列的平均长度比使用预训练的 GPT-2 分词器时小约 30%。
以下是如何在 tokenizers 中使用它,包括处理 RoBERTa 特殊标记——当然,你也可以直接从 transformers 中使用它。
from tokenizers.implementations import ByteLevelBPETokenizer
from tokenizers.processors import BertProcessing


tokenizer = ByteLevelBPETokenizer(
    "./models/EsperBERTo-small/vocab.json",
    "./models/EsperBERTo-small/merges.txt",
)
tokenizer._tokenizer.post_processor = BertProcessing(
    ("</s>", tokenizer.token_to_id("</s>")),
    ("<s>", tokenizer.token_to_id("<s>")),
)
tokenizer.enable_truncation(max_length=512)

print(
    tokenizer.encode("Mi estas Julien.")
)
# Encoding(num_tokens=7, ...)
# tokens: ['<s>', 'Mi', 'Ġestas', 'ĠJuli', 'en', '.', '</s>']
3. 从头开始训练语言模型
更新:相关的 Colab notebook 直接使用我们新的 Trainer,而不是通过脚本。请随意选择你最喜欢的方法。
我们现在将使用来自 transformers 的 run_language_modeling.py 脚本来训练我们的语言模型(该脚本最近从 run_lm_finetuning.py 重命名而来,因为它现在更无缝地支持从头开始训练)。只需记住将 --model_name_or_path 保留为 None,以选择从头开始训练还是从现有模型或检查点训练。
我们将训练一个类似 RoBERTa 的模型,它类似于 BERT,但有一些改动(查看文档了解更多细节)。
由于该模型类似 BERT,我们将在掩码语言建模任务上训练它,即预测如何填充我们在数据集中随机掩码的任意 token。这由示例脚本处理。
我们只需要做两件事:
- implement a simple subclass of
Datasetthat loads data from our text files- 根据你的用例,如果提供的示例之一(
TextDataset和LineByLineTextDataset)可用,你甚至可能不需要编写自己的 Dataset 子类——但根据你的语料库的样子,你可能想要添加许多自定义调整。
- 根据你的用例,如果提供的示例之一(
- 选择并尝试不同的超参数集。
这是我们 EsperantoDataset 的简单版本。
from torch.utils.data import Dataset

class EsperantoDataset(Dataset):
    def __init__(self, evaluate: bool = False):
        tokenizer = ByteLevelBPETokenizer(
            "./models/EsperBERTo-small/vocab.json",
            "./models/EsperBERTo-small/merges.txt",
        )
        tokenizer._tokenizer.post_processor = BertProcessing(
            ("</s>", tokenizer.token_to_id("</s>")),
            ("<s>", tokenizer.token_to_id("<s>")),
        )
        tokenizer.enable_truncation(max_length=512)
        # or use the RobertaTokenizer from `transformers` directly.

        self.examples = []

        src_files = Path("./data/").glob("*-eval.txt") if evaluate else Path("./data/").glob("*-train.txt")
        for src_file in src_files:
            print("🔥", src_file)
            lines = src_file.read_text(encoding="utf-8").splitlines()
            self.examples += [x.ids for x in tokenizer.encode_batch(lines)]

    def __len__(self):
        return len(self.examples)

    def __getitem__(self, i):
        # We’ll pad at the batch level.
        return torch.tensor(self.examples[i])
如果你的数据集非常大,你可以选择动态加载和分词示例,而不是作为预处理步骤。
以下是我们传递给脚本的一组特定的超参数和参数:
    --output_dir ./models/EsperBERTo-small-v1
    --model_type roberta
    --mlm
    --config_name ./models/EsperBERTo-small
    --tokenizer_name ./models/EsperBERTo-small
    --do_train
    --do_eval
    --learning_rate 1e-4
    --num_train_epochs 5
    --save_total_limit 2
    --save_steps 2000
    --per_gpu_train_batch_size 16
    --evaluate_during_training
    --seed 42
像往常一样,选择你的 GPU 能容纳的最大批量大小。
🔥🔥🔥 让我们开始训练!! 🔥🔥🔥
在这里你可以查看我们针对一组特定超参数的 Tensorboard:

我们的示例脚本默认以 Tensorboard 格式记录日志,位于
runs/下。然后要查看你的面板,只需运行tensorboard dev upload --logdir runs——这将设置 tensorboard.dev,这是一个由 Google 管理的托管版本,让你可以与任何人分享你的机器学习实验。
4. 检查 LM 是否真的训练好了
除了观察训练和评估损失下降之外,检查我们的语言模型是否学到了任何有趣内容的最简单方法是通过 FillMaskPipeline。
Pipelines 是 tokenizer 和模型的简单封装,而 'fill-mask' 这个 pipeline 可以让你输入一个包含掩码 token 的序列(这里,<mask>),并返回最可能的填充序列列表及其概率。
from transformers import pipeline

fill_mask = pipeline(
    "fill-mask",
    model="./models/EsperBERTo-small",
    tokenizer="./models/EsperBERTo-small"
)

# The sun <mask>.
# =>

result = fill_mask("La suno <mask>.")

# {'score': 0.2526160776615143, 'sequence': '<s> La suno brilis.</s>', 'token': 10820}
# {'score': 0.0999930202960968, 'sequence': '<s> La suno lumis.</s>', 'token': 23833}
# {'score': 0.04382849484682083, 'sequence': '<s> La suno brilas.</s>', 'token': 15006}
# {'score': 0.026011141017079353, 'sequence': '<s> La suno falas.</s>', 'token': 7392}
# {'score': 0.016859788447618484, 'sequence': '<s> La suno pasis.</s>', 'token': 4552}
好的,简单的语法/文法有效。让我们尝试一个稍微更有趣的提示:
fill_mask("Jen la komenco de bela <mask>.")

# This is the beginning of a beautiful <mask>.
# =>

# {
#     'score':0.06502299010753632
#     'sequence':'<s> Jen la komenco de bela vivo.</s>'
#     'token':1099
# }
# {
#     'score':0.0421181358397007
#     'sequence':'<s> Jen la komenco de bela vespero.</s>'
#     'token':5100
# }
# {
#     'score':0.024884626269340515
#     'sequence':'<s> Jen la komenco de bela laboro.</s>'
#     'token':1570
# }
# {
#     'score':0.02324388362467289
#     'sequence':'<s> Jen la komenco de bela tago.</s>'
#     'token':1688
# }
# {
#     'score':0.020378097891807556
#     'sequence':'<s> Jen la komenco de bela festo.</s>'
#     'token':4580
# }
“Jen la komenco de bela tago”,确实如此!
对于更复杂的提示,你可以探究你的语言模型是否捕捉到了更多的语义知识,甚至某种(统计)常识推理。
5. 在下游任务上微调你的 LM
我们现在可以在词性标注的下游任务上微调我们新的世界语语言模型。
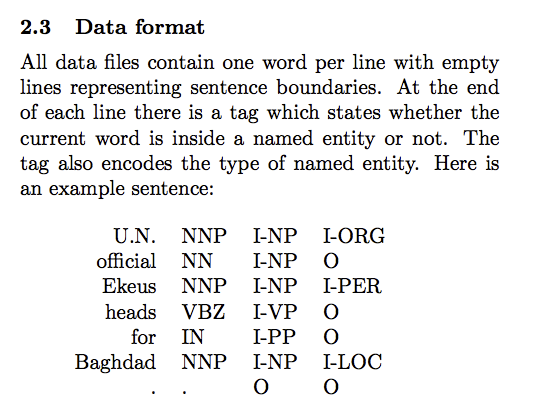
如前所述,世界语是一种高度规则的语言,词尾通常决定语法词性。使用以 CoNLL-2003 格式标注的世界语词性标注数据集(见下面的示例),我们可以使用来自 transformers 的 run_ner.py 脚本。
词性标注和 NER 一样是 token 分类任务,所以我们可以直接使用完全相同的脚本。
同样,这里是用于此微调的托管 Tensorboard。我们使用每个 GPU 批量大小为 64 训练 3 个 epoch。
训练和评估损失收敛到很小的残差,因为任务相当简单(语言是正则的)——不过能够端到端地训练它仍然很有趣 😃。
这次,让我们使用一个 TokenClassificationPipeline:
from transformers import TokenClassificationPipeline, pipeline


MODEL_PATH = "./models/EsperBERTo-small-pos/"

nlp = pipeline(
    "ner",
    model=MODEL_PATH,
    tokenizer=MODEL_PATH,
)
# or instantiate a TokenClassificationPipeline directly.

nlp("Mi estas viro kej estas tago varma.")

# {'entity': 'PRON', 'score': 0.9979867339134216, 'word': ' Mi'}
# {'entity': 'VERB', 'score': 0.9683094620704651, 'word': ' estas'}
# {'entity': 'VERB', 'score': 0.9797462821006775, 'word': ' estas'}
# {'entity': 'NOUN', 'score': 0.8509314060211182, 'word': ' tago'}
# {'entity': 'ADJ', 'score': 0.9996201395988464, 'word': ' varma'}
看起来成功了!🔥
对于更具挑战性的 NER 数据集,@stefan-it 建议我们使用 WikiANN 的银标准数据集进行训练
6. 分享你的模型 🎉
最后,当你有一个好的模型时,请考虑与社区分享它:
- 使用 CLI 上传你的模型:
transformers-cli upload - write a README.md model card and add it to the repository under
model_cards/. Your model card should ideally include:- 模型描述,
- 训练参数(数据集、预处理、超参数),
- 评估结果,
- 预期用途和限制
- 以及其他任何有用的信息!🤓
太棒了!
➡️ 你的模型在 https://huggingface.co/models 上有一个页面,每个人都可以使用 AutoModel.from_pretrained("username/model_name") 加载它。

如果你想查看不同语言的模型,请查看 https://huggingface.co/models

谢谢!
来源:Hugging Face:Blog(RSS) · huggingface.co