Meta 发布 Llama 2,Hugging Face 上线 12 个模型并提供完整生态支持
Llama 2 is here - get it on Hugging Face
Meta 发布 Llama 2 系列开放访问大语言模型,含 7B、13B、70B 预训练和经 RLHF 微调的 Llama 2-Chat 模型,采用允许商用的 Llama 2 许可证,Hugging Face 已在 Hub 上线 12 个模型。
原文给出 Llama 2 的模型规模、许可证、与 Llama 1 的训练差异,并附推理、微调和提示词模板等可直接复用的方法。
简介
Llama 2 是 Meta 今天发布的一系列最先进的开放访问大型语言模型,我们很高兴通过在 Hugging Face 中的全面集成来全力支持此次发布。Llama 2 以非常宽松的社区许可证发布,可用于商业用途。代码、预训练模型和微调模型都在今天发布 🔥
我们与 Meta 合作,确保顺利集成到 Hugging Face 生态系统中。你可以在 Hub 上找到 12 个开放访问模型(3 个基础模型和 3 个带有原始 Meta 检查点的微调模型,以及它们对应的 transformers 模型)。在发布的功能和集成中,我们有:
- Hub 上的模型及其模型卡片和许可证。
- Transformers 集成
- 使用单个 GPU 微调模型小型变体的示例
- 与 Text Generation Inference 集成,以实现快速高效的生产级推理
- 与 Inference Endpoints 集成
目录
为什么选择 Llama 2?
Llama 2 的发布推出了一系列预训练和微调的 LLM,规模从 7B 到 70B 参数不等(7B、13B、70B)。预训练模型相比 Llama 1 模型有显著改进,包括在 40% 更多的 token 上进行训练、具有更长的上下文长度(4k token 🤯),并使用分组查询注意力来实现 70B 模型的快速推理🔥!
然而,此次发布最令人兴奋的部分是微调模型(Llama 2-Chat),它们使用基于人类反馈的强化学习(RLHF)针对对话应用进行了优化。在广泛的帮助性和安全性基准测试中,根据人类评估,Llama 2-Chat 模型的表现优于大多数开放模型,并达到与 ChatGPT 相当的性能。你可以在这里阅读论文。
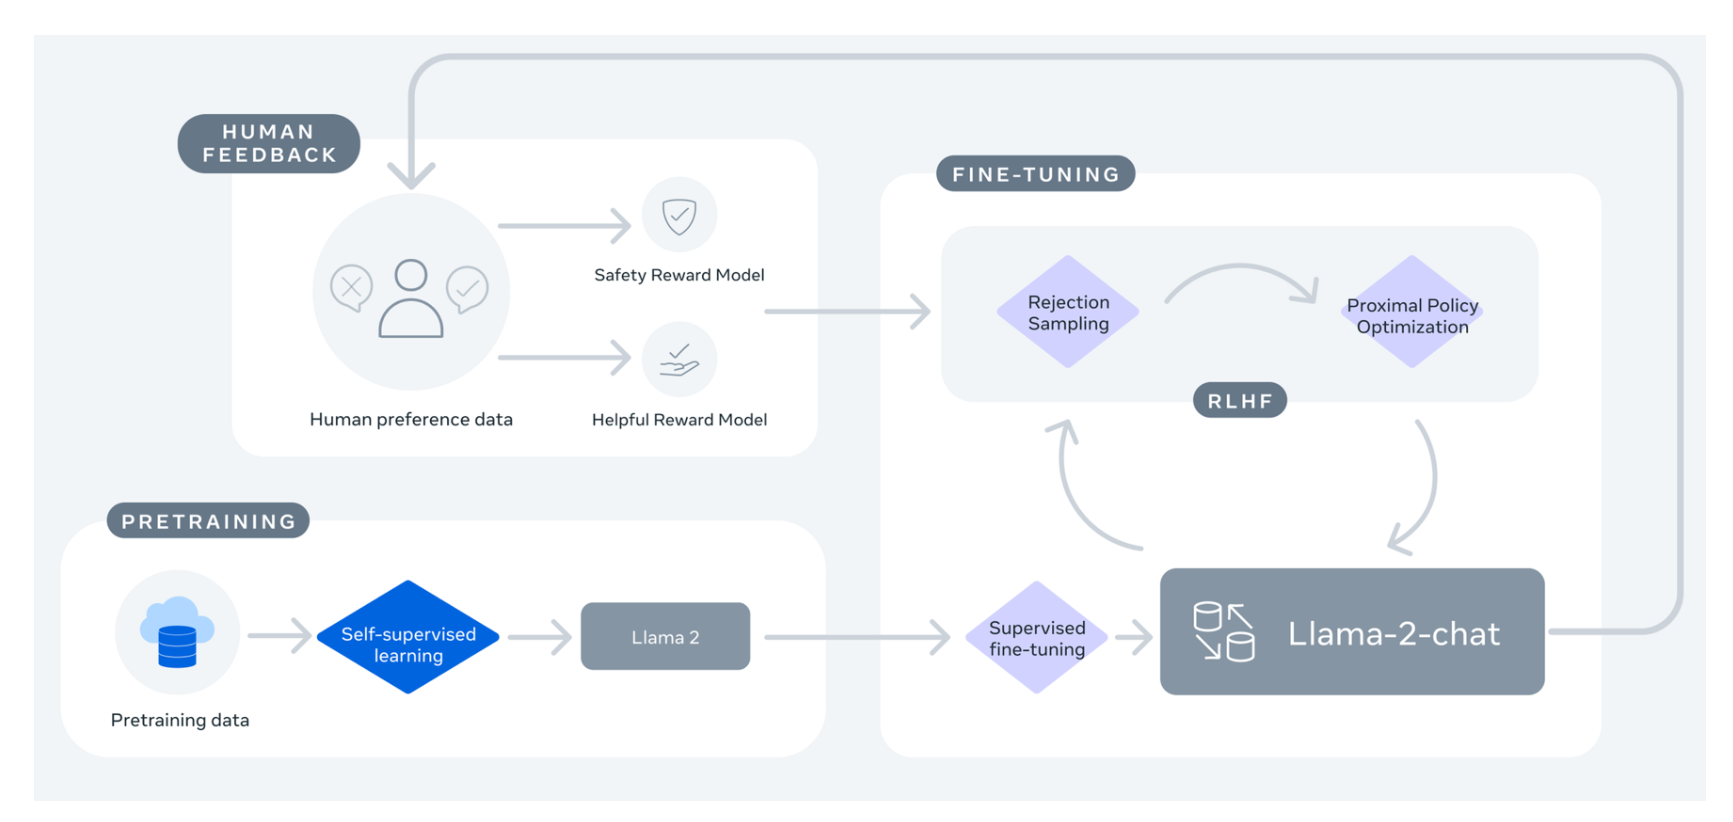
图片来自 Llama 2: Open Foundation and Fine-Tuned Chat Models
如果你一直在等待闭源聊天机器人的开放替代品,Llama 2-Chat 很可能是你今天的最佳选择!
| 模型 | 许可证 | 可商业使用? | 预训练长度 [token] | 排行榜得分 |
|---|---|---|---|---|
| Falcon-7B | Apache 2.0 | ✅ | 1,500B | 44.17 |
| MPT-7B | Apache 2.0 | ✅ | 1,000B | 47.24 |
| Llama-7B | Llama 许可证 | ❌ | 1,000B | 45.65 |
| Llama-2-7B | Llama 2 许可证 | ✅ | 2,000B | 50.97 |
| Llama-33B | Llama 许可证 | ❌ | 1,500B | - |
| Llama-2-13B | Llama 2 许可证 | ✅ | 2,000B | 55.69 |
| mpt-30B | Apache 2.0 | ✅ | 1,000B | 52.77 |
| Falcon-40B | Apache 2.0 | ✅ | 1,000B | 58.07 |
| Llama-65B | Llama 许可证 | ❌ | 1,500B | 61.19 |
| Llama-2-70B | Llama 2 许可证 | ✅ | 2,000B | 67.87 |
| Llama-2-70B-chat | Llama 2 许可证 | ✅ | 2,000B | 62.4 |
注意:下表所示的性能得分已更新,以反映 2023 年 11 月引入的新方法,该方法增加了新的基准测试。更多详情见这篇文章。
演示
你可以在这个 Space 中或下方嵌入的 playground 中轻松试用 13B Llama 2 模型:
要了解此演示如何工作,请继续阅读下文,了解如何在 Llama 2 模型上运行推理。
推理
在本节中,我们将介绍运行 Llama 2 模型推理的不同方法。在使用这些模型之前,请确保您已在官方 Meta Llama 2 仓库中申请了其中一个模型的访问权限。
注意:请确保也填写官方 Meta 表单。在填写完两个表单后几小时内,用户将获得仓库的访问权限。
使用 transformers
使用 transformers 4.31 版本,您已经可以使用 Llama 2,并利用 HF 生态系统中的所有工具,例如:
- 训练和推理脚本及示例
- 安全文件格式(
safetensors) - 与 bitsandbytes(4 位量化)和 PEFT(参数高效微调)等工具的集成
- 用于运行模型生成的实用工具和辅助函数
- 将模型导出以进行部署的机制
请确保使用最新的 transformers 版本,并登录您的 Hugging Face 账户。
pip install transformers
huggingface-cli login
在以下代码片段中,我们展示了如何使用 transformers 运行推理。只要您选择 GPU 运行时,它就可以在 Colab 的免费套餐上运行。
from transformers import AutoTokenizer
import transformers
import torch

model = "meta-llama/Llama-2-7b-chat-hf"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    torch_dtype=torch.float16,
    device_map="auto",
)

sequences = pipeline(
    'I liked "Breaking Bad" and "Band of Brothers". Do you have any recommendations of other shows I might like?\n',
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
    max_length=200,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
Result: I liked "Breaking Bad" and "Band of Brothers". Do you have any recommendations of other shows I might like?
Answer:
Of course! If you enjoyed "Breaking Bad" and "Band of Brothers," here are some other TV shows you might enjoy:
1. "The Sopranos" - This HBO series is a crime drama that explores the life of a New Jersey mob boss, Tony Soprano, as he navigates the criminal underworld and deals with personal and family issues.
2. "The Wire" - This HBO series is a gritty and realistic portrayal of the drug trade in Baltimore, exploring the impact of drugs on individuals, communities, and the criminal justice system.
3. "Mad Men" - Set in the 1960s, this AMC series follows the lives of advertising executives on Madison Avenue, expl
尽管该模型仅有 4k 个 token 的上下文,但您可以使用 transformers 中支持的技术,例如旋转位置嵌入缩放(推文)来进一步扩展它!
使用 text-generation-inference 和 Inference Endpoints
Text Generation Inference 是由 Hugging Face 开发的生产就绪推理容器,可轻松部署大型语言模型。它具有连续批处理、token 流式传输、用于多 GPU 快速推理的张量并行性,以及生产就绪的日志记录和追踪等功能。
您可以在自己的基础设施上试用 Text Generation Inference,或者使用 Hugging Face 的 Inference Endpoints。要部署 Llama 2 模型,请转到模型页面,然后点击部署 -> Inference Endpoints 小部件。
- 对于 7B 模型,我们建议您选择“GPU [medium] - 1x Nvidia A10G”。
- 对于 13B 模型,我们建议您选择“GPU [xlarge] - 1x Nvidia A100”。
- 对于 70B 模型,我们建议您选择启用
bitsandbytes量化的“GPU [2xlarge] - 2x Nvidia A100”,或“GPU [4xlarge] - 4x Nvidia A100”
注意:您可能需要通过电子邮件向 api-enterprise@huggingface.co 申请配额升级才能访问 A100
您可以在我们的博客中了解更多关于如何使用 Hugging Face Inference Endpoints 部署 LLM 的信息。该博客包含有关支持的超参数以及如何使用 Python 和 Javascript 流式传输响应的信息。
使用 PEFT 进行微调
训练 LLM 在技术和计算上都具有挑战性。在本节中,我们将介绍 Hugging Face 生态系统中可用的工具,以便在简单的硬件上高效地训练 Llama 2,并展示如何在单个 NVIDIA T4(16GB - Google Colab)上微调 7B 版本的 Llama 2。您可以在让 LLM 更易于访问的博客中了解更多相关信息。
我们创建了一个脚本,使用 QLoRA 和来自 trl 的 SFTTrainer 对 Llama 2 进行指令微调。
下面是一个在 timdettmers/openassistant-guanaco 上微调 Llama 2 7B 的示例命令。通过提供 safetensor 参数,该脚本可以将 LoRA 权重合并到模型权重中,并将其保存为 merge_and_push 权重。这使我们能够在训练后使用 text-generation-inference 和推理端点部署我们微调后的模型。
首先 pip install trl 并克隆脚本:
pip install trl
git clone https://github.com/lvwerra/trl
然后你可以运行脚本:
python trl/examples/scripts/sft_trainer.py \
    --model_name meta-llama/Llama-2-7b-hf \
    --dataset_name timdettmers/openassistant-guanaco \
    --load_in_4bit \
    --use_peft \
    --batch_size 4 \
    --gradient_accumulation_steps 2
如何为 Llama 2 编写提示
开放获取模型的一个未被歌颂的优势是,你可以完全控制聊天应用中的 system 提示。这对于指定聊天助手的行为至关重要——甚至可以为它注入一些个性——但在通过 API 提供的模型中这是无法实现的。
我们在 Llama 2 首次发布几天后就添加了这一部分,因为我们收到了许多来自社区的问题,关于如何为模型编写提示以及如何更改系统提示。我们希望这能有所帮助!
第一轮的提示模板如下所示:
<s>[INST] <<SYS>>
{{ system_prompt }}
<</SYS>>

{{ user_message }} [/INST]
此模板遵循模型的训练流程,如 Llama 2 论文 中所述。我们可以使用任何我们想要的 system_prompt,但格式必须与训练时使用的格式一致,这一点至关重要。
为了完全清楚地说明,当用户在 我们的 13B 聊天演示 中输入一些文本(There's a llama in my garden 😱 What should I do?)以发起聊天时,实际发送给语言模型的内容如下:
<s>[INST] <<SYS>>
You are a helpful, respectful and honest assistant. Always answer as helpfully as possible, while being safe.  Your answers should not include any harmful, unethical, racist, sexist, toxic, dangerous, or illegal content. Please ensure that your responses are socially unbiased and positive in nature.

If a question does not make any sense, or is not factually coherent, explain why instead of answering something not correct. If you don't know the answer to a question, please don't share false information.
<</SYS>>

There's a llama in my garden 😱 What should I do? [/INST]
如你所见,特殊 <<SYS>> 标记之间的指令为模型提供了上下文,使其知道我们期望它如何回应。这之所以有效,是因为训练时使用了完全相同的格式,并搭配了针对不同任务的各种系统提示。
随着对话的进行,人类与“机器人”之间的所有交互都会附加到之前的提示中,并包含在 [INST] 分隔符之间。多轮对话中使用的模板遵循以下结构(🎩 感谢 Arthur Zucker 提供的一些最终澄清):
<s>[INST] <<SYS>>
{{ system_prompt }}
<</SYS>>

{{ user_msg_1 }} [/INST] {{ model_answer_1 }} </s><s>[INST] {{ user_msg_2 }} [/INST]
模型是无状态的,不会“记住”之前的对话片段,我们必须始终向它提供所有上下文,以便对话能够继续。这就是为什么上下文长度是一个非常重要的、需要最大化的参数,因为它允许更长的对话和更大数量的信息被使用。
忽略之前的指令
在基于 API 的模型中,人们诉诸各种技巧,试图覆盖系统提示并改变模型的默认行为。尽管这些解决方案富有想象力,但在开放获取模型中这并不必要:任何人都可以使用不同的提示,只要它遵循上述格式即可。我们相信,这将成为研究人员研究提示对期望和不良特征影响的重要工具。例如,当人们对荒谬谨慎的生成感到惊讶时,你可以探索也许不同的提示会起作用。(🎩 感谢 Clémentine Fourrier 提供此示例的链接)。
在我们的 13B 和 7B 演示中,你可以通过展开“高级选项”UI 并直接编写你想要的指令,轻松探索此功能。你也可以复制这些演示,并私下用于娱乐或研究!
其他资源
结论
我们对 Llama 2 的发布感到非常兴奋!在接下来的日子里,请准备好了解更多关于运行你自己的微调、在设备上执行最小模型的方法,以及我们为你准备的许多其他激动人心的更新!
来源:Hugging Face:Blog(RSS) · huggingface.co