Falcon 模型进入 Hugging Face 生态:推理、量化与微调实践详解
The Falcon has landed in the Hugging Face ecosystem
Hugging Face 发布博客,详解阿布扎比 TII 以 Apache 2.0 许可开源的 Falcon-40B 与 Falcon-7B 模型,40B 版当时位居 Open LLM Leaderboard 首位,40B 与 7B 分别在 2800 和 700 PF-days 计算量下预训练。
原文在介绍 Falcon 模型的同时给出推理、量化和 QLoRA 微调的完整做法,读者可以照着在自有硬件上复现。
Falcon 是由阿布扎比的 Technology Innovation Institute 创建的一系列全新的先进语言模型,并以 Apache 2.0 许可证发布。值得注意的是,Falcon-40B 是首个“真正开放”的模型,其能力可与当前许多闭源模型相媲美。这对从业者、爱好者和业界来说都是个好消息,因为它为许多令人兴奋的应用场景打开了大门。
注意:在此版本发布几个月后,Falcon 团队发布了一个更大的 1800 亿参数模型。
2023 年 9 月更新:Falcon 180B 刚刚发布!它目前是最大的公开可用模型,可与 PaLM-2 等专有模型相媲美。
在这篇博客中,我们将深入探讨 Falcon 模型:首先讨论它们的独特之处,然后展示如何利用 Hugging Face 生态系统的工具轻松地在其之上进行构建(推理、量化、微调等)。
目录
Falcon 模型
Falcon 系列由两个基础模型组成:Falcon-40B 及其小兄弟 Falcon-7B。400 亿参数的模型在发布时位居 Open LLM 排行榜榜首,而 70 亿参数的模型则是同量级中最好的。
注意:下表中显示的性能分数已更新,以反映 2023 年 11 月引入的新方法,该方法增加了新的基准测试。更多详情请见这篇文章。
Falcon-40B 需要约 90GB 的 GPU 内存——这很多,但仍少于 LLaMA-65B,而 Falcon 的表现优于后者。另一方面,Falcon-7B 仅需约 15GB,使得推理和微调即使在消费级硬件上也能进行。(在本博客后面,我们将讨论如何利用量化使 Falcon-40B 即使在更便宜的 GPU 上也能使用!)
TII 还提供了模型的 instruct 版本:Falcon-7B-Instruct 和 Falcon-40B-Instruct。这些实验性变体已在指令和对话数据上进行了微调;因此它们更适合流行的助手式任务。如果你只是想快速试用这些模型,它们是你最好的选择。也可以基于社区构建的大量数据集构建你自己的自定义 instruct 版本——继续阅读以获取分步教程!
Falcon-7B 和 Falcon-40B 分别接受了 1.5 万亿和 1 万亿个 token 的训练,与现代模型优化推理的趋势一致。Falcon 模型高质量的关键因素在于其训练数据,主要基于(>80%)RefinedWeb——一个基于 CommonCrawl 的新型大规模网络数据集。TII 没有收集零散的精选来源,而是专注于扩展和提高网络数据的质量,利用大规模去重和严格过滤来匹配其他语料库的质量。Falcon 模型的训练中仍包含一些精选来源(如来自 Reddit 的对话数据),但远少于 GPT-3 或 PaLM 等最先进 LLM 的常见做法。最棒的是?TII 已公开发布了 RefinedWeb 的 6000 亿 token 提取版本,供社区在自己的 LLM 中使用!
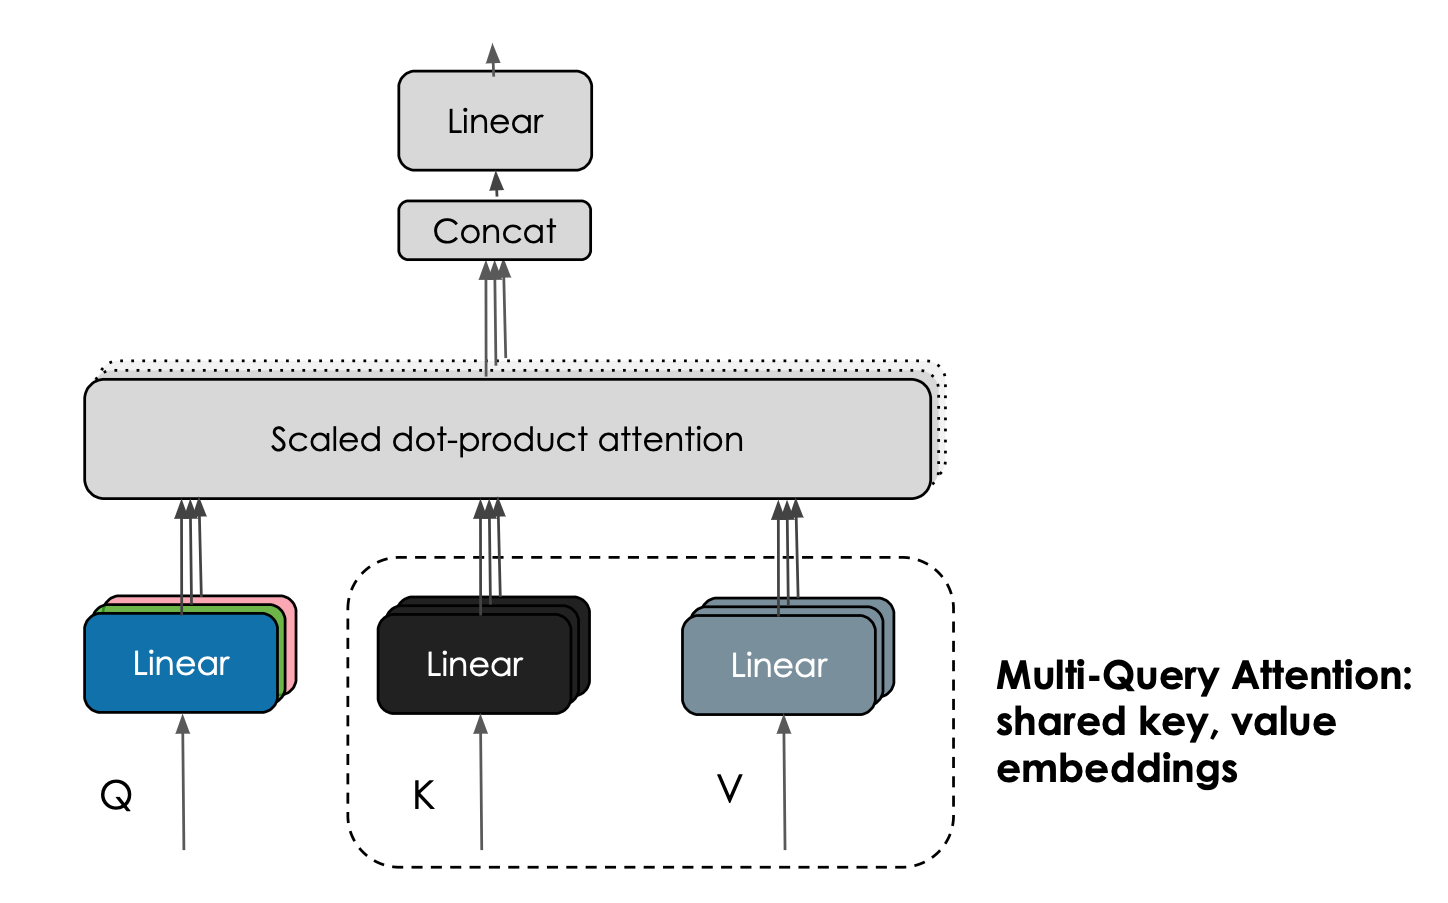
Falcon 模型的另一个有趣特性是使用了多查询注意力。普通的多头注意力方案每个头有一个查询、键和值;多查询则在所有头之间共享一个键和值。
 |
|---|
| 多查询注意力在注意力头之间共享键和值嵌入。由 Harm de Vries 提供。 |
这个技巧不会显著影响预训练,但它极大地提高了推理的可扩展性:事实上,自回归解码期间保留的 K,V 缓存现在显著更小(根据架构的具体情况,缩小 10-100 倍),降低了内存成本,并实现了诸如状态保持等新颖优化。
| 模型 | 许可证 | 商业使用? | 预训练长度 [tokens] | 预训练计算量 [PF-days] | 排行榜得分 | 2.048 上下文的 K,V 缓存大小 |
|---|---|---|---|---|---|---|
| StableLM-Alpha-7B | CC-BY-SA-4.0 | ✅ | 1,500B | 700 | 34.37 | 800MB |
| LLaMA-7B | LLaMA 许可证 | ❌ | 1,000B | 500 | 45.65 | 1,100MB |
| MPT-7B | Apache 2.0 | ✅ | 1,000B | 500 | 44.28 | 1,100MB |
| Falcon-7B | Apache 2.0 | ✅ | 1,500B | 700 | 44.17 | 20MB |
| LLaMA-33B | LLaMA 许可证 | ❌ | 1,500B | 3200 | - | 3,300MB |
| LLaMA-65B | LLaMA 许可证 | ❌ | 1,500B | 6300 | 61.19 | 5,400MB |
| Falcon-40B | Apache 2.0 | ✅ | 1,000B | 2800 | 58.07 | 240MB |
演示
你可以在这个 Space 或下方嵌入的 playground 中轻松试用 Big Falcon Model(400 亿参数!):
在底层,这个 playground 使用了 Hugging Face 的 Text Generation Inference,一个可扩展的 Rust、Python 和 gRPC 服务器,用于快速高效的文本生成。它也是驱动 HuggingChat 的同一技术。
我们还构建了 7B instruct 模型的 Core ML 版本,以下是它在 M1 MacBook Pro 上的运行情况:
视频展示了一个轻量级应用,它利用 Swift 库来处理繁重的工作:模型加载、分词、输入准备、生成和解码。我们正忙于构建这个库,使开发者能够将强大的 LLM 集成到各种应用中,而无需重新发明轮子。它还有些粗糙,但我们迫不及待地想与你们分享。同时,你可以从仓库下载 Core ML 权重并自行探索!
推理
你可以使用熟悉的 transformers API 在自己的硬件上运行模型,但需要注意几个细节:
- 模型使用
bfloat16数据类型进行训练,因此我们建议你也使用相同的数据类型。这需要较新版本的 CUDA,并且在现代显卡上效果最佳。你也可以尝试使用float16运行推理,但请记住,模型是使用bfloat16进行评估的。 - 你需要允许远程代码执行。这是因为这些模型使用了一种新的架构,尚未成为
transformers的一部分——相反,所需的代码由模型作者在仓库中提供。具体来说,如果你允许远程执行,将使用以下文件的代码(以falcon-7b-instruct为例):configuration_RW.py、modelling_RW.py。
考虑到这些因素,你可以使用 transformers pipeline API 来加载 7B 指令模型,如下所示:
from transformers import AutoTokenizer
import transformers
import torch

model = "tiiuae/falcon-7b-instruct"

tokenizer = AutoTokenizer.from_pretrained(model)
pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    device_map="auto",
)
然后,你可以使用如下代码运行文本生成:
sequences = pipeline(
   "Write a poem about Valencia.",
    max_length=200,
    do_sample=True,
    top_k=10,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
你可能会得到类似以下的结果:
Valencia, city of the sun
The city that glitters like a star
A city of a thousand colors
Where the night is illuminated by stars
Valencia, the city of my heart
Where the past is kept in a golden chest
Falcon 40B 的推理
运行 40B 模型因其规模而具有挑战性:它无法装入单个具有 80 GB 内存的 A100 中。以 8 位模式加载时,它可以在约 45 GB 内存中运行,这适合 A6000(48 GB),但不适合 40 GB 版本的 A100。你可以这样做:
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model_id = "tiiuae/falcon-40b-instruct"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    trust_remote_code=True,
    load_in_8bit=True,
    device_map="auto",
)

pipeline = transformers.pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
)
但请注意,混合 8 位推理将使用 torch.float16 而不是 torch.bfloat16,因此请务必彻底测试结果。
如果你有多张显卡并安装了 accelerate,你可以利用 device_map="auto" 自动将模型层分布到各个显卡上。必要时,它甚至可以将某些层卸载到 CPU,但这会影响推理速度。
还可以使用最新版本的 bitsandbytes、transformers 和 accelerate 进行 4 位加载。在这种情况下,40B 模型运行需要约 27 GB 内存。遗憾的是,这略高于 3090 或 4090 等显卡的可用内存,但足以在 30 或 40 GB 的显卡上运行。
文本生成推理
文本生成推理是由 Hugging Face 开发的生产就绪推理容器,可轻松部署大型语言模型。
其主要特性包括:
- 连续批处理
- 使用服务器发送事件(SSE)的令牌流式传输
- 用于在多 GPU 上更快推理的张量并行
- 使用自定义 CUDA 内核优化的 transformers 代码
- 使用 Prometheus 和 Open Telemetry 的生产就绪日志记录、监控和追踪
自 v0.8.2 起,文本生成推理原生支持 Falcon 7b 和 40b 模型,无需依赖 Transformers 的“信任远程代码”功能,从而实现密封部署和安全审计。此外,Falcon 实现包含自定义 CUDA 内核,可显著降低端到端延迟。
 |
|---|
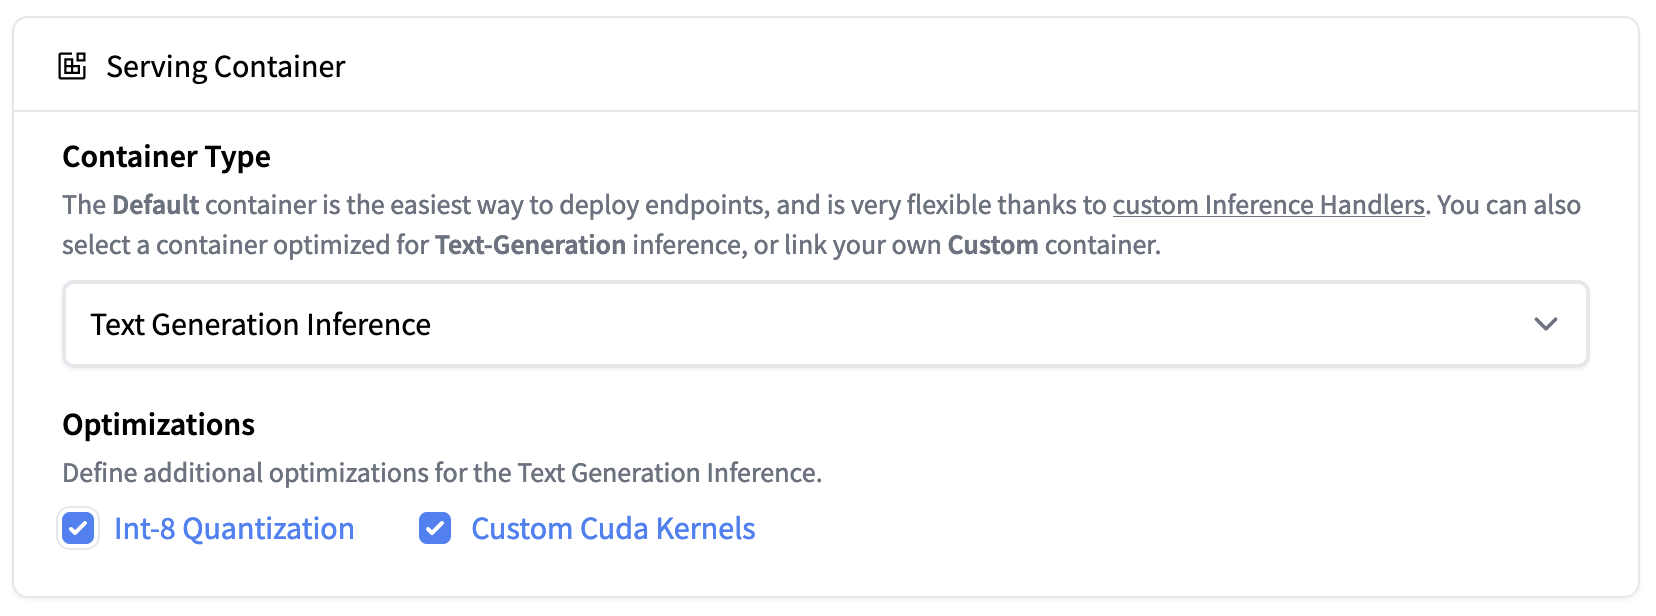
| 推理端点现已支持文本生成推理。使用 Int-8 量化在 1xA100 上轻松部署 Falcon 40B Instruct 模型 |
文本生成推理现已集成到 Hugging Face 的 推理端点中。要部署 Falcon 模型,请转到模型页面并点击部署 -> 推理端点小部件。
对于 7B 模型,我们建议你选择“GPU [medium] - 1x Nvidia A10G”。
对于 40B 模型,你需要在“GPU [xlarge] - 1x Nvidia A100”上部署并激活量化:高级配置 -> 服务容器 -> Int-8 量化。注意:你可能需要通过电子邮件向 api-enterprise@huggingface.co 请求配额升级
评估
那么 Falcon 模型到底有多好?Falcon 作者即将发布一份深入评估,在此期间,我们对基础模型和指令模型都运行了我们的 开放 LLM 基准测试。该基准测试衡量 LLM 的推理能力,以及它们在以下领域提供真实答案的能力:
- AI2 推理挑战赛(ARC):小学水平的科学选择题。
- HellaSwag:围绕日常事件的常识推理。
- MMLU:涵盖 57 个学科(专业与学术)的选择题。
- TruthfulQA:测试模型区分事实与一组对抗性挑选的错误陈述的能力。
结果显示,40B 基础模型和指令模型非常强大,目前在 LLM 排行榜上分别排名第 1 和第 2 🏆!
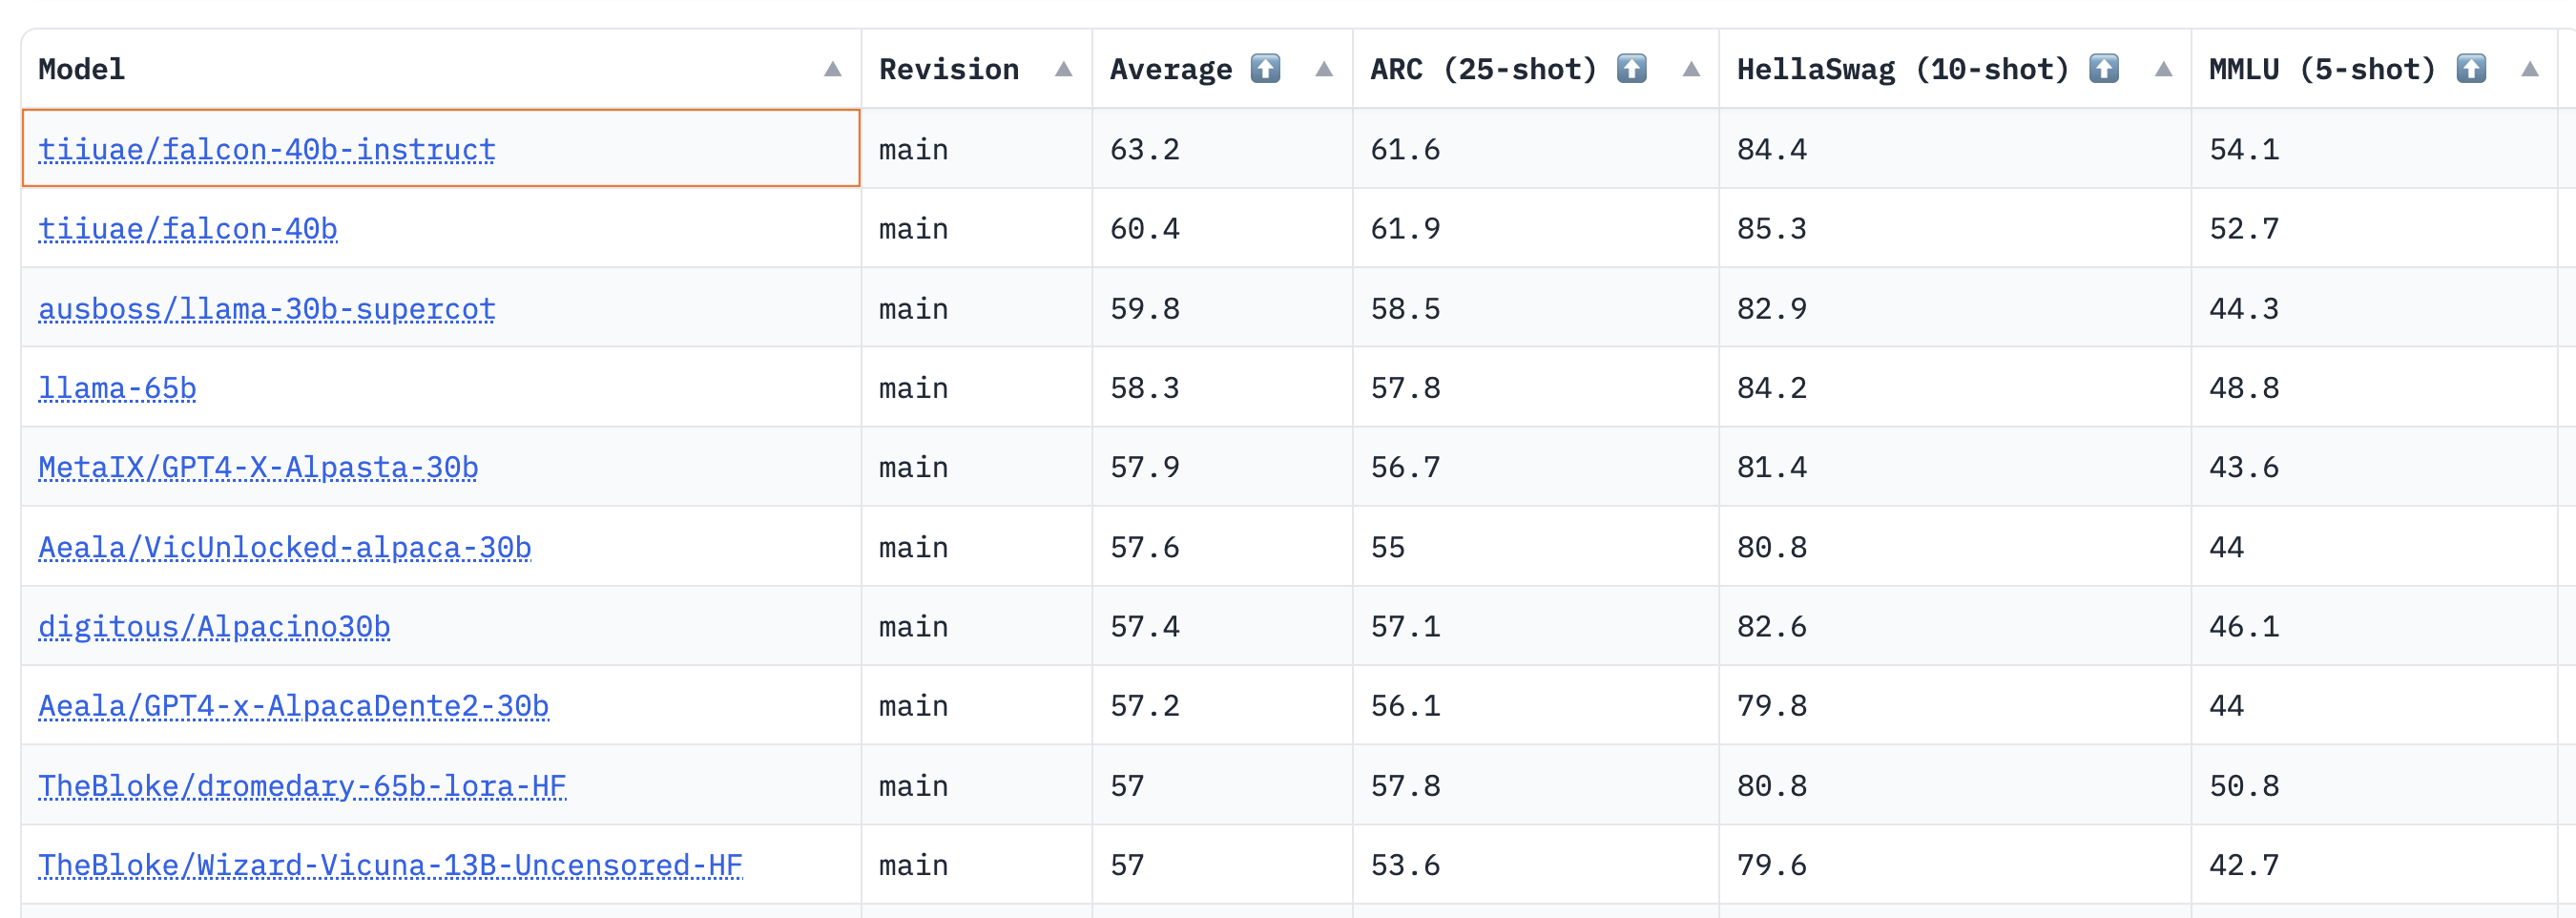
正如 Thomas Wolf 所指出的,这里一个令人惊讶的洞见是,40B 模型预训练所用的计算量大约只有 LLaMa 65B 所需的一半(2800 对 6300 petaflop days),这表明我们还没有完全触及 LLM 预训练“最优”的极限。
对于 7B 模型,我们看到基础模型优于 llama-7b,并险胜 MosaicML 的 mpt-7b,成为当前该规模下最佳的预训练 LLM。下面复现了排行榜中一些热门模型的简短列表以供比较:
| 模型 | 类型 | 排行榜平均得分 |
|---|---|---|
| tiiuae/falcon-40b-instruct | 指令 | 63.2 |
| tiiuae/falcon-40b | 基础 | 60.4 |
| llama-65b | 基础 | 58.3 |
| TheBloke/dromedary-65b-lora-HF | 指令 | 57 |
| stable-vicuna-13b | rlhf | 52.4 |
| llama-13b | 基础 | 51.8 |
| TheBloke/wizardLM-7B-HF | 指令 | 50.1 |
| tiiuae/falcon-7b | 基础 | 48.8 |
| mosaicml/mpt-7b | 基础 | 48.6 |
| tiiuae/falcon-7b-instruct | 指令 | 48.4 |
| llama-7b | 基础 | 47.6 |
尽管开放 LLM 排行榜并不衡量聊天能力(在这方面人类评估才是黄金标准),但 Falcon 模型的这些初步结果非常令人鼓舞!
现在让我们来看看如何微调你自己的 Falcon 模型——也许你的某个模型最终会登上排行榜榜首 🤗。
使用 PEFT 进行微调
训练 10B+ 规模的模型在技术和计算上都颇具挑战。在本节中,我们将介绍 Hugging Face 生态系统中可用的工具,以便在简单硬件上高效训练超大型模型,并展示如何在单块 NVIDIA T4(16GB - Google Colab)上微调 Falcon-7b。
让我们看看如何在 Guanaco 数据集上训练 Falcon,这是 Open Assistant 数据集的一个高质量子集,包含约 10,000 段对话。借助 PEFT 库,我们可以使用最近的 QLoRA 方法,微调置于冻结的 4-bit 模型之上的适配器。你可以在这篇博客文章中了解更多关于 4-bit 量化模型集成的信息。
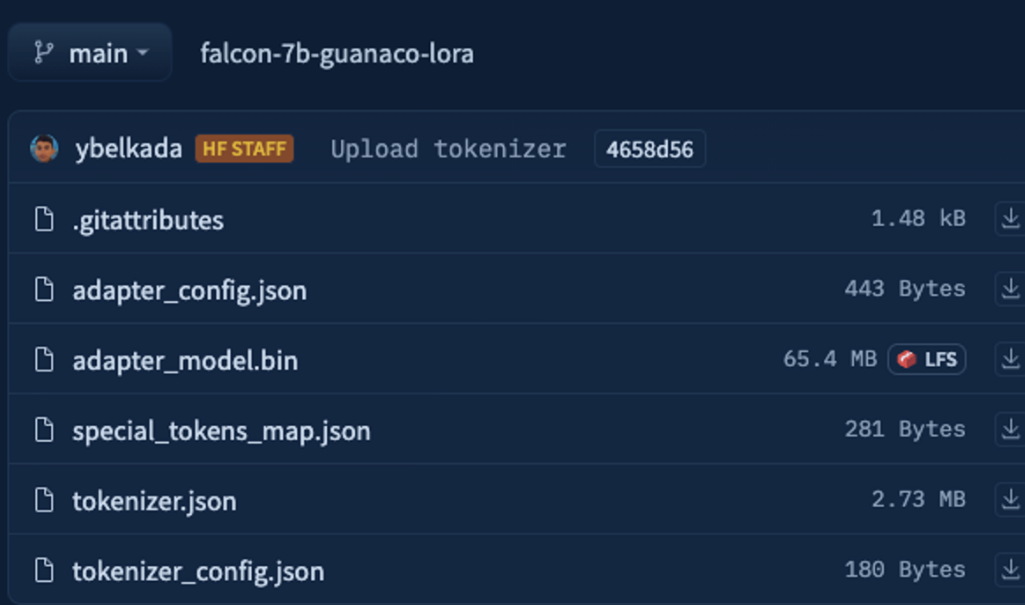
由于使用低秩适配器(LoRA)时只有极小一部分模型可训练,学习参数的数量和训练产物的体积都大幅减少。如下方截图所示,对于 7B 参数模型,保存的模型仅有 65MB(float16 下为 15GB)。
 |
|---|
| 最终仓库只有 65MB 的权重——而原始模型在半精度下大约有 15GB |
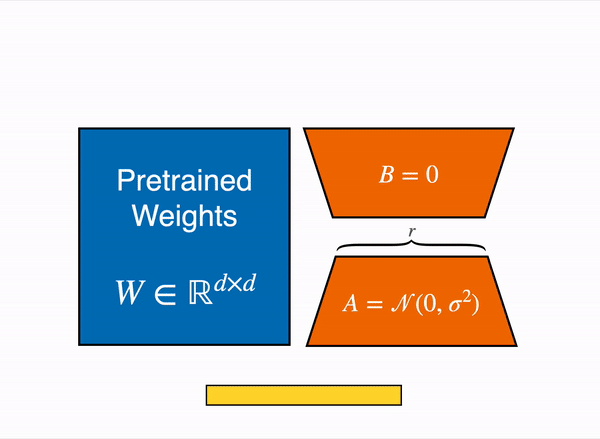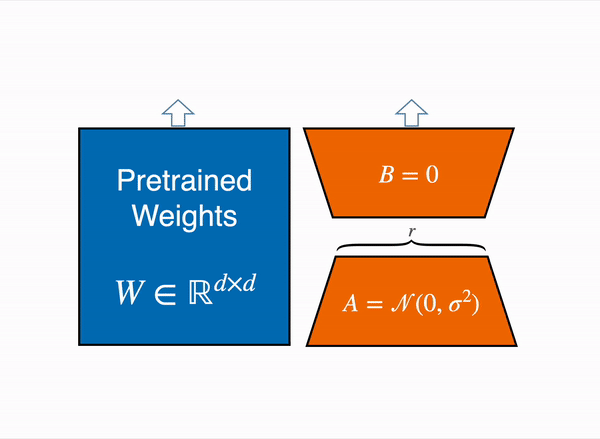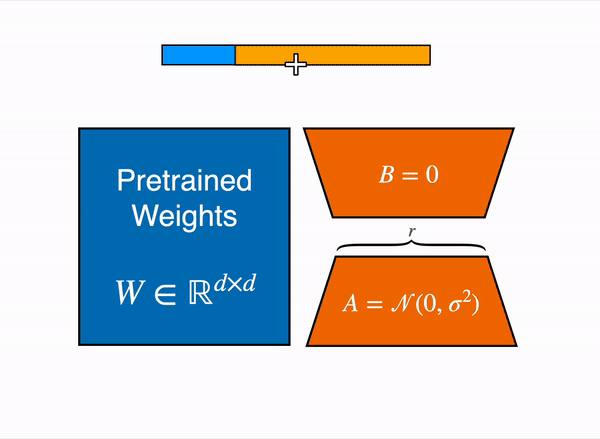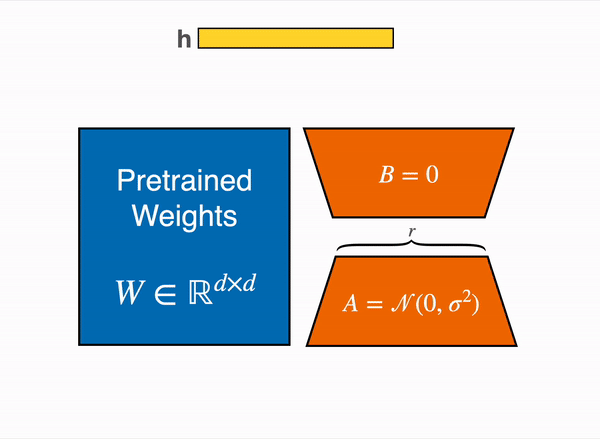
更具体地说,在选择要适配的目标模块(实践中是注意力模块的查询/键层)之后,小型可训练线性层会附着在这些模块附近,如下图所示。适配器产生的隐藏状态随后被添加到原始状态中,以获得最终的隐藏状态。
 |
|---|
| 原始(冻结)预训练权重的输出激活(左侧)由包含权重矩阵 A 和 B 的低秩适配器(右侧)增强。 |
训练完成后,无需保存整个模型,因为基础模型保持冻结状态。此外,只要这些模块输出的隐藏状态被转换为与适配器相同的 dtype,模型就可以保持任意 dtype(int8、fp4、fp16 等)——bitsandbytes 模块(Linear8bitLt 和 Linear4bit)就是这种情况,它们返回的隐藏状态与原始未量化模块具有相同的 dtype。
我们在 Guanaco 数据集上微调了 Falcon 模型的两个变体(7B 和 40B)。我们在单个 NVIDIA-T4 16GB 上微调了 7B 模型,在单个 NVIDIA A100 80GB 上微调了 40B 模型。我们使用了 4bit 量化的基础模型和 QLoRA 方法,以及 TRL 库中最近的 SFTTrainer。
使用 PEFT 复现我们实验的完整脚本可在此处获取,但只需几行代码即可快速运行 SFTTrainer(为简单起见不使用 PEFT):
from datasets import load_dataset
from trl import SFTTrainer
from transformers import AutoTokenizer, AutoModelForCausalLM

dataset = load_dataset("imdb", split="train")

model_id = "tiiuae/falcon-7b"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(model_id, trust_remote_code=True)

trainer = SFTTrainer(
    model,
    tokenizer=tokenizer,
    train_dataset=dataset,
    dataset_text_field="text",
    max_seq_length=512,
)
trainer.train()
查看原始 qlora 仓库以了解有关评估训练模型的更多详细信息。
微调资源
结论
Falcon 是一个令人兴奋的新大型语言模型,可用于商业应用。在这篇博客文章中,我们展示了它的能力、如何在自己的环境中运行它,以及在 Hugging Face 生态系统中基于自定义数据进行微调是多么容易。我们很期待看到社区将用它构建出什么!
来源:Hugging Face:Blog(RSS) · huggingface.co