Hugging Face 拆解 AI WebTV 的搭建方法与架构
Building an AI WebTV
Hugging Face 发布 AI WebTV 技术演示,用开源文生视频模型 Zeroscope(zeroscope_v2_576 与 zeroscope_v2_XL)和 MusicGen 自动生成视频与音乐并持续串流。
原文完整拆解了用 Zeroscope、MusicGen 和 FFmpeg 搭建自动视频流的全链路,并给出提示词与帧插值的实操建议。
AI WebTV 是一个实验性演示,旨在展示自动视频和音乐合成领域的最新进展。
👉 前往 AI WebTV Space 即可立即观看直播。
如果你使用的是移动设备,可以通过 Twitch 镜像观看直播。
概念
AI WebTV 的初衷是以一种有趣且易于访问的方式,展示使用开源 文本到视频模型(如 Zeroscope 和 MusicGen)生成的视频。
你可以在 Hugging Face hub 上找到这些开源模型:
各个视频片段被刻意做得简短,这意味着 WebTV 应被视为一个技术演示/作品集,而非真正的节目(有艺术指导或编排)。
架构
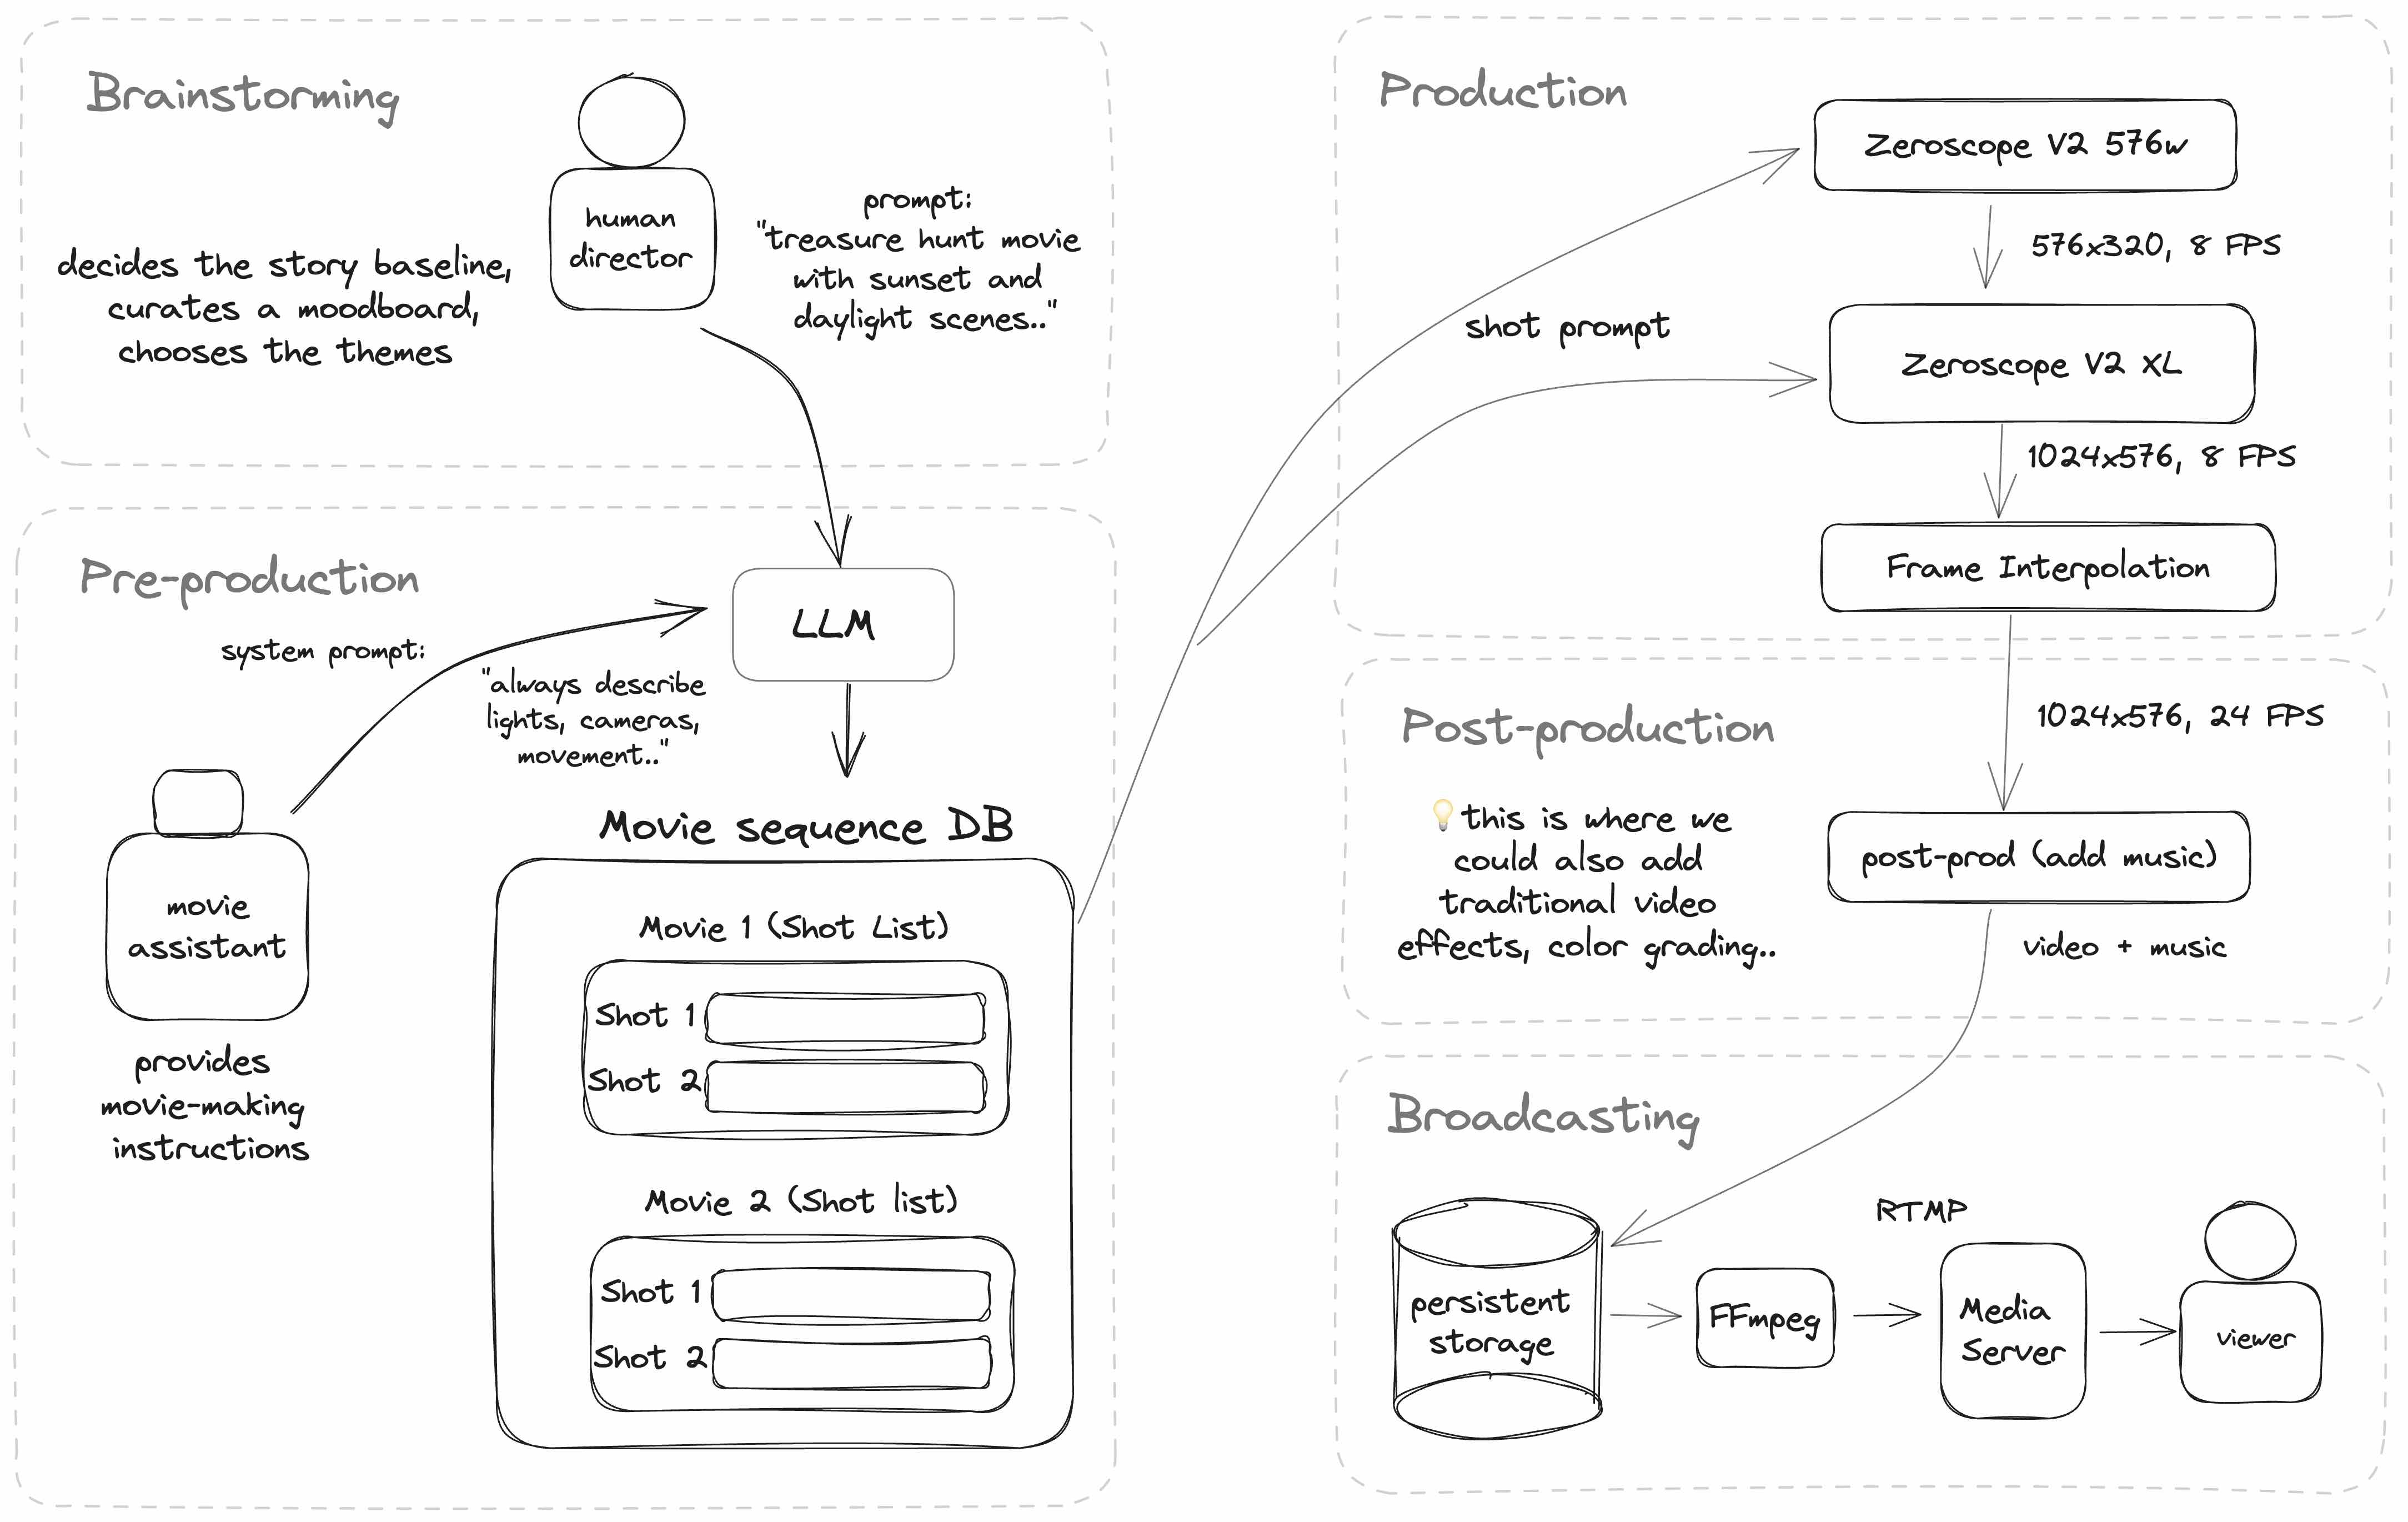
AI WebTV 的工作原理是接收一系列 视频镜头提示,并将它们传递给 文本到视频模型,以生成一系列镜头。
此外,一个基础主题和想法(由人类撰写)会通过 LLM(在此例中为 ChatGPT)传递,以便为每个视频片段生成各种单独的提示。
以下是 AI WebTV 当前架构的示意图:
实现流水线
WebTV 使用 NodeJS 和 TypeScript 实现,并使用了 Hugging Face 上托管的多种服务。
文本到视频模型
核心视频模型是 Zeroscope V2,这是一个基于 ModelScope 的模型。
Zeroscope 由两个可以串联的部分组成:
- 第一遍使用 zeroscope_v2_576,生成 576x320 的视频片段
- 可选的第二遍使用 zeroscope_v2_XL,将视频放大到 1024x576
👉 生成和放大都需要使用相同的提示。
调用视频链
为了快速制作原型,WebTV 通过两个运行 Gradio 的重复 Hugging Face Space 来运行 Zeroscope,并使用 @gradio/client NPM 包进行调用。你可以在这里找到原始 space:
- 由 @hysts 提供的 zeroscope-v2
- 由 @fffiloni 提供的 Zeroscope XL
如果你在 Hub 上搜索 Zeroscope,还可以找到社区部署的其他 space。
👉 公共 Space 可能随时变得拥挤并暂停。如果你打算部署自己的系统,请复制这些 Space 并在你自己的账户下运行它们。
使用托管在 Space 上的模型
使用 Gradio 的 Space 能够暴露 REST API,然后可以使用 @gradio/client 模块从 Node 中调用。
以下是一个示例:
import { client } from "@gradio/client"

export const generateVideo = async (prompt: string) => {
  const api = await client("*** URL OF THE SPACE ***")

  // call the "run()" function with an array of parameters
  const { data } = await api.predict("/run", [
    prompt,
    42,	// seed
    24, // nbFrames
    35 // nbSteps
  ])

  const { orig_name } = data[0][0]

  const remoteUrl = `${instance}/file=${orig_name}`

  // the file can then be downloaded and stored locally
}
后处理
一旦单个镜头(视频片段)被放大,它就会被传递给 FILM(Frame Interpolation for Large Motion),一种帧插值算法:
- 原始链接:网站、源代码
- Hugging Face 上的模型:/frame-interpolation-film-style
- 你可以复制的 Hugging Face Space:由 @fffiloni 提供的 video_frame_interpolation
在后处理过程中,我们还会添加使用 MusicGen 生成的音乐:
广播流
注意:你可以使用多种工具来创建视频流。AI WebTV 目前使用 FFmpeg 来读取由 mp4 视频文件和 m4a 音频文件组成的播放列表。
以下是创建此类播放列表的示例:
import { promises as fs } from "fs"
import path from "path"

const allFiles = await fs.readdir("** PATH TO VIDEO FOLDER **")
const allVideos = allFiles
  .map(file => path.join(dir, file))
  .filter(filePath => filePath.endsWith('.mp4'))

let playlist = 'ffconcat version 1.0\n'
allFilePaths.forEach(filePath => {
  playlist += `file '${filePath}'\n`
})
await fs.promises.writeFile("playlist.txt", playlist)
这将生成以下播放列表内容:
ffconcat version 1.0
file 'video1.mp4'
file 'video2.mp4'
...
然后再次使用 FFmpeg 读取此播放列表,并向 RTMP 服务器发送 FLV 流。FLV 是一种旧格式,但由于其低延迟,在实时流媒体领域仍然很受欢迎。
ffmpeg -y -nostdin \
  -re \
  -f concat \
  -safe 0 -i channel_random.txt -stream_loop -1 \
  -loglevel error \
  -c:v libx264 -preset veryfast -tune zerolatency \
  -shortest \
  -f flv rtmp://<SERVER>
FFmpeg 有许多不同的配置选项,更多信息请参阅官方文档。
对于 RTMP 服务器,你可以在 GitHub 上找到开源实现,例如 NGINX-RTMP 模块。
AI WebTV 本身使用 node-media-server。
💡 你也可以直接推流到 Twitch 的 RTMP 入口点之一。查看 Twitch 文档了解更多详情。
观察与示例
以下是一些生成内容的示例。
我们首先注意到的是,应用 Zeroscope XL 的第二遍处理显著提升了图像质量。帧插值的效果也清晰可见。
角色与场景构图
动态场景模拟
文本到视频模型真正引人入胜的一点是,它们能够模拟训练中所见过的现实生活现象。
我们已经在大型语言模型上看到了这一点,它们能够合成模仿人类回应的令人信服的内容,但当应用于视频时,这将事情提升到了一个全新的维度。
视频模型会预测场景的后续帧,其中可能包括运动中的物体,如流体、人、动物或车辆。如今,这种模拟并不完美,但评估未来的模型(在更大或专门的数据集上训练,例如动物运动)在再现物理现象时的准确性,以及它们模拟智能体行为的能力,将会很有趣。
💡 未来看到这些能力得到更多探索将会很有趣,例如在覆盖更多现象的大型视频数据集上训练视频模型。
样式与效果
失败案例
方向错误:模型有时在处理运动和方向时会有困难。例如,这里的片段似乎是倒放的。此外,修饰关键词绿色也没有被考虑在内。
真实场景的渲染错误:有时我们能看到移动的垂直线或波纹等伪影。目前尚不清楚原因,但可能是所用关键词组合导致的。
文字或物体被插入图像:模型有时会把提示词中的词语注入场景,例如“IMAX”。在提示词中提到“Canon EOS”或“Drone footage”也会让这些物体出现在视频中。
在下面的例子中,我们注意到“llama”这个词插入了一只大羊驼,还插入了两处火焰中的“llama”字样。
建议
以下是根据之前的观察得出的一些早期建议:
使用视频专用的提示词关键词
你可能已经知道,如果你没有用 Stable Diffusion 对图像的某个特定方面进行提示,那么衣服的颜色或一天中的时间等细节可能会变得随机,或者被赋予一个通用的值,比如中性的正午光线。
视频模型也是如此:你需要对事物进行具体说明。例如摄像机和角色的运动、它们的朝向、速度和方向。出于创意目的(构思),你可以不指定这些,但这可能并不总能给你想要的结果(例如,实体反向运动)。
保持场景之间的一致性
如果你打算创建由多个视频组成的序列,你会希望确保在每个提示词中加入尽可能多的细节,否则你可能会在一个序列到另一个序列之间丢失重要细节,比如颜色。
💡 这也会提升图像质量,因为该提示词会用于 Zeroscope XL 的放大环节。
利用帧插值
帧插值是一个强大的工具,可以修复小的渲染错误,并将许多缺陷转化为特色,尤其是在动画较多的场景中,或者可以接受卡通效果的情况下。FILM 算法会结合视频片段中之前和之后的事件来平滑帧中的元素。
当摄像机平移或旋转时,这对于移动背景效果很好,也会给你创作自由,比如控制生成后的帧数,以制作慢动作效果。
未来工作
我们希望你喜欢观看 AI WebTV 直播,并希望它能启发你在这个领域进行更多创作。
由于这是首次尝试,很多内容并不是这个技术演示的重点:生成更长、更多样的序列,添加音频(音效、对话),生成并编排复杂场景,或者让语言模型智能体对流程拥有更多控制。
其中一些想法可能会进入 AI WebTV 的未来更新中,但我们也迫不及待地想看到研究人员、工程师和开发者社区会想出什么!
来源:Hugging Face:Blog(RSS) · huggingface.co