TII 发布 1800 亿参数开源模型 Falcon 180B 登陆 Hugging Face
Spread Your Wings: Falcon 180B is here
TII 的 Falcon 180B 登陆 Hugging Face,拥有 180B 参数,使用 RefinedWeb 数据集在 3.5 万亿 token 上预训练,是当时最大的公开可用大语言模型。
官方介绍了 Falcon 180B 的训练规模、基准表现和量化推理的硬件门槛,读者可据此评估部署成本。
简介
今天,我们非常激动地欢迎 TII 的 Falcon 180B 加入 HuggingFace! Falcon 180B 为开放模型树立了新的最先进水平。它是目前公开可用的最大语言模型,拥有 1800 亿参数,并使用 TII 的 RefinedWeb 数据集在高达 3.5 万亿个 token 上进行了训练。这代表了开放模型中最长的单次预训练。
你可以在 Hugging Face Hub 上找到该模型(基础和聊天模型),并在 Falcon Chat Demo Space 中与模型互动。
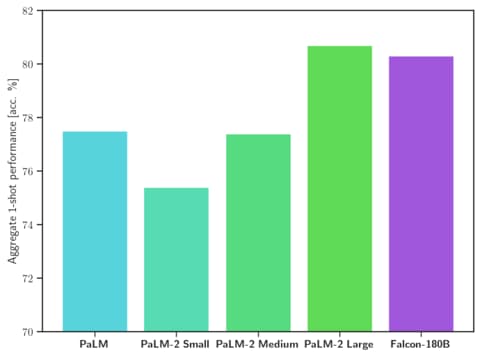
在能力方面,Falcon 180B 在自然语言任务上取得了最先进的结果。它在(预训练)开放访问模型的排行榜上名列前茅(在其发布时),并可与 PaLM-2 等专有模型相媲美。虽然目前还难以给出明确的排名,但它被认为与 PaLM-2 Large 相当,使 Falcon 180B 成为公开已知的最强大的 LLM 之一。
在这篇博文中,我们通过查看一些评估结果来探索 Falcon 180B 为何如此出色,并展示如何使用该模型。
什么是 Falcon-180B?
Falcon 180B 是由 TII 发布的模型,延续了 Falcon 系列的先前版本。
在架构方面,Falcon 180B 是 Falcon 40B 的放大版本,并基于其创新,例如用于提高可扩展性的多查询注意力。我们建议回顾介绍 Falcon 的初始博文,以深入了解其架构。Falcon 180B 在高达 4096 个 GPU 上同时使用 3.5 万亿个 token 进行训练,使用 Amazon SageMaker 总共约 7,000,000 GPU 小时。这意味着 Falcon 180B 比 Llama 2 大 2.5 倍,并且训练计算量是其 4 倍。
Falcon 180B 的数据集主要由来自 RefinedWeb 的网络数据组成(约 85%)。此外,它还接受了精选数据(如对话、技术论文和一小部分代码(约 3%))的混合训练。这个预训练数据集足够大,即使 3.5 万亿个 token 也不到一个 epoch。
发布的聊天模型在聊天和指令数据集上进行了微调,混合了多个大规模对话数据集。
‼️ 商业使用: Falcon 180b 可以商业使用,但条件非常严格,不包括任何“托管使用”。我们建议您查看许可证,如果您有兴趣将其用于商业目的,请咨询您的法律团队。
Falcon 180B 有多好?
Falcon 180B 在发布时是最好的公开释放的 LLM,在 MMLU 上优于 Llama 2 70B 和 OpenAI 的 GPT-3.5,并在 HellaSwag、LAMBADA、WebQuestions、Winogrande、PIQA、ARC、BoolQ、CB、COPA、RTE、WiC、WSC、ReCoRD 上与 Google 的 PaLM 2-Large 相当。根据评估基准,Falcon 180B 通常介于 GPT 3.5 和 GPT4 之间,既然它已经公开释放,社区进一步的微调将非常值得关注。
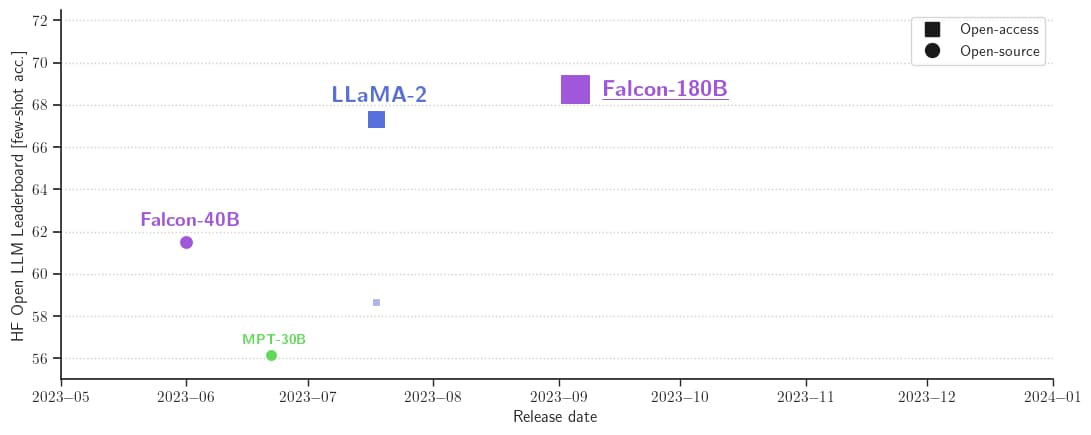
在发布时,Falcon 180B 在 Hugging Face 排行榜上以 68.74 的分数成为得分最高的公开释放的预训练 LLM,超过了 Meta 的 Llama 2。*
| 模型 | 大小 | 排行榜分数 | 商业使用或许可证 | 预训练长度 |
|---|---|---|---|---|
| Falcon | 180B | 67.85 | 🟠 | 3,500B |
| Llama 2 | 70B | 67.87 | 🟠 | 2,000B |
| LLaMA | 65B | 61.19 | 🔴 | 1,400B |
| Falcon | 40B | 58.07 | 🟢 | 1,000B |
| MPT | 30B | 52.77 | 🟢 | 1,000B |
- Open LLM Leaderboard 在 2023 年 11 月新增了两项基准测试,我们已更新上表以反映最新得分(67.85)。根据新方法,Falcon 与 Llama 2 70B 不相上下。
量化后的 Falcon 模型在各基准测试中保持了相似的指标。在评估 torch.float16、8bit 和 4bit 时,结果相似。请查看 Open LLM Leaderboard 中的结果。
如何使用 Falcon 180B?
Falcon 180B 已在 Hugging Face 生态系统中可用,从 Transformers 4.33 版本开始。
演示
你可以在这个 Space 中轻松试用 Big Falcon Model(1800 亿参数!),或使用下方嵌入的 playground:
硬件要求
我们针对不同用例运行模型所需的硬件进行了多项测试。这些并非最低要求,而是我们所能访问的配置的最低要求。
| 类型 | 种类 | 内存 | 示例 | |
|---|---|---|---|---|
| Falcon 180B | 训练 | 全量微调 | 5120GB | 8x 8x A100 80GB |
| Falcon 180B | 训练 | 使用 ZeRO-3 的 LoRA | 1280GB | 2x 8x A100 80GB |
| Falcon 180B | 训练 | QLoRA | 160GB | 2x A100 80GB |
| Falcon 180B | 推理 | BF16/FP16 | 640GB | 8x A100 80GB |
| Falcon 180B | 推理 | GPTQ/int4 | 320GB | 8x A100 40GB |
提示格式
基础模型没有提示格式。请记住,它不是对话模型,也未经过指令训练,因此不要期望它生成对话式回复——预训练模型是进一步微调的绝佳平台,但你可能不应直接开箱即用。Chat 模型具有非常简单的对话结构。
System: Add an optional system prompt here
User: This is the user input
Falcon: This is what the model generates
User: This might be a second turn input
Falcon: and so on
Transformers
随着 Transformers 4.33 的发布,你可以使用 Falcon 180B,并利用 HF 生态系统中的所有工具,例如:
- 训练和推理脚本及示例
- 安全的文件格式(safetensors)
- 与 bitsandbytes(4 位量化)、PEFT(参数高效微调)和 GPTQ 等工具的集成
- 辅助生成(也称为“推测性解码”)
- 支持更大上下文长度的 RoPE 缩放
- 丰富而强大的生成参数
使用该模型需要你接受其许可和使用条款。请确保你已登录 Hugging Face 账户,并确保你拥有最新版本的 transformers:
pip install --upgrade transformers
huggingface-cli login
bfloat16
以下是在 bfloat16 中使用基础模型的方法。Falcon 180B 是一个大模型,因此请考虑上表中总结的硬件要求。
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model_id = "tiiuae/falcon-180B"

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    device_map="auto",
)

prompt = "My name is Pedro, I live in"
inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

output = model.generate(
    input_ids=inputs["input_ids"],
    attention_mask=inputs["attention_mask"],
    do_sample=True,
    temperature=0.6,
    top_p=0.9,
    max_new_tokens=50,
)
output = output[0].to("cpu")
print(tokenizer.decode(output))
这可能会产生如下输出:
My name is Pedro, I live in Portugal and I am 25 years old. I am a graphic designer, but I am also passionate about photography and video.
I love to travel and I am always looking for new adventures. I love to meet new people and explore new places.
使用 bitsandbytes 的 8 位和 4 位
Falcon 180B 的 8 位和 4 位量化版本在评估中与 bfloat16 参考相比几乎没有差异!这对推理来说是非常好的消息,因为你可以放心地使用量化版本以降低硬件要求。但请记住,8 位推理比以 4-bit 运行模型快得多。
要使用量化,你需要安装 bitsandbytes 库,并在加载模型时简单地启用相应的标志:
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.bfloat16,
    load_in_8bit=True,
    device_map="auto",
)
Chat 模型
如上所述,经过微调以进行对话的模型版本使用了非常直接的训练模板。我们必须遵循相同的模式才能运行聊天式推理。作为参考,你可以查看 Chat 演示中的 format_prompt 函数,它看起来像这样:
def format_prompt(message, history, system_prompt):
    prompt = ""
    if system_prompt:
        prompt += f"System: {system_prompt}\n"
    for user_prompt, bot_response in history:
        prompt += f"User: {user_prompt}\n"
        prompt += f"Falcon: {bot_response}\n"
        prompt += f"User: {message}\nFalcon:"
    return prompt
如你所见,用户的交互和模型的响应分别以 User: 和 Falcon: 分隔符开头。我们将它们拼接在一起,形成包含整个对话历史的提示。我们可以提供一个系统提示来调整生成风格。
其他资源
致谢
在生态系统中发布这样一个带有支持和评估的模型,离不开许多社区成员的贡献,包括 Clémentine 和 Eleuther Evaluation Harness 在 LLM 评估方面的贡献;Loubna 和 BigCode 在代码评估方面的贡献;Nicolas 在推理支持方面的贡献;Lysandre、Matt、Daniel、Amy、Joao 和 Arthur 将 Falcon 集成到 transformers 中。感谢 Baptiste 和 Patrick 提供的开源演示。感谢 Thom、Lewis、TheBloke、Nouamane、Tim Dettmers 的多项贡献,使这一切得以实现。最后,感谢 HF Cluster 支持运行 LLM 评估,并为该模型的免费开源演示提供推理支持。
来源:Hugging Face:Blog(RSS) · huggingface.co