Code Llama 发布:基于 Llama 2 的代码专用开源模型,Hugging Face 生态全面接入
Code Llama: Llama 2 learns to code
Meta 发布 Code Llama,一组基于 Llama 2 的开源代码模型,含 7B、13B、34B 三种规模及 Python 专用和 instruct 变体,采用 Llama 2 社区许可可商用。
官方完整介绍了模型规格、训练细节和 HF 生态用法,读者可以据此选择版本并直接上手部署。
简介
Code Llama 是一系列先进的、开放获取的 Llama 2 版本,专门针对代码任务进行了优化,我们很高兴在 Hugging Face 生态系统中发布集成!Code Llama 已按照与 Llama 2 相同的宽松社区许可证发布,并可用于商业用途。
今天,我们很高兴发布:
- Hub 上的模型及其模型卡片和许可证
- Transformers 集成
- 与 Text Generation Inference 集成,实现快速高效的生产级推理
- 与 Inference Endpoints 集成
- 与 VS Code 扩展集成
- 代码基准测试
代码大语言模型对软件工程师来说是一项令人兴奋的发展,因为它们可以通过 IDE 中的代码补全来提高生产力,处理编写文档字符串等重复或烦人的任务,或创建单元测试。
目录
什么是 Code Llama?
Code Llama 的发布推出了一系列包含 7、13 和 34 亿参数的模型。基础模型从 Llama 2 初始化,然后在 5000 亿个代码数据 token 上进行训练。Meta 对这些基础模型进行了两种不同风格的微调:Python 专家(额外 1000 亿个 token)和指令微调版本,后者可以理解自然语言指令。
这些模型在 Python、C++、Java、PHP、C#、TypeScript 和 Bash 中展现出最先进的性能。7B 和 13B 的基础版和指令版支持基于周围内容的填充,使其非常适合用作代码助手。
Code Llama 是在 16k 上下文窗口上训练的。此外,三个模型变体还进行了额外的长上下文微调,使它们能够管理高达 100,000 个 token 的上下文窗口。
将 Llama 2 的 4k 上下文窗口增加到 Code Llama 的 16k(可外推至 100k)之所以成为可能,是因为 RoPE 缩放方面的最新进展。社区发现 Llama 的位置嵌入可以线性插值或在频域中插值,这通过微调简化了向更大上下文窗口的过渡。在 Code Llama 的情况下,频域缩放留有余量:微调长度是缩放后预训练长度的一小部分,赋予模型强大的外推能力。
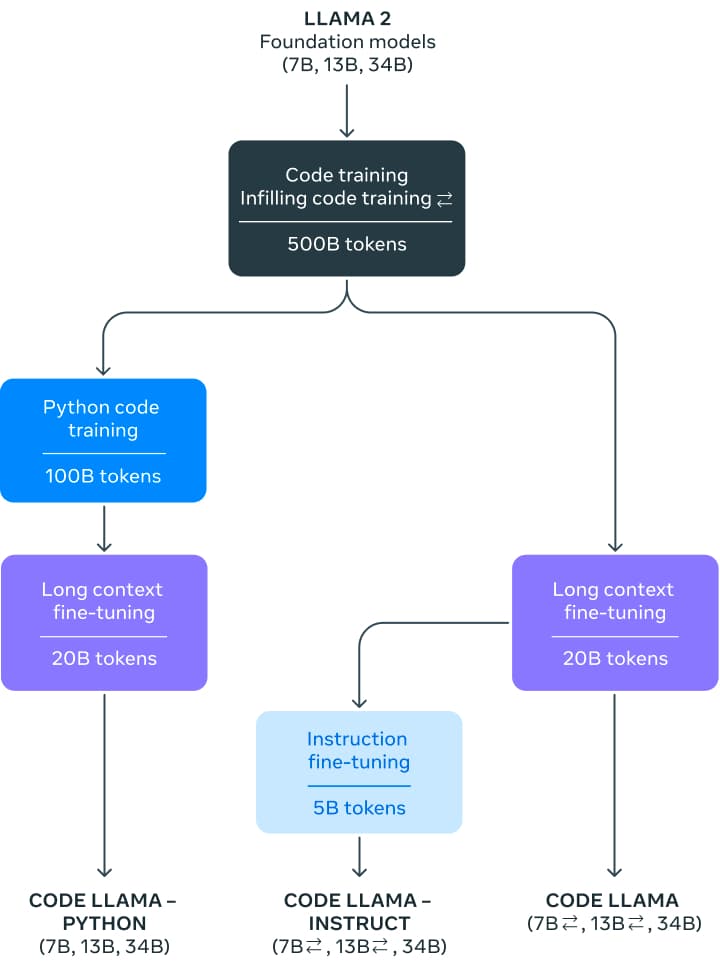
所有模型最初都在近乎去重的公开代码数据集上使用 5000 亿个 token 进行训练。该数据集还包含一些自然语言数据集,例如关于代码的讨论和代码片段。遗憾的是,没有关于该数据集的更多信息。
对于指令模型,他们使用了两个数据集:为 Llama 2 Chat 收集的指令微调数据集和一个自指令数据集。自指令数据集是通过使用 Llama 2 创建面试编程问题,然后使用 Code Llama 生成单元测试和解决方案,之后通过执行测试进行评估而创建的。
如何使用 Code Llama?
Code Llama 已在 Hugging Face 生态系统中提供,从 transformers 4.33 版本开始。
演示
你可以在 这个 Space 中或下方嵌入的 playground 中轻松试用 Code Llama 模型(130 亿参数!)
在底层,这个 playground 使用了 Hugging Face 的 Text Generation Inference,这也是驱动 HuggingChat 的同一技术,我们将在后续章节中分享更多内容。
如果你想试用更大的指令微调 34B 模型,它现在已在 HuggingChat 上可用!你可以在这里试用:hf.co/chat。请确保指定 Code Llama 模型。你也可以查看这个基于聊天的演示并复制它以供自己使用——它是自包含的,因此你可以检查源代码并按需调整!
Transformers
从 transformers 4.33 开始,你可以使用 Code Llama 并利用 HF 生态系统中的所有工具,例如:
- 训练和推理脚本及示例
- 安全的文件格式(
safetensors) - 与
bitsandbytes(4 位量化)和 PEFT(参数高效微调)等工具的集成 - 用于运行模型生成的实用工具和辅助函数
- 导出模型以进行部署的机制
!pip install --upgrade transformers
关于 dtypes 的说明
在使用像 Code Llama 这样的模型时,查看模型的数据类型非常重要。
- 32 位浮点(
float32):PyTorch 在模型初始化时的惯例是以float32加载模型,无论模型权重以何种精度存储。transformers也遵循此惯例以与 PyTorch 保持一致。 - 16 位 Brain 浮点(
bfloat16):Code Llama 以此精度训练,因此我们建议将其用于进一步训练或微调。 - 16 位浮点(
float16):我们建议使用此精度进行推理,因为它通常比bfloat16更快,且评估指标显示相对于bfloat16没有明显退化。你也可以使用bfloat16进行推理,我们建议在微调后检查使用float16和bfloat16的推理结果。
如上所述,transformers 使用 float32 加载权重(无论模型以何种精度存储),因此在加载模型时指定所需的 dtype 非常重要。如果你想微调 Code Llama,建议使用 bfloat16,因为使用 float16 可能导致溢出和 NaN。如果进行推理,我们建议使用 float16,因为 bfloat16 可能更慢。
代码补全
7B 和 13B 模型可用于文本/代码补全或填充。以下代码片段使用 pipeline 接口演示文本补全。只要你选择 GPU 运行时,它就可以在 Colab 的免费层上运行。
from transformers import AutoTokenizer
import transformers
import torch

tokenizer = AutoTokenizer.from_pretrained("codellama/CodeLlama-7b-hf")
pipeline = transformers.pipeline(
    "text-generation",
    model="codellama/CodeLlama-7b-hf",
    torch_dtype=torch.float16,
    device_map="auto",
)

sequences = pipeline(
    'def fibonacci(',
    do_sample=True,
    temperature=0.2,
    top_p=0.9,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
    max_length=100,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
这可能会产生如下输出:
Result: def fibonacci(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1
    else:
        return fibonacci(n-1) + fibonacci(n-2)

def fibonacci_memo(n, memo={}):
    if n == 0:
        return 0
    elif n == 1:
        return
Code Llama 专注于代码理解,但它本身也是一个语言模型。你可以使用相同的生成策略来自动补全注释或一般文本。
代码填充
这是代码模型特有的一项专门任务。模型被训练为生成与现有前缀和后缀最匹配的代码(包括注释)。这是代码助手通常使用的策略:它们被要求填充当前光标位置,考虑其前后出现的内容。
此任务在 7B 和 13B 模型的 base 和 instruction 变体中可用。它不适用于任何 34B 模型或 Python 版本。
要成功使用此功能,你需要密切关注用于训练此任务模型的格式,因为它使用特殊分隔符来标识提示的不同部分。幸运的是,transformers 的 CodeLlamaTokenizer 使这变得非常简单,如下所示:
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model_id = "codellama/CodeLlama-7b-hf"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16
).to("cuda")

prompt = '''def remove_non_ascii(s: str) -> str:
    """ <FILL_ME>
    return result
'''

input_ids = tokenizer(prompt, return_tensors="pt")["input_ids"].to("cuda")
output = model.generate(
    input_ids,
    max_new_tokens=200,
)
output = output[0].to("cpu")

filling = tokenizer.decode(output[input_ids.shape[1]:], skip_special_tokens=True)
print(prompt.replace("<FILL_ME>", filling))
def remove_non_ascii(s: str) -> str:
    """ Remove non-ASCII characters from a string.

    Args:
        s: The string to remove non-ASCII characters from.

    Returns:
        The string with non-ASCII characters removed.
    """
    result = ""
    for c in s:
        if ord(c) < 128:
            result += c
    return result
在底层,分词器 会自动按 <FILL_ME> 拆分,以创建遵循原始训练模式的格式化输入字符串。这比你自己准备模式更稳健:它避免了诸如 token 粘连之类的陷阱,这些陷阱非常难以调试。
对话指令
基础模型可用于补全和填充,如前所述。Code Llama 版本还包括一个指令微调模型,可用于对话界面。
要为该任务准备输入,我们必须使用类似我们 Llama 2 博客文章中描述的提示模板,我们在此再次复现:
<s>[INST] <<SYS>>
{{ system_prompt }}
<</SYS>>

{{ user_msg_1 }} [/INST] {{ model_answer_1 }} </s><s>[INST] {{ user_msg_2 }} [/INST]
请注意,系统提示是可选的——模型在没有它的情况下也能工作,但你可以使用它来进一步配置其行为或风格。例如,如果你总是希望得到 JavaScript 格式的答案,可以在此处说明。在系统提示之后,你需要提供对话中所有之前的交互:用户问了什么以及模型回答了什么。与填充情况一样,你需要注意所使用的分隔符。输入的最后一个组成部分必须始终是新的用户指令,这将是模型提供答案的信号。
以下代码片段演示了该模板在实际中的工作方式。
- 第一个用户查询,无系统提示
user = 'In Bash, how do I list all text files in the current directory (excluding subdirectories) that have been modified in the last month?'

prompt = f"<s>[INST] {user.strip()} [/INST]"
inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=False).to("cuda")
- 第一个用户查询,带系统提示
system = "Provide answers in JavaScript"
user = "Write a function that computes the set of sums of all contiguous sublists of a given list."

prompt = f"<s>[INST] <<SYS>>\\n{system}\\n<</SYS>>\\n\\n{user}[/INST]"
inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=False).to("cuda")
- 包含之前回答的持续对话
过程与 Llama 2 中相同。为了最大程度清晰,我们没有使用循环或泛化此示例代码:
system = "System prompt"
user_1 = "user_prompt_1"
answer_1 = "answer_1"
user_2 = "user_prompt_2"
answer_2 = "answer_2"
user_3 = "user_prompt_3"

prompt  = f"<<SYS>>\n{system}\n<</SYS>>\n\n{user_1}"
prompt  = f"<s>[INST] {prompt.strip()} [/INST] {answer_1.strip()} </s>"
prompt += f"<s>[INST] {user_2.strip()} [/INST] {answer_2.strip()} </s>"
prompt += f"<s>[INST] {user_3.strip()} [/INST]"

inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=False).to("cuda")
4 位加载
将 Code Llama 集成到 Transformers 中意味着你可以立即获得对 4 位加载等高级功能的支持。这使你能够在消费级 GPU(如 NVIDIA 3090 显卡)上运行大型 32B 参数模型!
以下是如何在 4 位模式下运行推理:
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import torch

model_id = "codellama/CodeLlama-34b-hf"
quantization_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_compute_dtype=torch.float16
)

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=quantization_config,
    device_map="auto",
)

prompt = 'def remove_non_ascii(s: str) -> str:\n    """ '
inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

output = model.generate(
    inputs["input_ids"],
    max_new_tokens=200,
    do_sample=True,
    top_p=0.9,
    temperature=0.1,
)
output = output[0].to("cpu")
print(tokenizer.decode(output))
使用 text-generation-inference 和 Inference Endpoints
Text Generation Inference 是 Hugging Face 开发的生产级推理容器,可轻松部署大型语言模型。它具有连续批处理、token 流式传输、用于多 GPU 快速推理的张量并行以及生产级日志记录和追踪等功能。
你可以在自己的基础设施上试用 Text Generation Inference,也可以使用 Hugging Face 的 Inference Endpoints。要部署 Codellama 2 模型,请转到 模型页面 并点击 Deploy -> Inference Endpoints 小部件。
- 对于 7B 模型,我们建议你选择“GPU [medium] - 1x Nvidia A10G”。
- 对于 13B 模型,我们建议你选择“GPU [xlarge] - 1x Nvidia A100”。
- 对于 34B 模型,我们建议你选择启用
bitsandbytes量化的“GPU [1xlarge] - 1x Nvidia A100”,或“GPU [2xlarge] - 2x Nvidia A100”
注意:你可能需要通过电子邮件向 api-enterprise@huggingface.co 请求配额升级,以访问 A100
你可以在我们的博客中了解更多关于如何使用 Hugging Face Inference Endpoints 部署 LLM 的信息。该 博客 包含有关支持的超参数以及如何使用 Python 和 Javascript 流式传输响应的信息。
使用 VS Code 扩展
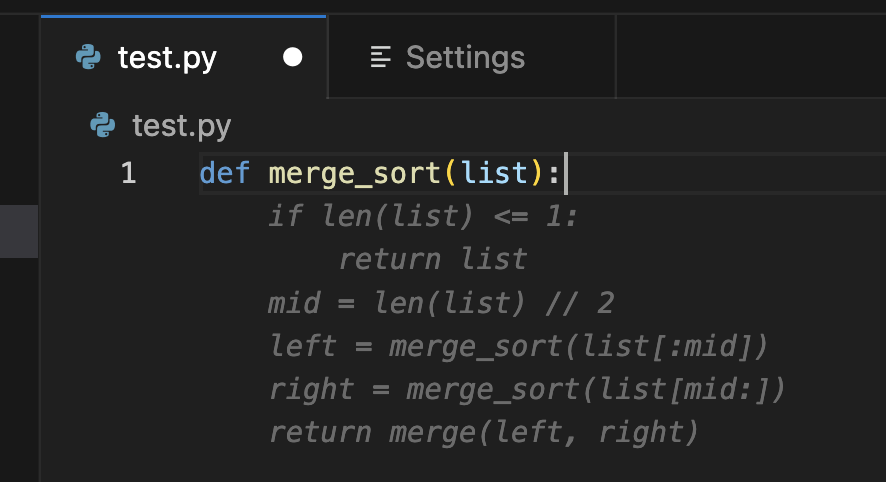
HF Code Autocomplete 是一个用于测试开源代码补全模型的 VS Code 扩展。该扩展是作为 StarCoder 项目的一部分开发的,并已更新以支持中等规模的基座模型 Code Llama 13B。在此处了解更多关于如何安装并使用 Code Llama 运行该扩展的信息。
评估
代码语言模型通常在 HumanEval 等数据集上进行基准测试。它由编程挑战组成,其中向模型提供函数签名和文档字符串,并要求其补全函数体。然后通过运行一组预定义的单元测试来验证所提出的解决方案。最后,报告通过率,描述有多少解决方案通过了所有测试。pass@1 率描述模型在一次尝试中生成通过解决方案的频率,而 pass@10 描述在 10 个候选方案中至少有一个通过的频率。
虽然 HumanEval 是一个 Python 基准测试,但已有大量工作将其翻译为更多编程语言,从而实现更全面的评估。其中一种方法是 MultiPL-E,它将 HumanEval 翻译为十多种语言。我们基于它托管了一个多语言代码排行榜,让社区可以比较不同语言的模型,以评估哪个模型最适合他们的用例。
| 模型 | 许可证 | 数据集已知 | 商业使用? | 预训练长度 [tokens] | Python | JavaScript | 排行榜平均得分 |
|---|---|---|---|---|---|---|---|
| CodeLlaMa-34B | Llama 2 许可证 | ❌ | ✅ | 2,500B | 45.11 | 41.66 | 33.89 |
| CodeLlaMa-13B | Llama 2 许可证 | ❌ | ✅ | 2,500B | 35.07 | 38.26 | 28.35 |
| CodeLlaMa-7B | Llama 2 许可证 | ❌ | ✅ | 2,500B | 29.98 | 31.8 | 24.36 |
| CodeLlaMa-34B-Python | Llama 2 许可证 | ❌ | ✅ | 2,620B | 53.29 | 44.72 | 33.87 |
| CodeLlaMa-13B-Python | Llama 2 许可证 | ❌ | ✅ | 2,620B | 42.89 | 40.66 | 28.67 |
| CodeLlaMa-7B-Python | Llama 2 许可证 | ❌ | ✅ | 2,620B | 40.48 | 36.34 | 23.5 |
| CodeLlaMa-34B-Instruct | Llama 2 许可证 | ❌ | ✅ | 2,620B | 50.79 | 45.85 | 35.09 |
| CodeLlaMa-13B-Instruct | Llama 2 许可证 | ❌ | ✅ | 2,620B | 50.6 | 40.91 | 31.29 |
| CodeLlaMa-7B-Instruct | Llama 2 许可证 | ❌ | ✅ | 2,620B | 45.65 | 33.11 | 26.45 |
| StarCoder-15B | BigCode-OpenRail-M | ✅ | ✅ | 1,035B | 33.57 | 30.79 | 22.74 |
| StarCoderBase-15B | BigCode-OpenRail-M | ✅ | ✅ | 1,000B | 30.35 | 31.7 | 22.4 |
| WizardCoder-15B | BigCode-OpenRail-M | ❌ | ✅ | 1,035B | 58.12 | 41.91 | 32.07 |
| OctoCoder-15B | BigCode-OpenRail-M | ✅ | ✅ | 1,000B | 45.3 | 32.8 | 24.01 |
| CodeGeeX-2-6B | CodeGeeX 许可证 | ❌ | ❌ | 2,000B | 33.49 | 29.9 | 21.23 |
| CodeGen-2.5-7B-Mono | Apache-2.0 | ✅ | ✅ | 1400B | 45.65 | 23.22 | 12.1 |
| CodeGen-2.5-7B-Multi | Apache-2.0 | ✅ | ✅ | 1400B | 28.7 | 26.27 | 20.04 |
注意:上表中的分数来自发布时的代码排行榜。分数会随着新模型的发布而变化,因为模型之间会相互比较。更多详情,请参阅排行榜。
其他资源
来源:Hugging Face:Blog(RSS) · huggingface.co