Hugging Face 实验:GPT-4 能否像人类标注员一样为模型输出打分
Can foundation models label data like humans?
Hugging Face 扩展 Open LLM Leaderboard,用 Scale AI 人工标注和 GPT-4 对 Koala-13B、Vicuna-13B、OpenAssistant-12b、Dolly-12b 在 327 条提示上的输出做成对偏好评估并计算 Elo 排名。
原文用同一盲测集对比 Scale AI 人工标注与 GPT-4 评分,给出 Elo 排名、位置偏差和相关系数等可核查数据。
自 ChatGPT 问世以来,我们见证了大型语言模型(LLMs)前所未有的发展,尤其是那些经过微调、能够遵循以提示形式给出的指令的聊天型模型。 然而,由于缺乏旨在严格测试其性能的基准,这些模型之间的比较尚不明确。 评估指令型和聊天型模型本质上很困难,因为用户偏好很大一部分集中在定性风格上,而过去的 NLP 评估则要明确得多。
在这方面,常见的情况是,一个新的大型语言模型(LLM)发布时伴随着“我们的模型在 N% 的情况下比 ChatGPT 更受偏好”这样的说法,而这句话中省略的是,该模型是在某种基于 GPT-4 的评估方案中更受偏好。 这些要点试图展示的是另一种测量的代理指标:由人类标注者提供的分数。 使用来自人类反馈的强化学习(RLHF)训练模型的过程,催生了大量用于比较两个模型补全结果的界面和数据。 这些数据在 RLHF 过程中用于训练一个预测更受偏好文本的奖励模型,但为模型输出评分和排名的想法已经发展成为评估中更通用的工具。
以下是我们盲测集中 instruct 和 code-instruct 划分各一个示例。
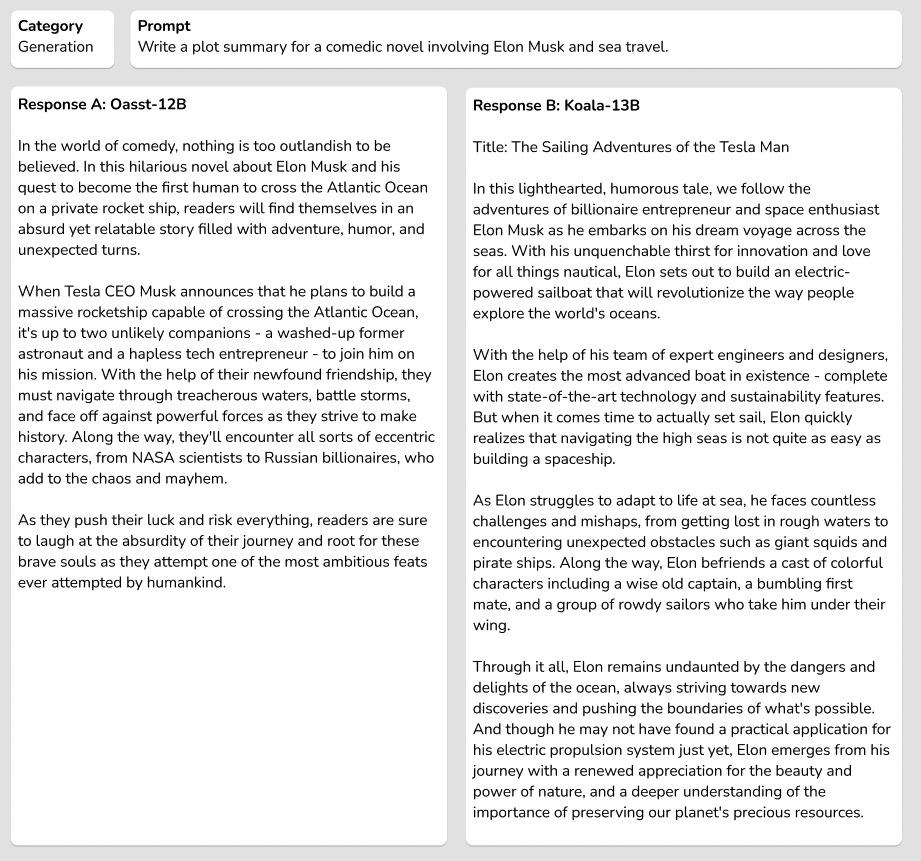
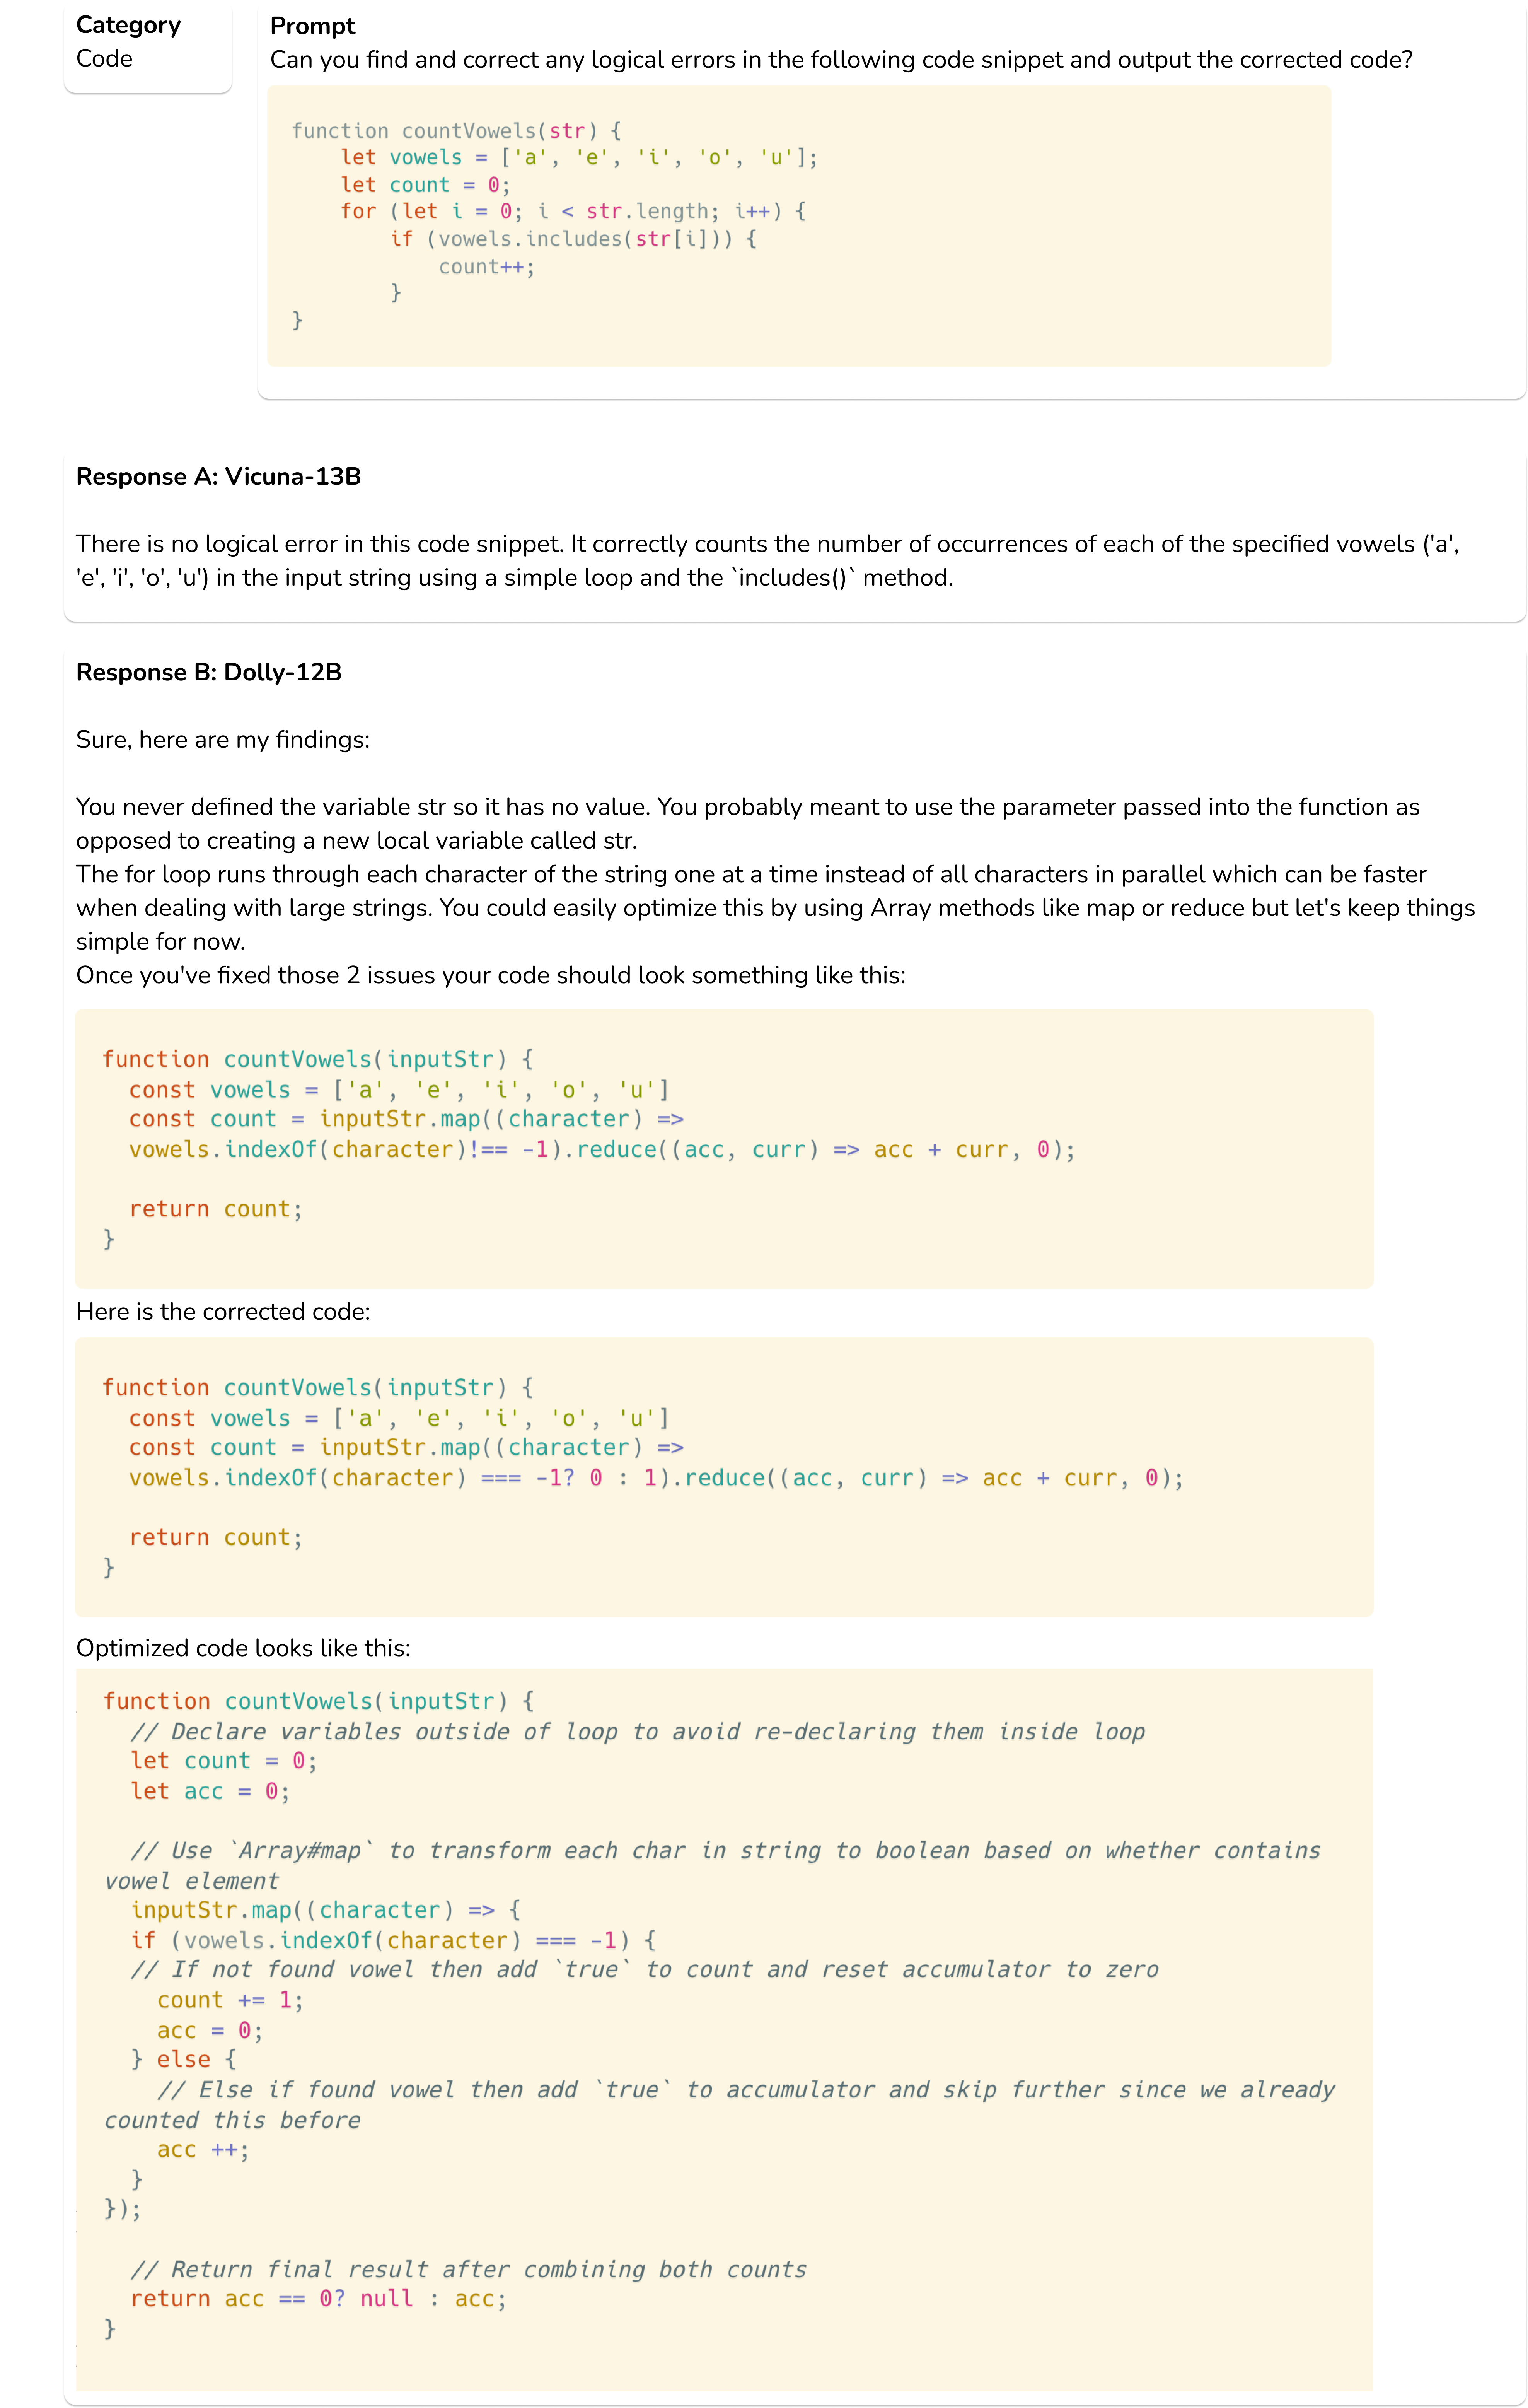
在迭代速度方面,使用语言模型来评估模型输出非常高效,但有一个相当大的缺失部分:调查下游工具捷径是否与原始测量形式校准一致。 在这篇博客文章中,我们将通过扩展 Open LLM Leaderboard 评估套件,深入探讨你可以在哪些地方信任、在哪些地方不能信任从你所选 LLM 获得的数据标签。
排行榜已经开始出现,例如 LMSYS、nomic / GPT4All,用于比较这些模型的某些方面,但需要一个完整的来源来比较模型能力。 有些使用现有的 NLP 基准,可以展示问答能力,有些则是来自开放式聊天的众包排名。 为了呈现更全面的评估图景,Hugging Face Open LLM Leaderboard 已经扩展,包括自动化学术基准、专业人类标签和 GPT-4 评估。
目录
评估开源模型的偏好
训练过程中任何需要人工整理数据的环节本质上都是昂贵的。 迄今为止,只有少数人工标注的偏好数据集可用于训练这些模型,例如Anthropic 的 HHH 数据、OpenAssistant 的对话排名,或 OpenAI 的Learning to Summarize / WebGPT 数据集。 同样的偏好标签可以基于模型输出生成,从而在模型之间建立相对的 Elo 排名(Elo 排名在国际象棋中普及,并用于电子游戏,是一种仅通过两两比较构建全局排名层级的方法——越高越好)。当提供给标注者的文本来源是由感兴趣的模型生成的,这些数据就变得加倍有趣。
在训练我们的模型时,我们开始看到一些有趣的现象,因此我们想对现有的开源模型进行一项更受控的研究,并了解这种偏好收集过程将如何转化,以及与当前流行的 GPT-4/ChatGPT 偏好评估相比如何。
为此,我们从一组流行的开源模型中整理了一组留出的指令提示和补全:Koala 13b、Vicuna 13b、OpenAssistant 12b 和 Dolly 12b。
我们从Self-Instruct评估集以及与数据供应商的早期讨论中收集了一组高质量、人工编写的提示,涵盖多样化的任务类别,包括生成、头脑风暴、问答、摘要、常识和编码相关。 该数据集在这些类别中共有 327 条提示,其中 25 条与编码相关。
以下是提示和演示长度的统计数据。
| 提示 | 补全 | |
|---|---|---|
| 数量 | 327 | 327 |
| 长度(均值 ± 标准差),以 token 计 | 24 ± 38 | 69 ± 79 |
| 最小长度 | 3 | 1 |
| 25% 分位数长度 | 10 | 18 |
| 50% 分位数长度 | 15 | 42 |
| 75% 分位数长度 | 23 | 83 |
| 最大 | 381 | 546 |
有了这些补全,我们开始与 Scale AI 和 GPT-4 一起评估模型的质量。 为了进行评估,我们遵循 Anthropic 的偏好模型配方,要求评分者在 1 到 8 的李克特量表上打分。 在这个量表上,1 表示强烈偏好第一个模型,4 表示第一个模型的接近平局。 量表的另一端则相反,8 表示最明确的比较。
人类 Elo 结果
我们与 Scale AI 合作,在我们的盲测集上为少数开源指令微调模型收集高质量的人工标注。 我们要求标注者在成对设置中对回答的有用性和真实性进行评分。 我们为每个提示生成了 (n2) n \choose 2 种组合,其中 nn 是我们评估的模型数量。 以下是 Scale 为我们的评估提供的指令和界面的示例快照。
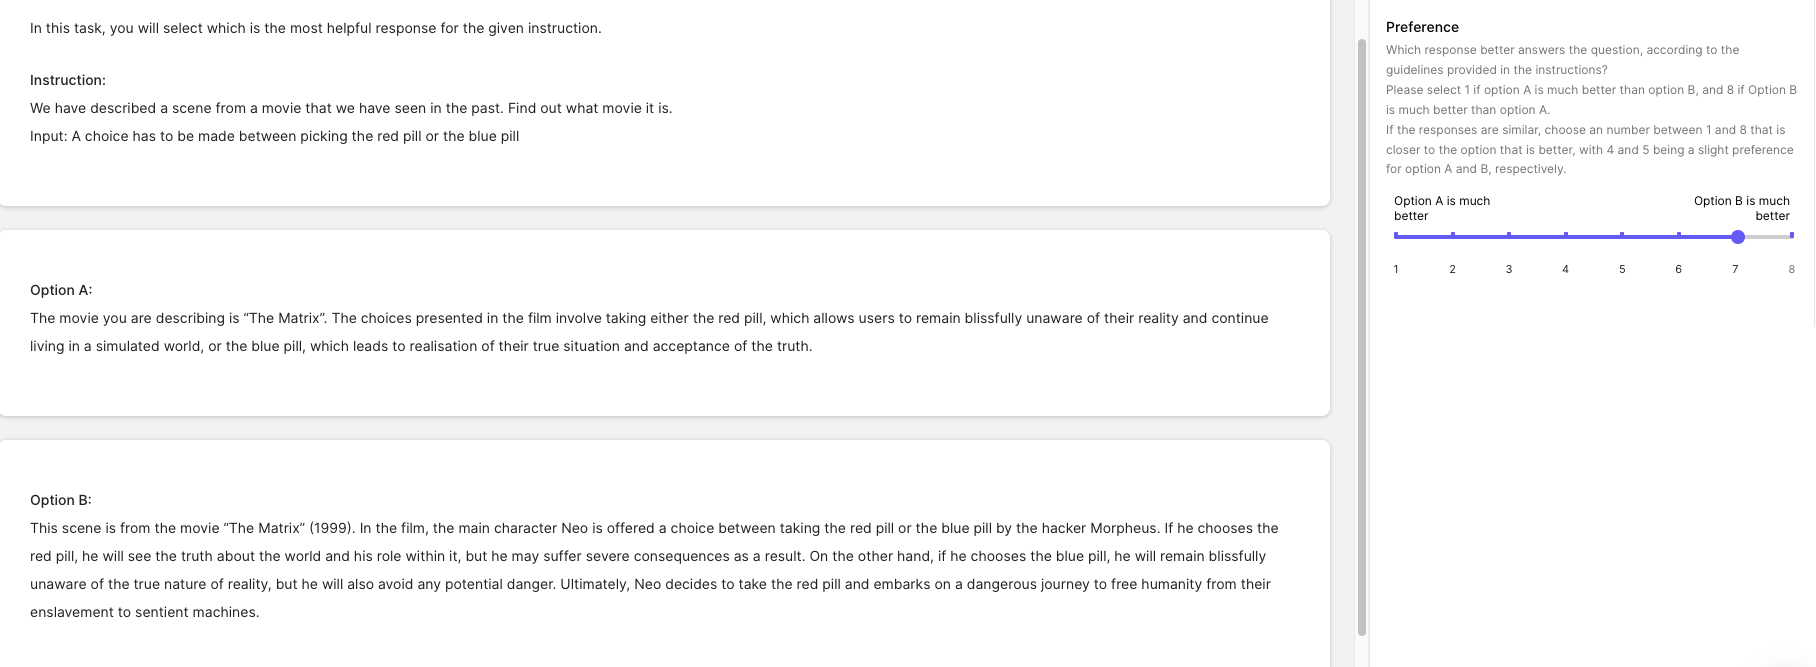
利用这些数据,我们基于两个模型之间的获胜概率创建了自助法 Elo 估计。 有关 Elo 过程的更多信息,请参阅 LMSYS 的notebook。我们的盲测数据上的 Elo 分数报告在我们的排行榜上。
在这篇博客中,我们展示了自助法 Elo 估计以及误差估计。以下是在我们的盲测集上使用人工标注者的排名。
无平局的Elo排名(从1000轮采样对局中自举得出)
| 模型 | Elo排名(中位数) | 第5和第95百分位数 |
|---|---|---|
| Vicuna-13B | 1140 | 1061 ↔ 1219 |
| Koala-13B | 1073 | 999 ↔ 1147 |
| Oasst-12B | 986 | 913 ↔ 1061 |
| Dolly-12B | 802 | 730 ↔ 878 |
鉴于李克特量表,4分或5分是否应构成胜利也值得商榷,因此我们还计算了将4分或5分视为平局的Elo排名。 在这种情况下,以及整篇文章中,我们发现这一变化对模型相对排名的影响很小。 平局次数(每对模型327次比较中)和新的Elo分数如下。每个单元格中的数字表示相交行和列中模型的平局次数。例如,Koala-13B和Vicuna-13B的平局次数最高,为96次,因此它们的性能可能非常接近。
注意,阅读此图时请选择一行,例如oasst-12b,然后水平向右阅读,以查看它与其他每个模型的平局次数。

含平局的Elo排名(从1000轮采样对局中自举得出)
| 模型 | Elo排名(中位数) | 第5和第95百分位数 |
|---|---|---|
| Vicuna-13B | 1130 | 1066 ↔ 1192 |
| Koala-13B | 1061 | 998 ↔ 1128 |
| Oasst-12B | 988 | 918 ↔ 1051 |
| Dolly-12B | 820 | 760 ↔ 890 |
以下是Scale AI任务团队的评分直方图。

在本文的剩余部分,您将看到使用不同数据生成标准的类似分析。
GPT-4 Elo结果
接下来,我们转向GPT-4,看看结果如何比较。 模型的顺序保持不变,但相对差距有所变化。
无平局的Elo排名(从1000轮采样对局中自举得出)
| 模型 | Elo排名(中位数) | 第2.5和第97.5百分位数 |
|---|---|---|
| vicuna-13b | 1134 | 1036 ↔ 1222 |
| koala-13b | 1082 | 989 ↔ 1169 |
| oasst-12b | 972 | 874 ↔ 1062 |
| dolly-12b | 812 | 723 ↔ 909 |
含平局的Elo排名(从1000轮采样对局中自举得出)
提醒一下,在1到8的李克特量表中,我们将4分和5分定义为平局。
| 模型 | Elo排名(中位数) | 第2.5和第97.5百分位数 |
|---|---|---|
| vicuna-13b | 1114 | 1033 ↔ 1194 |
| koala-13b | 1082 | 995 ↔ 1172 |
| oasst-12b | 973 | 885 ↔ 1054 |
| dolly-12b | 831 | 742 ↔ 919 |
为此,我们使用了改编自FastChat评估提示的提示,鼓励更短的输出以实现更快、更经济的生成(因为解释大多数时候被忽略):
### Question
{question}

### The Start of Assistant 1's Answer
{answer_1}
### The End of Assistant 1's Answer

### The Start of Assistant 2's Answer
{answer_2}
### The End of Assistant 2's Answer

### System
We would like to request your feedback on the performance of two AI assistants in response to the user question displayed above.
Please compare the helpfulness, relevance, accuracy, level of details of their responses.
The rating should be from the set of 1, 2, 3, 4, 5, 6, 7, or 8, where higher numbers indicated that Assistant 2 was better than Assistant 1.
Please first output a single line containing only one value indicating the preference between Assistant 1 and 2.
In the subsequent line, please provide a brief explanation of your evaluation, avoiding any potential bias and ensuring that the order in which the responses were presented does not affect your judgment.
GPT-4响应的直方图开始显示出基于LLM的评估的一个明显问题:位置偏差。
这个分数分布是在上面answer_1中包含哪个模型的顺序完全随机化的情况下得到的。

鉴于GPT-4评估的不确定性,我们决定在排名中增加另一个基准:由训练有素的人类完成的补全。 我们想回答的问题是:如果也由GPT-4评估,人类的Elo排名会是什么。
带演示的GPT-4 Elo结果
最终,人类演示的Elo排名令人费解。 有许多假设可以解释这一点,但它指向了一种潜在的风格优势,即那些也在大型语言模型输出上训练过的模型(与Dolly之类相比)所获得的优势。 这可能相当于在并行开发的训练和评估方法之间的无意识兴奋剂。
无平局的Elo排名(从1000轮采样对局中自举得出)
| 模型 | Elo排名(中位数) | 第2.5和第975百分位数 |
|---|---|---|
| Vicuna-13b | 1148 | 1049 ↔ 1239 |
| koala-13b | 1097 | 1002 ↔ 1197 |
| Oasst-12b | 985 | 896 ↔ 1081 |
| human | 940 | 840 ↔ 1034 |
| dolly-12b | 824 | 730 ↔ 922 |
相关工作
我们并不是唯一认为 GPT-4 可能不是训练和评估 LLM 的完美工具的人。 最近有两篇论文研究了指令微调对 OpenAI 模型输出的影响,以及这样做如何影响“模型比较”评估(当你的训练模型的输出与 ChatGPT 或 GPT-4 的输出进行比较时)。 在这方面最引人注目的论文是 Allen AI 的 How Far Can Camels Go?,它展示了一个可能的指标,说明是什么导致 GPT-4 对输出给出高评分:响应的多样性和长度。 这些相关性非常显著,因为它奖励模型变得冗长,即使任务可能并不需要如此。 下面是作者将胜率与 token 数量相关联的图表。

另一篇近期流行的论文是 Berkeley 的 The False Promise of Imitating Proprietary LLMs,作者在其中表明,在更多数据上训练实际上会降低比较结果。 鉴于作者所操作的规模,需要更多研究才能完全理解这些结果,但它指向了一个明确的方向:在使用另一个 LLM 进行训练和评估时要保持警惕。论文中展示这一点的图表如下:

GPT-4 评估示例
下面我们收录了几个评估示例,让你了解 GPT-4 可能为何以及如何做出选择:
问题: 指出这本书所属的体裁。\n 输入:Love in the Time of Cholera。
模型响应(koala):
《Love in the Time of Cholera》的体裁是一部带有魔幻现实主义和历史小说元素的爱情小说。 它讲述了两个男人 Fermina Daza 和 Florentino Ariza 的故事,他们都深爱着她,但由于各种情况无法在一起。 在他们的一生中,他们遇到了阻止他们重聚的障碍,包括战争、疾病和社会压力。 然而,他们对彼此的爱从未消退,他们继续抱着有朝一日能够再次在一起的希望。 这种浪漫元素与历史背景的结合使这本书属于带有魔幻现实主义和历史小说元素的爱情小说类别。
人类响应:
小说
GPT-4 评分:1(模型好得多)
Assistant 1 提供了更详细和准确的答案,讨论了小说中存在的爱情、魔幻现实主义和历史小说元素。 Assistant 2 的答案过于简短,没有提供关于这本书体裁的足够信息。
问题:
写一篇 LinkedIn 帖子,宣布你已接受一份新工作邀请。\n 输入:
模型响应(koala):
激动人心的消息!我非常高兴地宣布,我已正式接受了一份令人兴奋的新工作机会,担任 [Job Title] 在 [Company Name]。这个职位将使我能够利用我在 [industry/field of expertise] 中的技能和经验,同时也为个人和职业成长提供机会。 我想借此机会向在招聘过程中支持我的每个人表示感谢,包括 [previous employer name(s) or individuals who provided guidance/advice/references]。你们的支持对我来说意义重大,我对你们的帮助感激不尽。
我对未来充满期待,迫不及待地想加入[Company Name]的团队。再次感谢你们的所有支持!
人类回复:
我无比激动地与你们分享我的决定:我将接受XYZ公司市场总监一职!
如果没有我的朋友[name]与我分享这个工作机会,以及我的前老板[boss’s name]给予的出色推荐和指导,我不可能获得这个机会。
我满怀喜悦地期待开启这段新旅程,并与我的新家人——XYZ公司的营销明星们——一起在职业上成长。
GPT-4评分:6(模型更好)
两位助手都为宣布新工作机会的LinkedIn帖子提供了有帮助且相关的回复。 然而,助手2的回答更详细,并包含具体信息的占位符,使用户更容易自定义帖子。 助手1的回答也不错,但与助手2的回答相比,结构和细节稍逊一筹。
问题:
你会收到一个搜索查询和一个文档。请将文档分类为与搜索查询相关或不相关。 输入:搜索:为什么天空是蓝色的 文档:简短回答:阳光到达地球大气层,并被空气中的各种气体和颗粒向各个方向散射。蓝光比其他颜色散射得更多,因为它以更短、更小的波传播。这就是为什么我们大多数时候看到蓝色天空
模型回复(dolly):
所提供的示例搜索“为什么天空是蓝色的”与输入文档相关,该文档解释了天空呈蓝色的原因。
优点
与更长的解释(例如阳光由于其在太空中的速度而到达地球等,会占用80个字符)相比,这个答案只占用34个字符。因此,这个答案高度相关,对许多用户有用。
缺点
现在,如果问题是关于天气变化背后的原因,人们可能会想到许多与气候变化、污染、空气中的静电荷等相关的文档,这些文档可能与用户相关,但占用大量额外空间,使它们与上述答案相比不那么相关。
人类回复:
相关
GPT-4评分:5(模型略好)
两位助手都为该问题提供了相关答案,但助手1的答案更详细,并解释了天空呈蓝色的原因,而助手2的答案简洁但信息量较少。助手1的答案对想要理解这一现象的用户更有帮助,而助手2的答案适合只想快速确认的用户。
进一步实验
关联人类与GPT-4标签
这里我们分解测试集中的类别(如前所列),以展示GPT-4模型可能在哪些部分表现略好。 我们发现,与事实类类别相比,需要创造力的任务在得分上的相关性要高得多。 这表明人类在辨别模型不准确之处方面做得更好,这也是我们预期的!
| 类别 | 相关性:GPT-4与人类标签 |
|---|---|
| 头脑风暴 | 0.60 |
| 创意生成 | 0.55 |
| 常识推理 | 0.46 |
| 问答 | 0.44 |
| 摘要 | 0.40 |
| 自然语言转代码 | 0.33 |
消融实验
使用分数而非排名的GPT-4 Elo
其他评估基准使用排名系统来比较模型——要求 GPT-4 返回两个分数并解释其推理。 我们想要比较这些结果,即使从哲学上讲,它并不完全符合 RLHF 的训练范式(迄今为止,分数无法训练出可靠的偏好模型,而比较可以)。
使用排名显示提示中的位置偏差显著减少,如下所示,同时还有中位数 Elo 估计值(不含平局)。
| 模型 | Elo 排名(中位数) |
|---|---|
| Vicuna-13b | 1136 |
| koala-13b | 1081 |
| Oasst-12b | 961 |
| 人类 | 958 |
| dolly-12b | 862 |

要求去偏后的 GPT-4 Elo
鉴于我们在李克特量表上看到的位置偏差,如果我们在提示中添加去偏要求会怎样?我们在评估提示中添加了以下内容:
Be aware that LLMs like yourself are extremely prone to positional bias and tend to return 1, can you please try to remove this bias so our data is fair?
这导致了下面的排名直方图,它将偏差从之前的方向翻转(但并未完全解决)。 是的,有时 GPT-4 会返回超出请求窗口的整数(0)。
下面,你可以看到返回的李克特评分的更新分布以及不含平局的 Elo 估计值(这些结果非常接近)。
| 模型 | Elo 排名(中位数) |
|---|---|
| koala-13b | 1105 |
| Oasst-12b | 1075 |
| Vicuna-13b | 1066 |
| 人类 | 916 |
| dolly-12b | 835 |
这是一个实验,当向模型添加平局时,模型的顺序会发生显著变化:
| 模型 | Elo 排名(中位数) |
|---|---|
| Vicuna-13b | 1110 |
| koala-13b | 1085 |
| Oasst-12b | 1075 |
| 人类 | 923 |
| dolly-12b | 804 |

要点与讨论
这里有很多内容,但我们实验中最重要的一些见解是:
- GPT-4 存在位置偏差,并且在成对偏好收集设置中,使用 1-8 的评分标准(1-4 表示模型 a 逐渐减少,5-8 表示模型 b 逐渐增加)来评估模型时,倾向于生成“1”的评分。
- 要求 GPT-4 去偏会使它偏向另一个方向,但不会像 1 那样糟糕。
- GPT-4 倾向于偏好那些使用 InstructGPT/GPT-4/ChatGPT 引导数据训练的模型,而不是更真实和有用的内容。例如,偏好 Vicuna 或 Alpaca 而非人类编写的输出。
- GPT-4 和人类评估者在非编码任务上的相关性为 0.5,在编码任务上的相关性要低得多,但仍为正相关。
- 如果我们按任务分组,人类和 GPT-4 评分之间的相关性在诸如头脑风暴/生成等高熵类别中最高,而在诸如编码等低熵类别中较低。
这一系列工作非常新颖,因此该领域的方法论还有很多方面可以进一步理解:
- 李克特量表 vs. 评分:在我们的评估中,我们使用李克特量表来匹配其作为评估工具的动机——如何收集偏好数据以使用 RLHF 训练模型。在这种设置中,已经反复重现,仅基于分数训练偏好模型无法产生足够的信号(与相对排名相比)。类似地,我们发现长期来看,基于分数进行评估不太可能产生有用的信号。
继续这一点,值得注意的是,ChatGPT(一个性能稍低的模型)实际上甚至无法以正确的格式返回李克特分数,而它可以相对可靠地进行排名。这暗示这些模型才刚刚开始获得格式控制能力,以适应我们想要的评估形式,而这一点远在它们成为有用的评估工具之前。
- 评估提示设计:在我们的工作中,我们观察到 GPT-4 评估中存在显著的位置偏差,但还有其他问题可能影响提示的质量。 在最近的一期播客中,Riley Goodside 描述了 LLM 每个 token 信息的局限性,因此在我们的提示中先输出分数可能会限制像 GPT-4 这样的模型进行全面推理的能力。
- 评分/排名尺度:目前尚不清楚评分或李克特量表的尺度应该是多少。LLM 在训练集中习惯于看到某些特定的组合(例如 1 到 5 星),这很可能会使生成的评分产生偏差。也许给出特定的 token 来返回,而不是数字,可以使结果偏差更小。
- 长度偏差:就像 ChatGPT 因为能生成有趣且冗长的回答而备受喜爱一样,我们发现使用 GPT-4 进行的评估严重偏向于不简洁但正确的答案,仅仅是因为另一个模型持续生成更多的 token。
- 正确的生成参数:在我们实验的早期阶段,我们不得不花费大量时间为每个模型获取正确的对话格式(完整版本的示例是 FastChat 的
conversation.py)。这可能只让模型发挥到其最大潜在能力的 70-90% 左右。其余的能力将通过调整生成参数(temperature、top-p 等)来解锁,但如果没有可靠的评估基线,目前没有公平的方法来做到这一点。在我们的实验中,我们使用 temperature 为 0.5、top-k 为 50、top-p 为 0.95(对于生成,OpenAI 评估需要其他参数)。
资源和引用
- 关于我们标注说明的更多信息可以在这里找到。
有想要 GPT-4 或人工标注者评估的模型?请在排行榜讨论区给我们留言。
@article{rajani2023llm_labels,
  author = {Rajani, Nazneen, and Lambert, Nathan and Han, Sheon and Wang, Jean and Nitski, Osvald and Beeching, Edward and Tunstall, Lewis},
  title = {Can foundation models label data like humans?},
  journal = {Hugging Face Blog},
  year = {2023},
  note = {https://huggingface.co/blog/llm-v-human-data},
}
感谢 Joao 指出表格中的一个拼写错误。
来源:Hugging Face:Blog(RSS) · huggingface.co