Hugging Face 介绍 DeDLOC 协同训练方法并用 40 名志愿者预训练 sahajBERT
Deep Learning over the Internet: Training Language Models Collaboratively
Hugging Face 联合 Yandex Research 等机构介绍 DeDLOC 协同分布式训练方法,可自适应参与者的网络与硬件限制,并用 40 名志愿者通过互联网协同预训练了孟加拉语模型 sahajBERT。
原文给出 DeDLOC 协同训练方法与 sahajBERT 实测结果,读者可据此评估用志愿者算力预训练语言模型的可行性。
在 Quentin Lhoest 和 Sylvain Lesage 的额外帮助下。
现代语言模型通常需要大量计算资源进行预训练,如果没有数十甚至数百个 GPU 或 TPU,几乎不可能获得这些模型。虽然理论上可以整合多个个体的资源,但在实践中,这种分布式训练方法此前收效甚微,因为互联网上的连接速度远慢于高性能 GPU 超级计算机。
在这篇博客文章中,我们介绍了 DeDLOC——一种新的协作式分布式训练方法,它能够根据参与者的网络和硬件限制进行自适应调整。我们展示了该方法在现实场景中的成功应用:通过 40 名志愿者预训练了 sahajBERT,一个孟加拉语模型。在孟加拉语的下游任务上,该模型达到了接近最先进的质量,其结果可与使用数百个高端加速器训练的更大模型相媲美。
开放协作中的分布式深度学习
我们为什么要这样做?
如今,许多最高质量的 NLP 系统都基于大型预训练 Transformer。一般来说,它们的质量随规模提升:通过扩大参数数量并利用丰富的无标注文本数据,你可以在自然语言理解和生成方面取得无与伦比的结果。
不幸的是,我们使用这些预训练模型并不仅仅是因为方便。在大规模数据集上训练 Transformer 所需的硬件资源往往超出个人甚至大多数商业或研究机构的承受能力。以 BERT 为例:其训练成本估计约为 7,000 美元,而对于像 GPT-3 这样最大的模型,这个数字可能高达 1,200 万美元!这种资源限制看似显而易见且不可避免,但对于更广泛的机器学习社区来说,真的没有替代预训练模型的方法吗?
然而,这种情况或许有出路:要找到解决方案,我们只需环顾四周。也许我们正在寻找的计算资源已经存在;例如,我们许多人家里都有配备游戏或工作站 GPU 的强大计算机。你可能已经猜到,我们将像 Folding@home、Rosetta@home、Leela Chess Zero 或不同的 BOINC 项目那样联合它们的力量,这些项目利用志愿者计算,但我们的方法更为通用。例如,几个实验室可以联合他们较小的集群以利用所有可用资源,有些人可能想使用廉价的云实例加入实验。
对于持怀疑态度的人来说,这里似乎缺少一个关键因素:分布式深度学习中的数据传输往往是一个瓶颈,因为我们需要聚合来自多个工作节点的梯度。确实,任何在互联网上进行分布式训练的朴素方法都注定失败,因为大多数参与者没有千兆连接,并且可能随时断开网络。那么,用家庭数据套餐到底怎么能训练任何东西呢?:)
作为这个问题的解决方案,我们提出了一种新的训练算法,称为开放协作中的分布式深度学习(或DeDLOC),该算法在我们最近发布的预印本中有详细描述。现在,让我们来了解一下这个算法背后的核心思想!
与志愿者一起训练
在其最常用的版本中,使用多个 GPU 的分布式训练非常简单直接。回想一下,在进行深度学习时,你通常会计算损失函数的梯度,这些梯度是在一批训练数据中的许多样本上平均得到的。在数据并行分布式深度学习中,你只需将数据拆分到多个工作节点上,分别计算梯度,然后在处理完本地批次后对它们进行平均。当所有工作节点上的平均梯度计算完成后,我们使用优化器调整模型权重,并继续训练我们的模型。你可以在下面看到所执行的不同任务的图示。
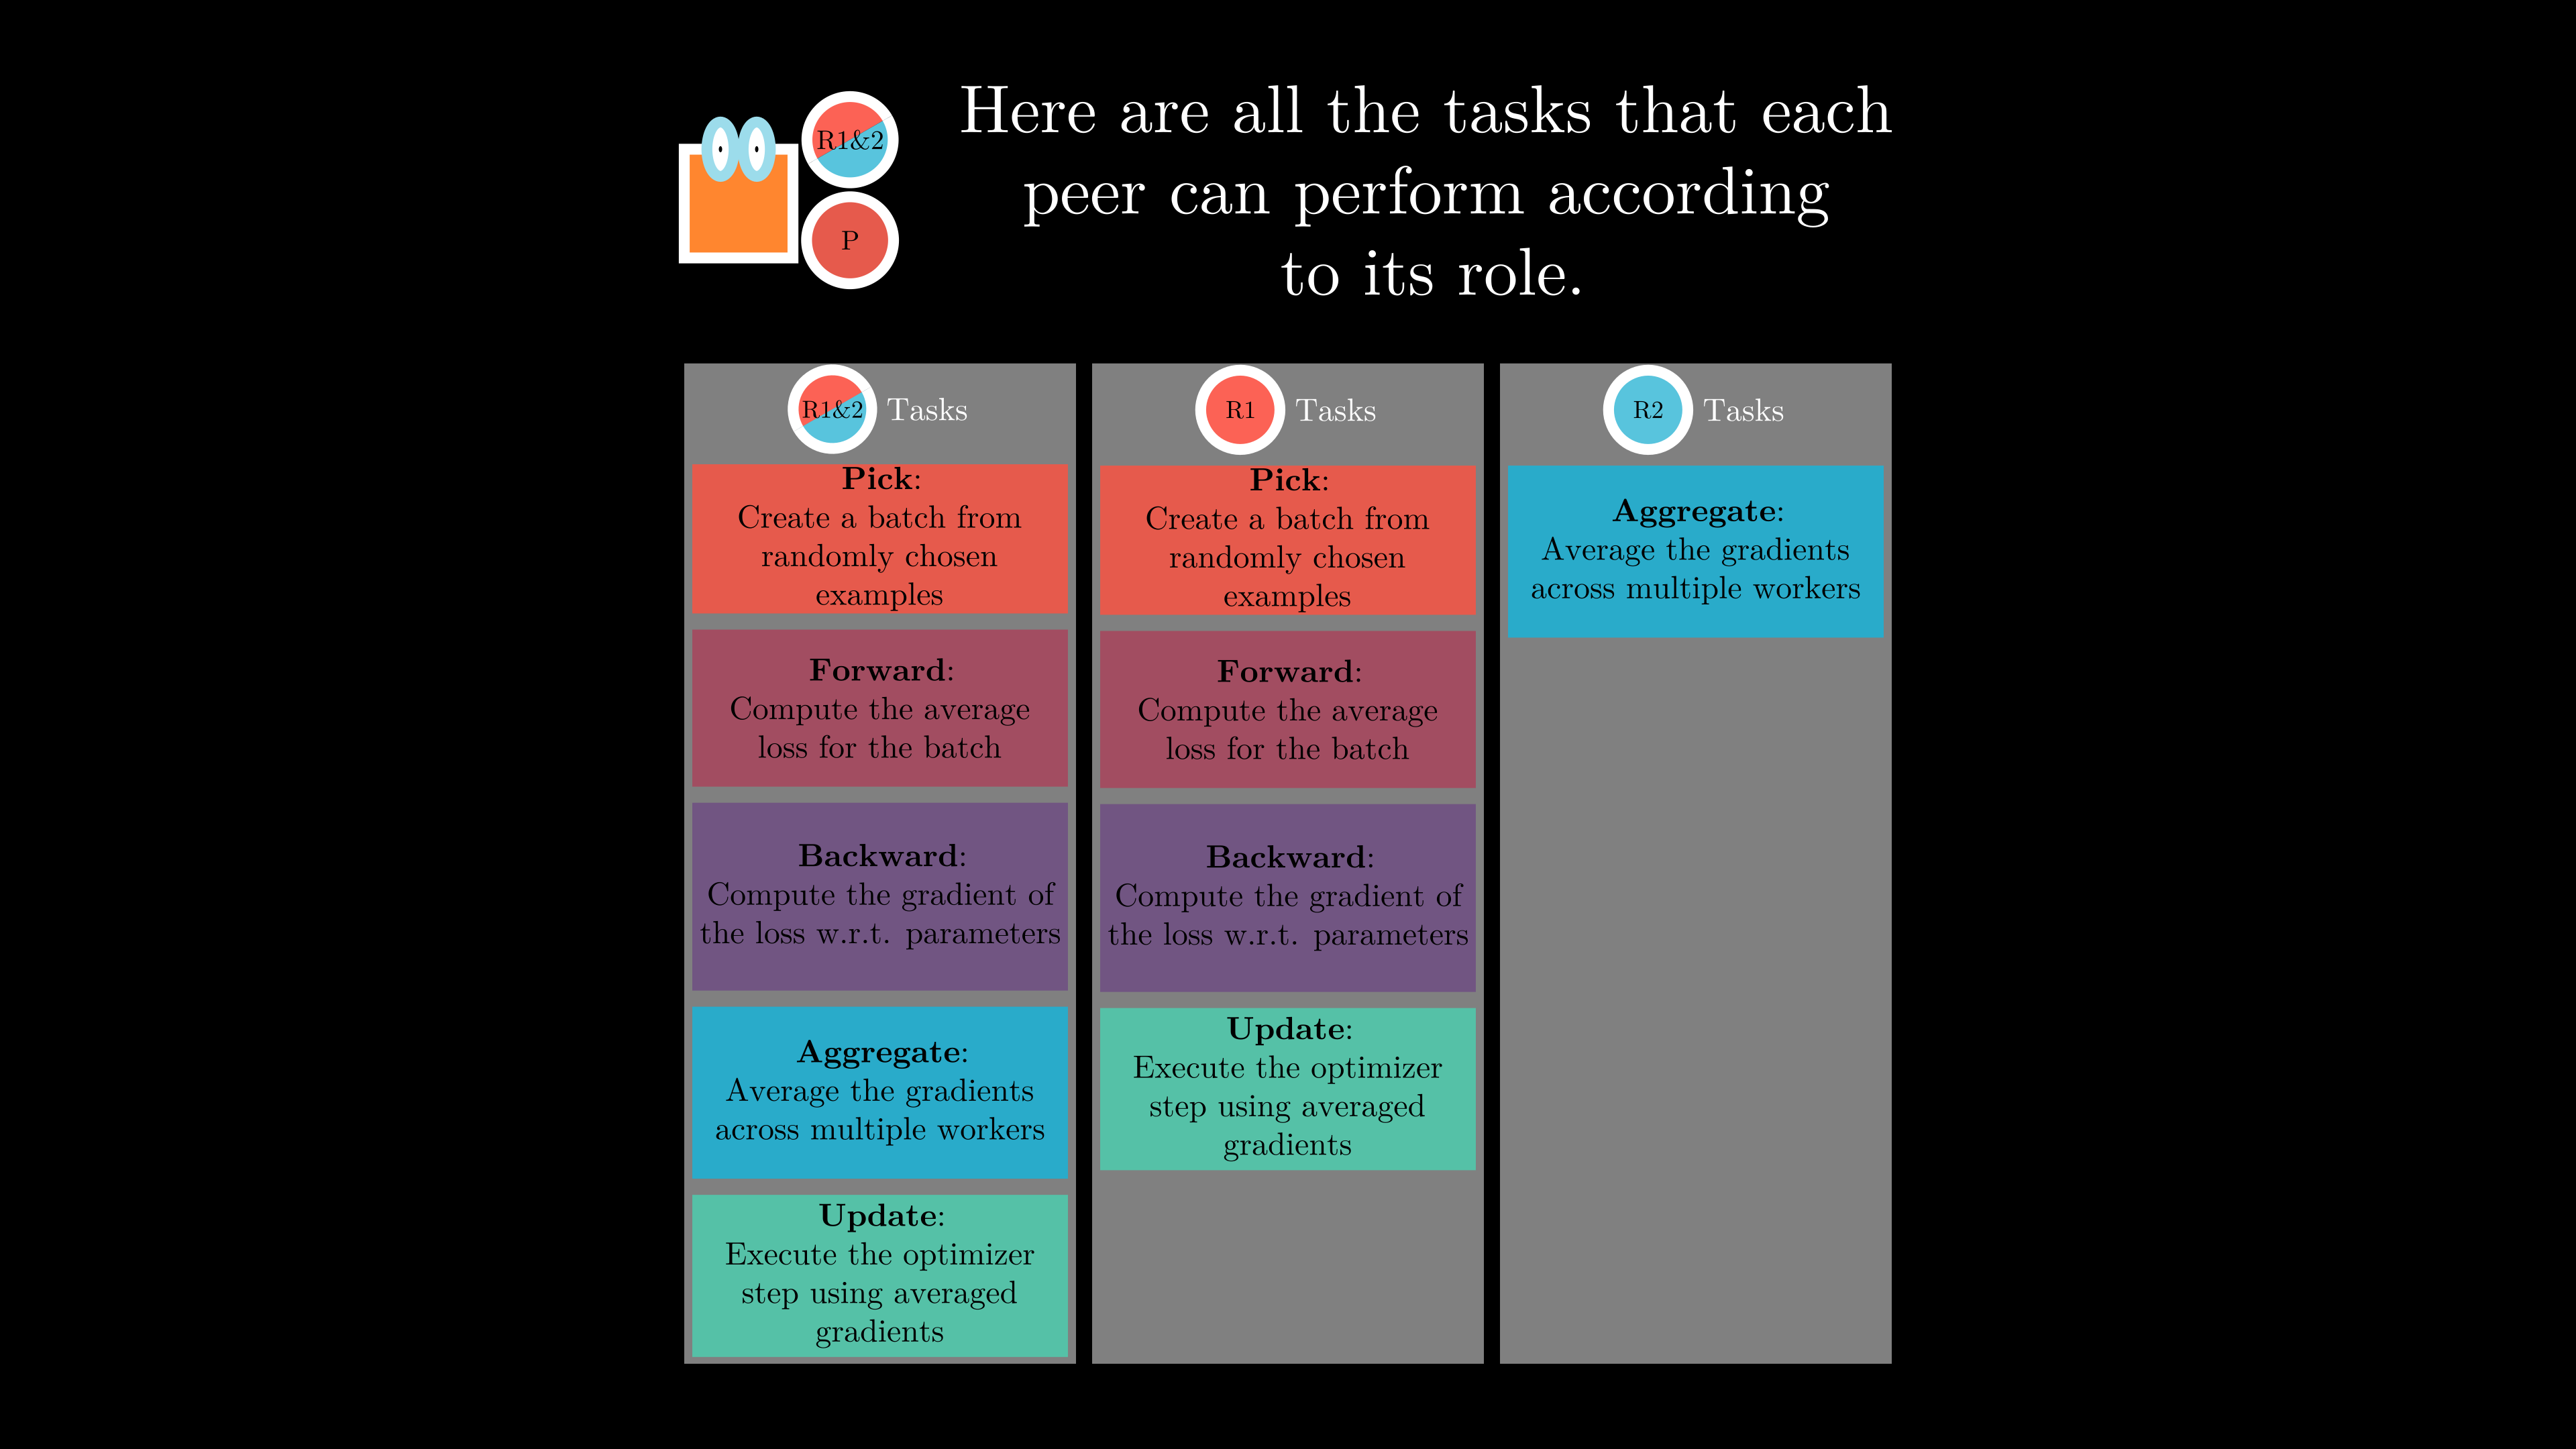
分布式训练中同伴执行的典型机器学习任务,可能带有角色分离
通常,为了减少同步量并稳定学习过程,我们可以在平均之前累积 N 个批次的梯度,这相当于将实际批次大小增加 N 倍。这种方法,结合大多数最先进的语言模型使用大批次这一观察,让我们想到了一个简单的想法:让我们在每个优化器步骤之前,在所有志愿者设备上累积一个非常大的批次!除了与常规分布式训练完全等价且易于扩展之外,这种方法还具有内置容错性的好处,我们将在下面说明。
让我们考虑一下在协作实验中可能遇到的一些潜在故障情况。到目前为止,最常见的情况是一个或多个同伴从训练过程中断开连接:他们可能网络连接不稳定,或者只是想将 GPU 用于其他用途。在这种情况下,我们只会遭受训练上的轻微挫折:这些同伴的贡献会从当前累积的批次大小中扣除,但其他参与者会用他们的梯度来弥补。此外,如果有更多同伴加入,目标批次大小将更快达到,我们的训练过程自然会加速。你可以在视频中看到这一点的演示:
自适应平均
现在我们已经讨论了整体训练过程,还有一个问题:我们实际上如何聚合参与者的梯度?大多数家用电脑无法轻松接受传入连接,下载速度也可能成为限制。
由于我们依赖志愿者的硬件进行实验,中央服务器并不是一个真正可行的选择,因为当扩展到数十个客户端和数亿个参数时,它会很快面临过载。如今大多数数据并行训练运行根本不使用这种策略;相反,它们依赖 All-Reduce——一种高效的全对全通信原语。得益于巧妙的算法优化,每个节点都可以计算全局平均值,而无需将整个本地梯度发送给每个同伴。
因为 All-Reduce 是去中心化的,看起来是个不错的选择;然而,我们仍需要考虑硬件和网络配置的多样性。例如,一些志愿者可能从网络慢但 GPU 强大的计算机加入,一些可能只与部分其他节点有较好的连接,还有一些可能被防火墙阻止了入站连接。
事实证明,我们可以利用这些性能信息,动态地制定出最优的数据传输策略!从高层来看,我们根据每个节点的互联网速度将整个梯度向量分成若干部分:连接最快的节点聚合最大的部分。此外,如果某些节点不接受入站连接,它们只发送数据用于聚合,但不自己计算平均值。根据条件不同,这种自适应算法可以还原出已知的分布式深度学习算法,并通过混合策略对其进行改进,如下所示。
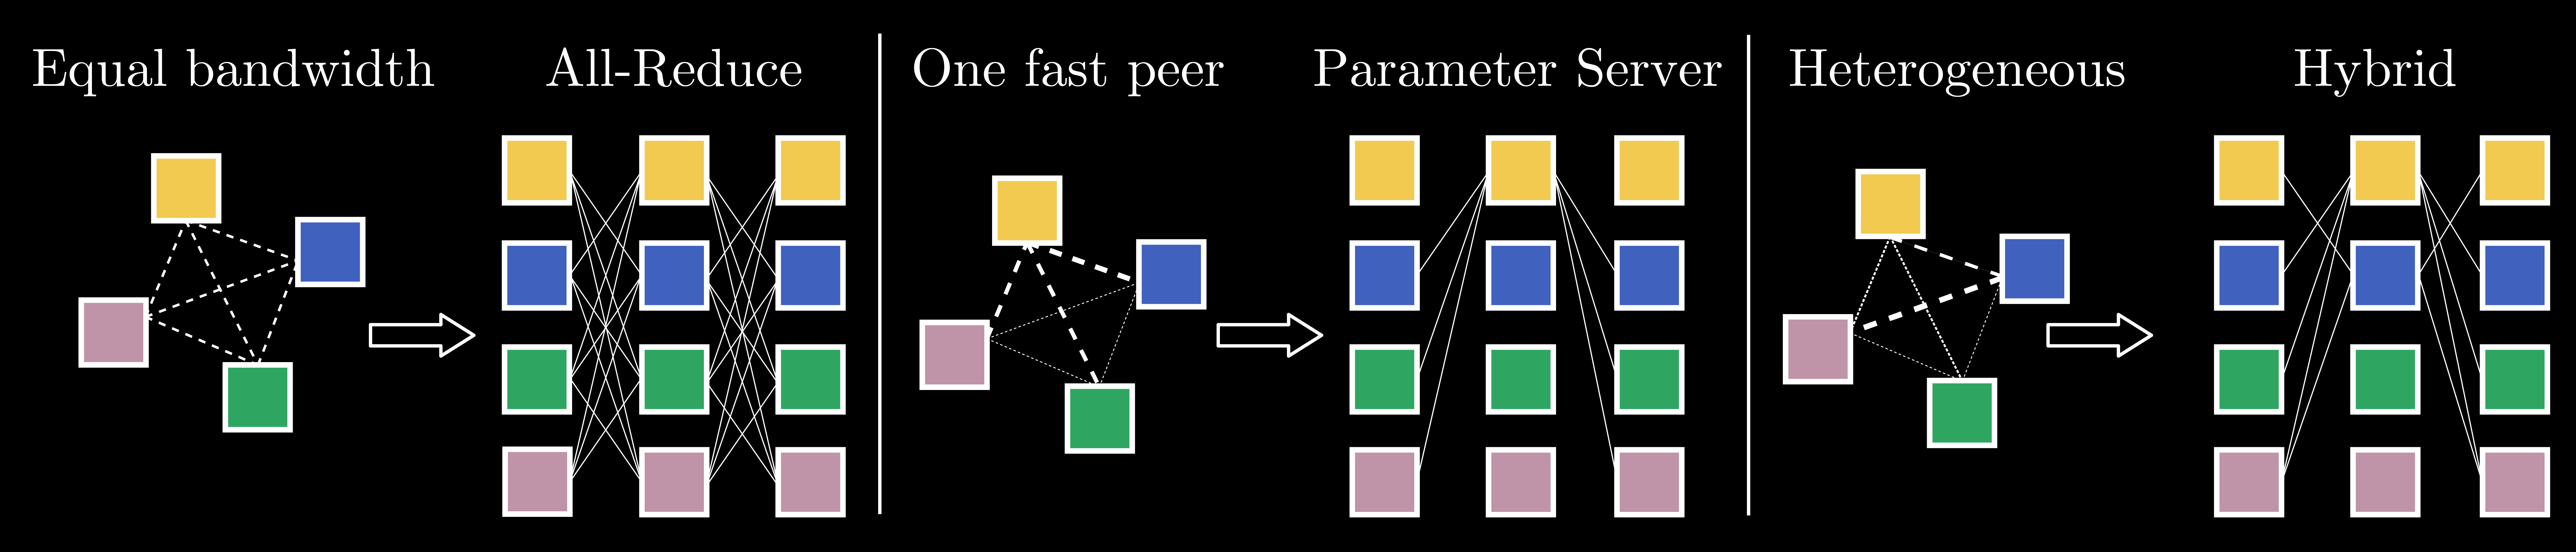
自适应算法下不同平均策略的示例。
💡 去中心化训练的核心技术可在 Hivemind 中找到。
查看仓库,了解如何在你自己的项目中使用这个库!
sahajBERT
一如既往,拥有设计良好的算法框架并不意味着它在实践中能按预期工作,因为一些假设在实际训练运行中可能不成立。为了验证这项技术的竞争力并展示其潜力,我们组织了一次特别的协作活动,预训练一个孟加拉语的掩码语言模型。尽管它是世界上第五大母语,但公开可用的掩码语言模型非常少,这凸显了能够赋能社区的工具的重要性,为该领域解锁了大量机会。
我们与 Neuropark 社区的真实志愿者进行了这项实验,并使用了公开可用的数据集(OSCAR 和 Wikipedia),因为我们希望有一个完全可复现的示例,可以激励其他团队。下面,我们描述训练运行的详细设置并展示其结果。
架构
在我们的实验中,我们选择了 ALBERT (A Lite BERT)——一种语言表示模型,以掩码语言建模(MLM)和句子顺序预测(SOP)为目标进行预训练。我们使用这种架构是因为权重共享使其参数效率非常高:例如,ALBERT-large 有约 1800 万可训练参数,在 GLUE 基准上表现与拥有约 1.08 亿权重的 BERT-base 相当。这意味着节点之间需要交换的数据更少,这在我们的设置中至关重要,因为它显著加快了每次训练迭代的速度。
分词器
我们模型的第一个构件称为分词器,负责将原始文本转换为词汇索引。因为我们正在训练一个孟加拉语模型,它与英语不太相似,所以我们需要在分词器中实现特定于语言的前处理。我们可以将其视为一系列操作:
- 归一化:包括对原始文本数据的所有预处理操作。这是我们改动最多的步骤,因为删除某些细节可能会改变文本的含义,也可能保持不变,这取决于语言。例如,标准的 ALBERT 归一化器会移除重音符号,而对于孟加拉语,我们需要保留它们,因为它们包含有关元音的信息。因此,我们使用以下操作:NMT 归一化、NFKC 归一化、移除多余空格、统一孟加拉语中重复出现的 Unicode 字符,以及转换为小写。
- 预分词描述了拆分输入(例如按空白字符)以强制特定 token 边界的规则。与原工作一样,我们选择将空白字符排除在 token 之外。因此,为了区分单词并避免出现多个单空格 token,每个对应单词开头的 token 都以特殊字符“_”(U+2581)开头。此外,我们将所有标点和数字与其他字符隔离开来,以压缩我们的词表。
- 分词器建模:正是在这一层面,文本被映射为词表元素的序列。有几种算法可以实现这一点,例如字节对编码(BPE)或 Unigram,其中大多数需要从文本语料库构建词表。遵循 ALBERT 的设置,我们使用了 Unigram 语言模型方法,在 OSCAR 数据集去重后的孟加拉语部分上训练了一个包含 32k 个 token 的词表。
- 后处理:分词之后,我们可能想要添加架构所需的几个特殊 token,例如用特殊 token
[CLS]开始序列,或用特殊 token[SEP]分隔两个片段。由于我们的主要架构与原始 ALBERT 相同,我们保持相同的后处理:具体来说,我们在每个示例的开头添加一个[CLS]token,并在两个片段之间以及末尾添加一个[SEP]token。
💡 在 Tokenizers 文档 中阅读有关每个组件的更多信息
你可以通过运行以下代码来复用我们的分词器:
from transformers import AutoTokenizer
tokenizer = AutoTokenizer.from_pretrained("neuropark/sahajBERT")
数据集
我们需要介绍的最后一项是训练数据集。你可能知道,像 BERT 或 ALBERT 这样的预训练模型的强大之处在于,你不需要标注数据集,只需要大量文本。为了训练 sahajBERT,我们使用了 2021 年 3 月 20 日的孟加拉语维基百科转储以及 OSCAR 的孟加拉语子集(600MB + 6GB 文本)。这两个数据集可以轻松地从 HF Hub 下载。
然而,加载整个数据集需要时间和存储空间——这两样东西我们的同伴不一定拥有。为了充分利用参与者提供的资源,我们实现了数据集流式传输,这使他们几乎一加入网络就可以开始训练模型。具体来说,数据集中的示例在训练的同时被并行下载和转换。我们还可以打乱数据集,这样我们的同伴就很少有机会同时处理相同的示例。由于数据集不是预先下载和预处理的,从纯文本到训练示例所需的转换(如下图所示)是即时完成的。
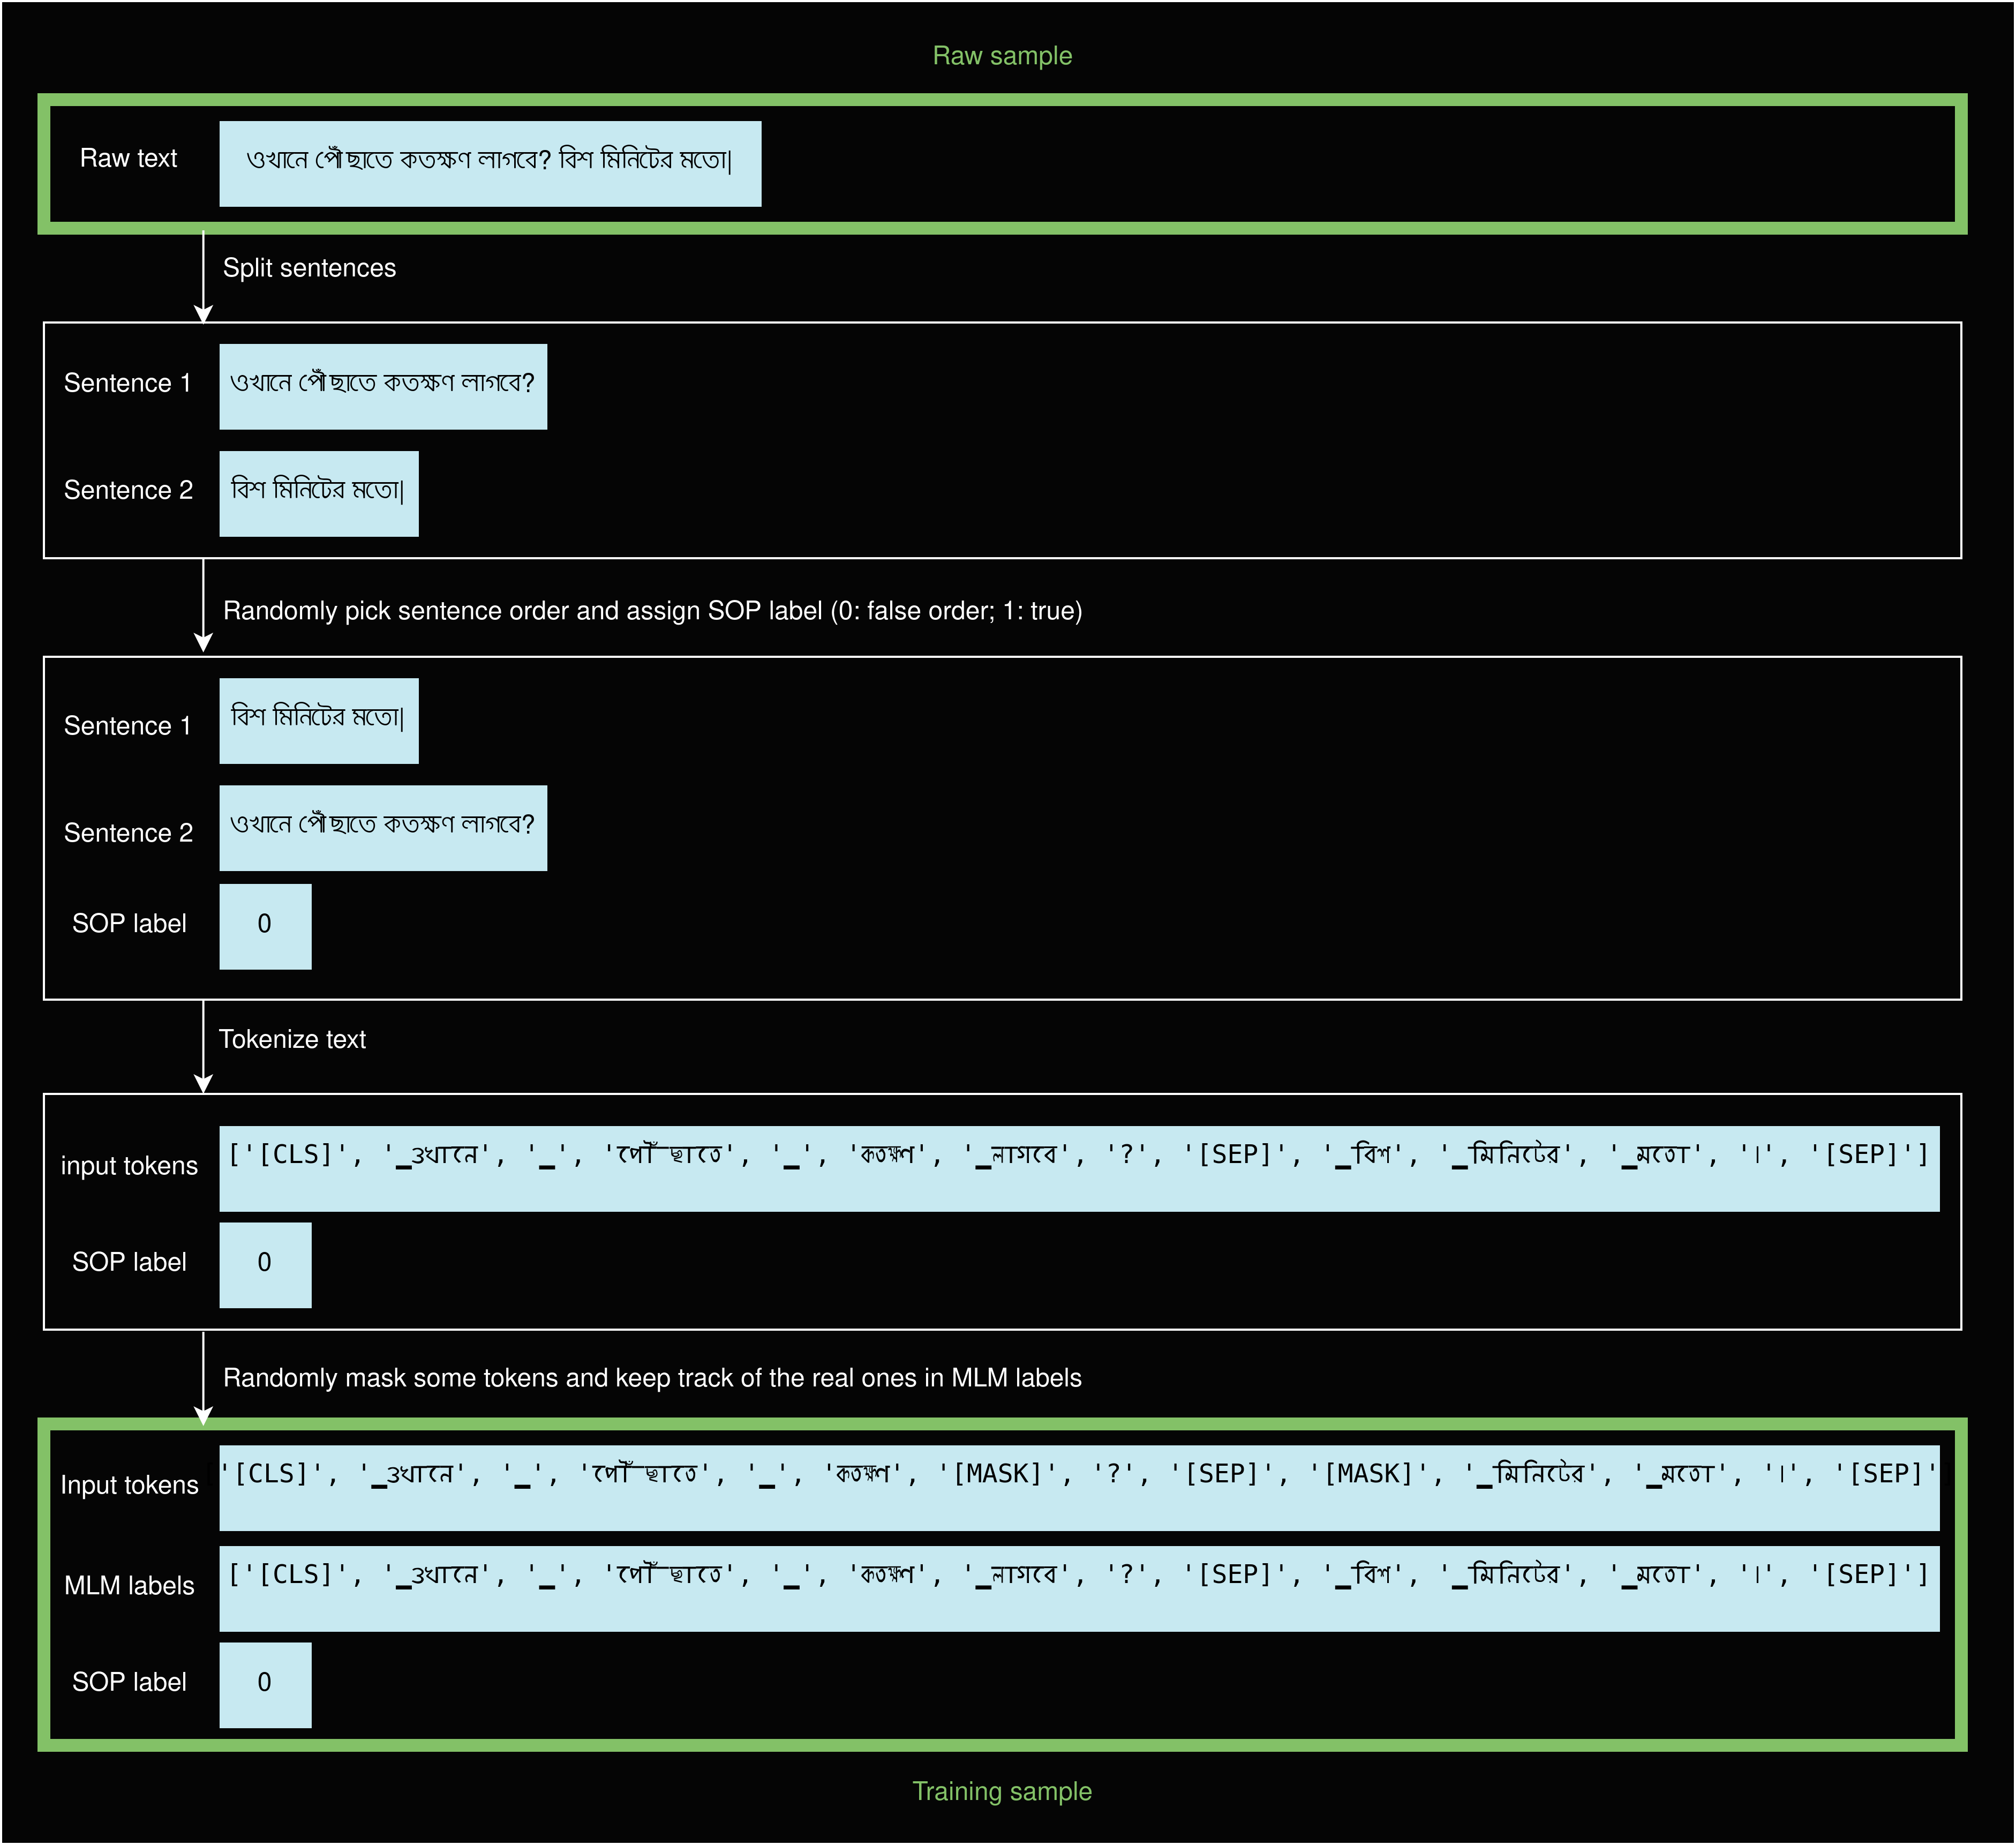
从原始样本到训练样本
数据集流式模式从 🤗 datasets 库的 v1.9 版本开始可用,因此你现在就可以按如下方式使用它:
from datasets import load_dataset

oscar_dataset = load_dataset("oscar", name="unshuffled_deduplicated_bn", streaming=True)
💡 在文档中了解更多关于以流式模式加载数据集的信息
协作活动
sahajBERT 协作训练活动于 5 月 12 日至 5 月 21 日举行。活动汇集了 40 名参与者,其中 30 名是孟加拉语志愿者,10 名是作者所在组织的志愿者。这 40 名志愿者加入了 Neuropark Discord 频道,以接收有关活动的所有信息并参与讨论。要加入实验,志愿者被要求:
- 将他们的用户名发送给管理员以加入允许列表;
- 在本地、Google Colaboratory 或 Kaggle 上打开提供的 notebook;
- 运行一个代码单元格,并在被要求时填写他们的 Hugging Face 凭据;
- 在共享仪表板上观看训练损失下降!
出于安全目的,我们设置了一个授权系统,以便只有 Neuropark 社区的成员才能训练模型。略去技术细节,我们的授权协议使我们能够保证每位参与者都在允许列表中,并确认每位同伴的个人贡献。
在下图中,你可以看到每位志愿者的活动。在整个实验过程中,志愿者登录了 600 个不同的会话。参与者经常并行启动多次运行,其中许多人将他们启动的运行分散在不同时间。单个参与者的运行平均持续 4 小时,最长持续 21 小时。你可以在论文中阅读更多关于参与统计的信息。
显示 sahajBERT 实验参与者的图表。圆的半径与处理的总批次数量相关,如果参与者不活跃,则圆为灰色。每个紫色方块代表一个活跃设备,颜色越深对应性能越高
除了参与者提供的资源外,我们还使用了 16 个可抢占(便宜但经常中断)的单 GPU T4 云实例来确保运行的稳定性。实验的累计运行时间为 234 天,在下图中你可以看到每位同伴贡献的部分损失曲线!
最终模型已上传到 Model Hub,因此如果你想的话,可以下载并使用它:https://hf.co/neuropark/sahajBERT
评估
为了评估 sahajBERT 的性能,我们在孟加拉语的两个下游任务上对其进行了微调:
- 在 WikiANN 的孟加拉语拆分上进行命名实体识别(NER)。此任务的目标是将输入文本中的每个 token 分类为以下类别之一:人物、组织、地点或都不是。
- 在来自 IndicGLUE 的 Soham 文章数据集上进行新闻类别分类(NCC)。此任务的目标是预测输入文本所属的类别。
我们在训练期间对 NER 任务进行了评估,以检查一切是否顺利;正如你在下图中所看到的,情况确实如此!
不同预训练模型检查点在 NER 任务上微调模型的评估指标。
在训练结束时,我们将 sahajBERT 与另外三个预训练语言模型进行了比较:XLM-R Large、IndicBert 和 bnRoBERTa。在下表中,您可以看到我们的模型与 HF Hub 上可用的最佳孟加拉语模型结果相当,尽管我们的模型只有约 1800 万训练参数,而例如 XLM-R(一个强大的多语言基线)有约 5.59 亿参数,并在数百个 V100 GPU 上训练。
| 模型 | NER F1(均值 ± 标准差) | NCC 准确率(均值 ± 标准差) |
|---|---|---|
| sahajBERT | 95.45 ± 0.53 | 91.97 ± 0.47 |
| XLM-R-large | 96.48 ± 0.22 | 90.05 ± 0.38 |
| IndicBert | 92.52 ± 0.45 | 74.46 ± 1.91 |
| bnRoBERTa | 82.32 ± 0.67 | 80.94 ± 0.45 |
这些模型也可在 Hub 上获取。您可以直接通过其模型卡片上的托管推理 API 小部件进行测试,或直接在 Python 代码中加载它们。
sahajBERT-NER
模型卡片:https://hf.co/neuropark/sahajBERT-NER
from transformers import (
    AlbertForTokenClassification,
    TokenClassificationPipeline,
    PreTrainedTokenizerFast,
)

# Initialize tokenizer
tokenizer = PreTrainedTokenizerFast.from_pretrained("neuropark/sahajBERT-NER")

# Initialize model
model = AlbertForTokenClassification.from_pretrained("neuropark/sahajBERT-NER")

# Initialize pipeline
pipeline = TokenClassificationPipeline(tokenizer=tokenizer, model=model)

raw_text = "এই ইউনিয়নে ৩ টি মৌজা ও ১০ টি গ্রাম আছে ।" # Change me
output = pipeline(raw_text)
sahajBERT-NCC
模型卡片:https://hf.co/neuropark/sahajBERT-NER
from transformers import (
    AlbertForSequenceClassification,
    TextClassificationPipeline,
    PreTrainedTokenizerFast,
)

# Initialize tokenizer
tokenizer = PreTrainedTokenizerFast.from_pretrained("neuropark/sahajBERT-NCC")

# Initialize model
model = AlbertForSequenceClassification.from_pretrained("neuropark/sahajBERT-NCC")

# Initialize pipeline
pipeline = TextClassificationPipeline(tokenizer=tokenizer, model=model)

raw_text = "এই ইউনিয়নে ৩ টি মৌজা ও ১০ টি গ্রাম আছে ।" # Change me
output = pipeline(raw_text)
结论
在这篇博客文章中,我们讨论了能够实现神经网络协作预训练的方法,sahajBERT 是将其应用于现实世界问题的第一个真正成功的例子。
这对更广泛的机器学习社区意味着什么?首先,现在可以与朋友一起运行大规模分布式预训练,我们希望看到许多以前不太容易获得的酷炫新模型。此外,我们的结果可能对多语言 NLP 很重要,因为现在任何语言的社区都可以训练自己的模型,而无需集中在某个地方的大量计算资源。
致谢
DeDLOC 论文和 sahajBERT 训练实验由 Michael Diskin、Alexey Bukhtiyarov、Max Ryabinin、Lucile Saulnier、Quentin Lhoest、Anton Sinitsin、Dmitry Popov、Dmitry Pyrkin、Maxim Kashirin、Alexander Borzunov、Albert Villanova del Moral、Denis Mazur、Ilia Kobelev、Yacine Jernite、Thomas Wolf 和 Gennady Pekhimenko 创建。该项目是 Hugging Face、Yandex Research、HSE University、MIPT、University of Toronto 和 Vector Institute 之间合作的成果。
此外,我们要感谢 Stas Bekman、Dmitry Abulkhanov、Roman Zhytar、Alexander Ploshkin、Vsevolod Plokhotnyuk 和 Roman Kail 在构建训练基础设施方面提供的宝贵帮助。同时,我们感谢 Abhishek Thakur 帮助进行下游评估,以及 Tanmoy Sarkar 和 Omar Sanseviero,他们帮助我们组织了协作实验,并在训练过程中定期向参与者提供状态更新。
下面,您可以看到协作实验的所有参与者:
参考文献
“Distributed Deep Learning in Open Collaborations”,ArXiv
DeDLOC 仓库中 sahajBERT 实验的代码。
来源:Hugging Face:Blog(RSS) · huggingface.co