Hugging Face 教你微调 StarCoder 打造个人编程助手 HugCoder
Personal Copilot: Train Your Own Coding Assistant
Hugging Face 发布教程,介绍如何基于 StarCoder 微调出了解自家代码库的个人编程助手 HugCoder,涵盖数据抓取、FIM 训练目标与部署。
原文给出从数据抓取到 QLoRA 与全量微调的完整流程和成本对比,读者可按步骤复刻自己的私有代码库助手。
在编程和软件开发的不断演进中,对效率和生产力追求催生了显著的创新。其中之一便是代码生成模型的出现,如 Codex、StarCoder 和 Code Llama。这些模型在生成类似人类的代码片段方面展现了非凡的能力,从而显示出作为编码助手的巨大潜力。
然而,尽管这些预训练模型能在多种任务上表现出色,但地平线上还隐约显现着一个令人兴奋的可能性:能够根据你的具体需求定制代码生成模型。想象一下,可以在企业规模上利用的个性化编码助手。
在这篇博客文章中,我们将展示如何创建 HugCoder 🤗,这是一个基于 huggingface GitHub 组织的公共仓库代码内容进行微调的代码 LLM。我们将讨论数据收集工作流程、训练实验以及一些有趣的结果。这将使你能够基于自己的专有代码库创建个人副驾驶。我们还会留下几个项目的进一步扩展供你实验。
让我们开始吧 🚀
数据收集工作流程
我们所需的数据集概念上很简单,我们这样构建它:
| 仓库名称 | 仓库中的文件路径 | 文件内容 |
| --- | --- | --- |
| --- | --- | --- |
使用 Python GitHub API 从 GitHub 抓取代码内容很直接。然而,根据仓库数量和仓库内代码文件的数量,很容易遇到 API 速率限制问题。
为了避免这类问题,我们决定在本地克隆所有公共仓库,并从中提取内容,而不是通过 API。我们使用 Python 的 multiprocessing 模块并行下载所有仓库,如此下载脚本所示。
仓库中经常包含非代码文件,如图片、演示文稿和其他资产。我们对抓取这些不感兴趣。我们创建了一个扩展名列表来过滤它们。为了解析除 Jupyter Notebooks 之外的代码文件,我们简单地使用了“utf-8”编码。对于笔记本,我们只考虑了代码单元格。
我们还排除了所有与代码不直接相关的文件路径。这些包括:.git、__pycache__ 和 xcodeproj。
为了使内容的序列化相对内存友好,我们使用了分块和 feather 格式。请参考此脚本获取完整实现。
最终数据集可在 Hub 上获取,其样子如下:
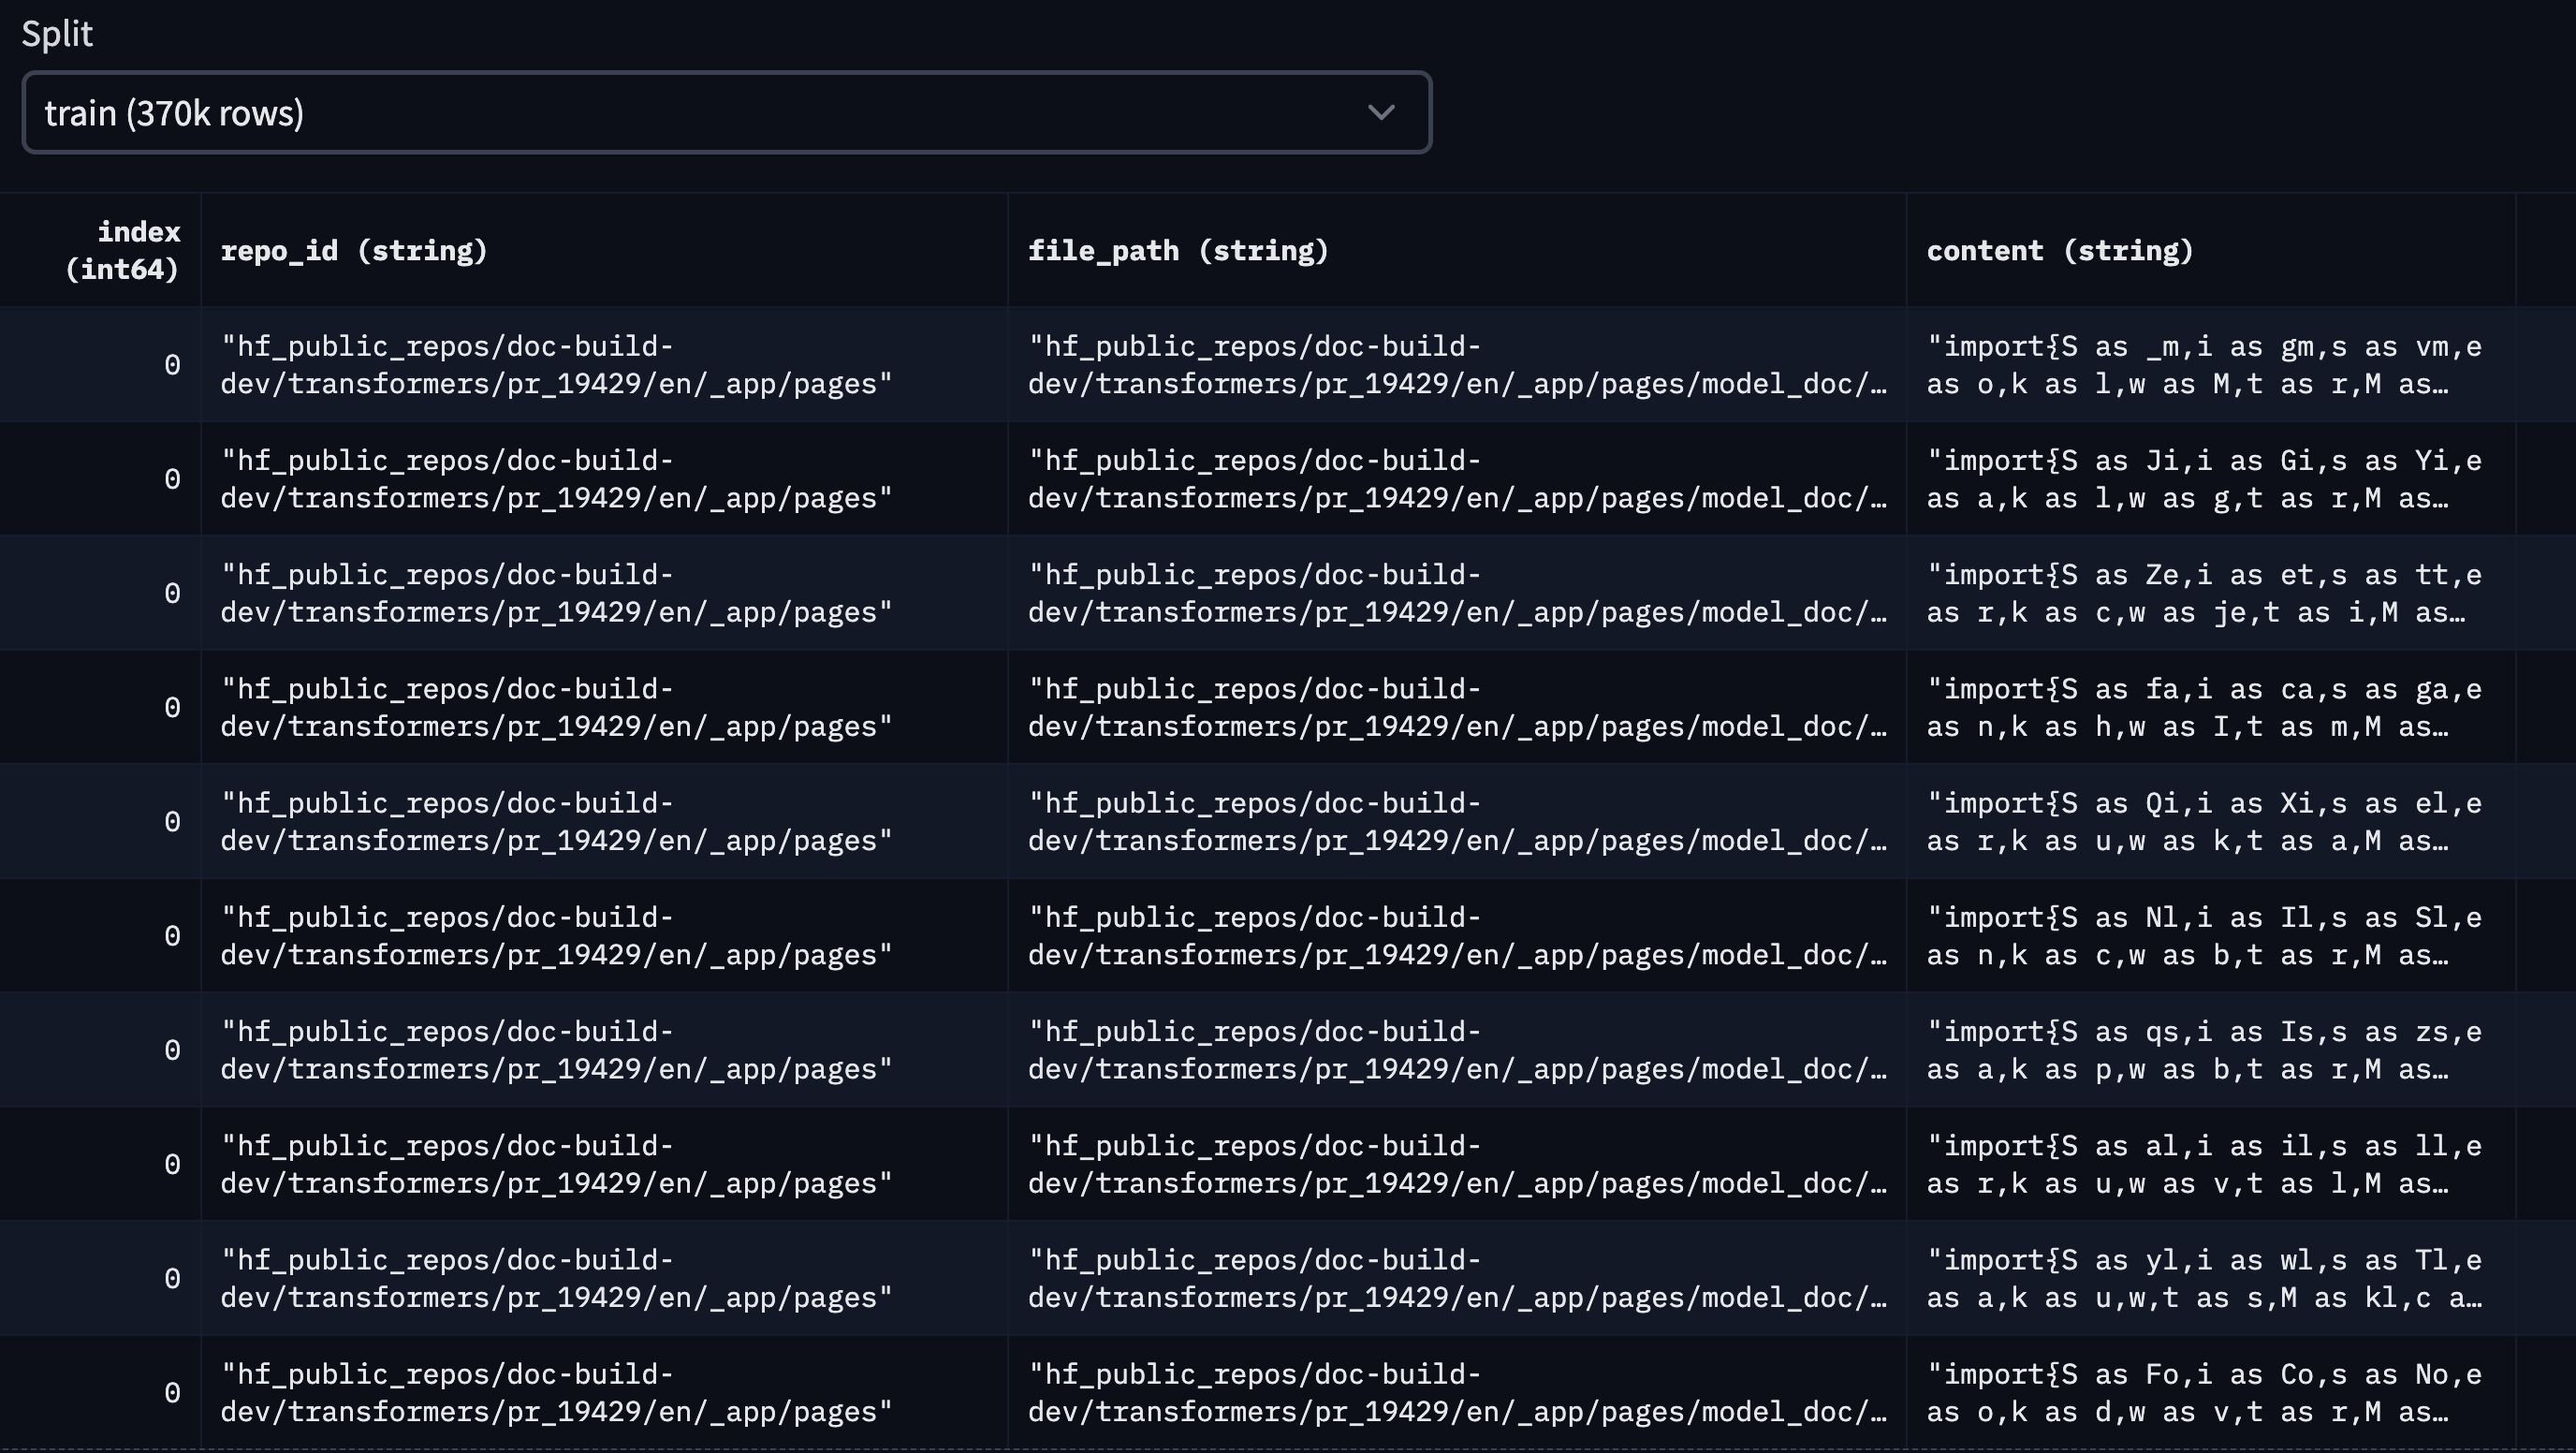
在这篇博客中,我们根据星标数考虑了排名前 10 的 Hugging Face 公共仓库。它们如下:
['transformers', 'pytorch-image-models', 'datasets', 'diffusers', 'peft', 'tokenizers', 'accelerate', 'text-generation-inference', 'chat-ui', 'deep-rl-class']
这是我们用来生成此数据集的代码,而这是 Hub 中的数据集。以下是其样貌快照:
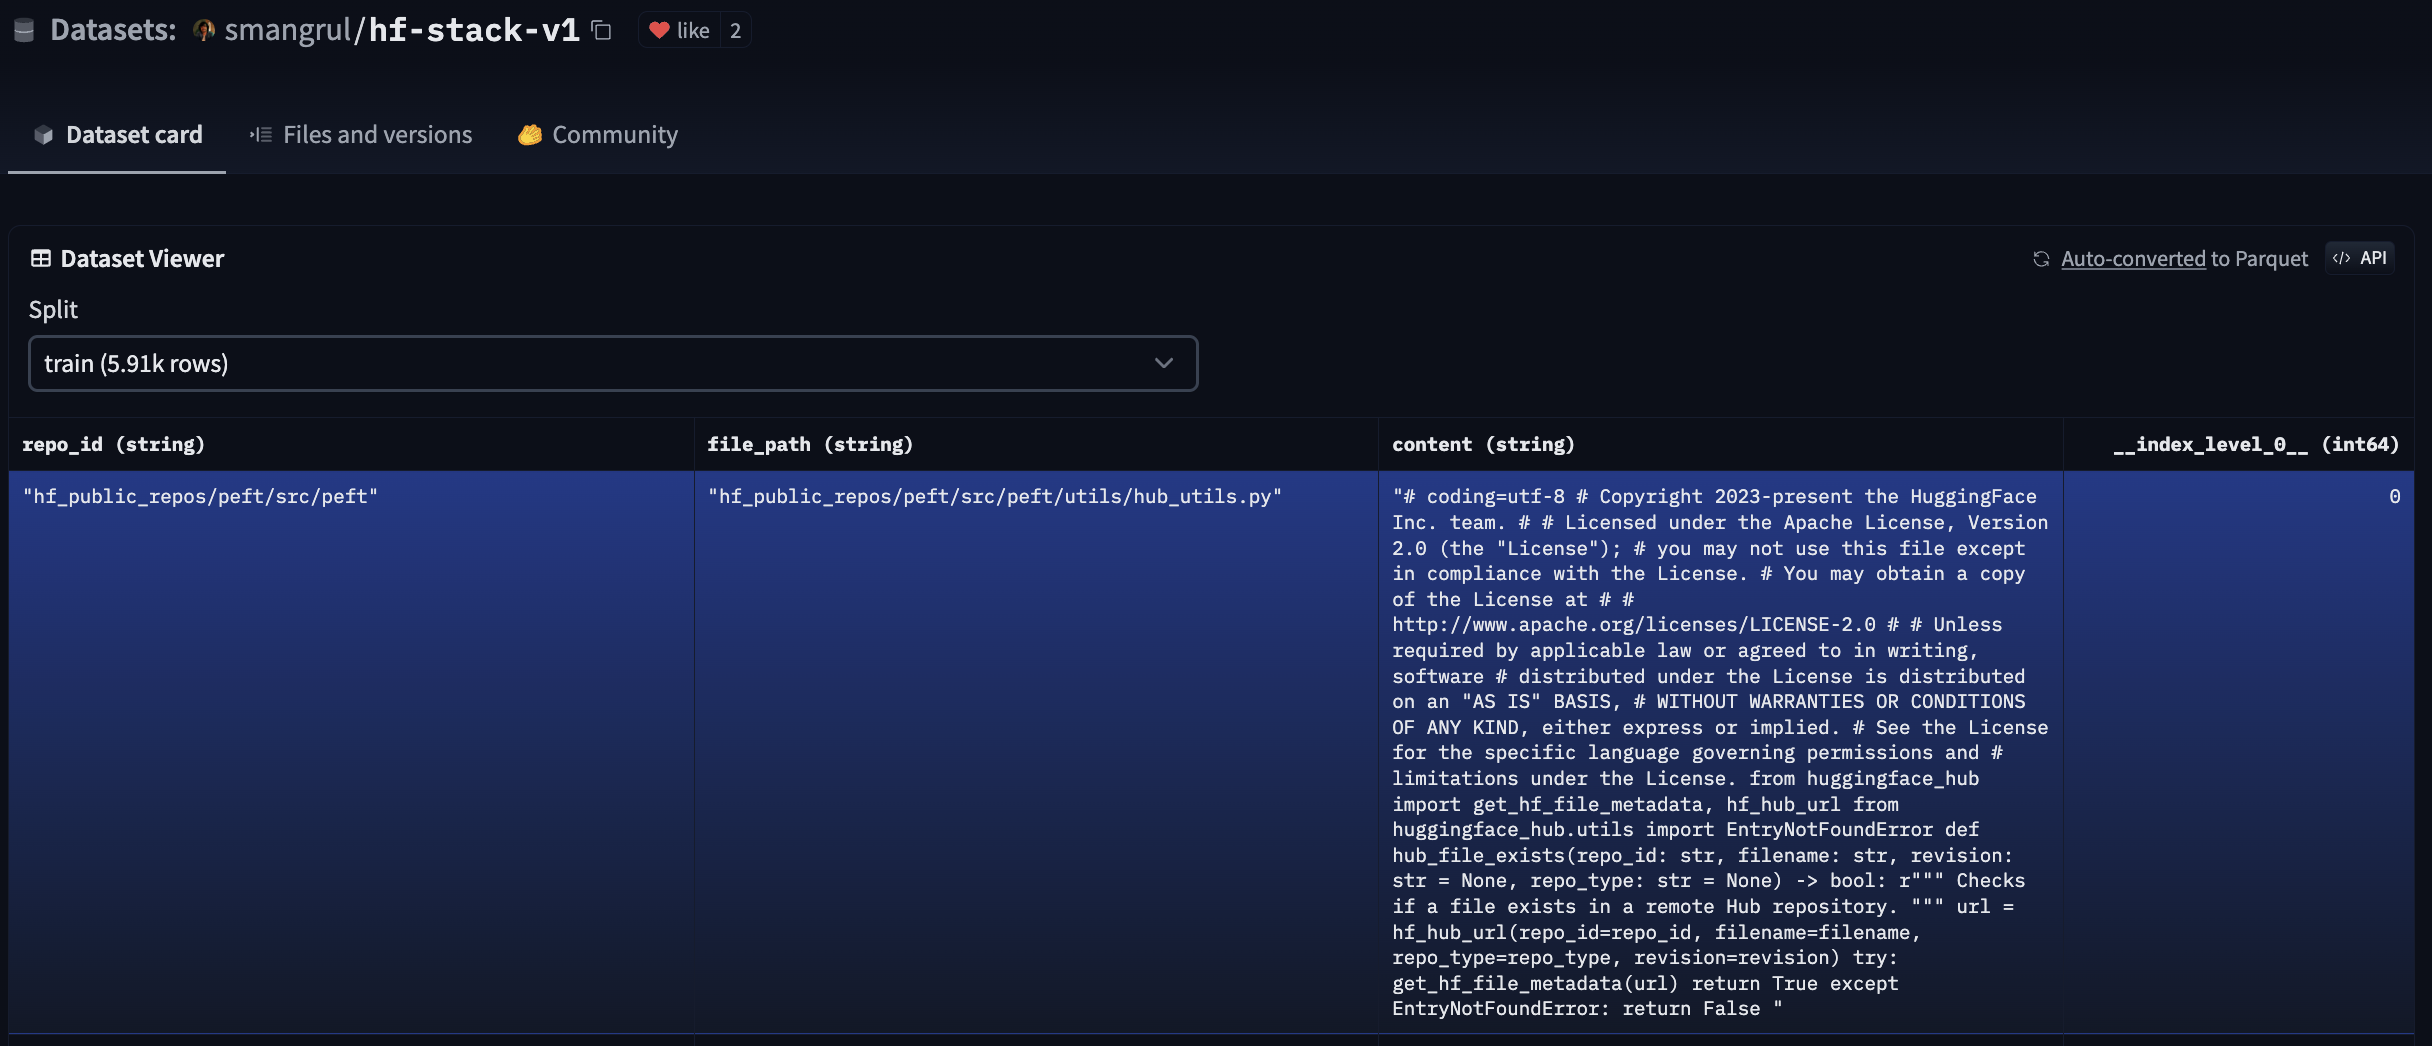
为了降低项目复杂度,我们没有考虑数据集的去重。如果你有兴趣在生产应用中应用去重技术,这篇博客文章是关于代码 LLM 背景下该主题的优秀资源。
微调你自己的个人副驾驶
在本节中,我们将展示如何微调以下模型:bigcode/starcoder(15.5B 参数)、bigcode/starcoderbase-1b(1B 参数)、Deci/DeciCoder-1b(1B 参数)。我们将使用单个 A100 40GB Colab Notebook,并借助 🤗 PEFT(参数高效微调)完成所有实验。此外,我们还将展示如何在配备 8 块 A100 80GB GPU 的机器上,利用 🤗 Accelerate 的 FSDP 集成对 bigcode/starcoder(15.5B 参数)进行全量微调。训练目标是填充中间部分(FIM),即将训练序列的部分内容移到末尾,并以自回归方式预测重新排序后的序列。
为什么选择 PEFT?全量微调成本高昂。让我们用一些数字来说明问题:
全量微调所需的最低 GPU 显存:
- 权重:2 字节(混合精度训练)
- 权重梯度:2 字节
- 使用 Adam 时的优化器状态:原始 FP32 权重占 4 字节 + 一阶和二阶矩估计占 8 字节
- 将以上所有项相加,每个参数的成本:每个参数 16 字节
- 15.5B 模型 -> 248GB GPU 显存,甚至还未考虑存储中间激活值所需的巨大显存 -> 至少需要 4 块 A100 80GB GPU
由于硬件需求巨大,我们将使用QLoRA进行参数高效微调。以下是使用 QLoRA 微调 StarCoder 所需的最低 GPU 显存:
可训练参数:110,428,160 || 全部参数:15,627,884,544 || 可训练比例:0.7066097761926236
- 基础模型权重:0.5 字节 * 15.51B 冻结参数 = 7.755 GB
- 适配器权重:2 字节 * 0.11B 可训练参数 = 0.22GB
- 权重梯度:2 字节 * 0.11B 可训练参数 = 0.12GB
- 使用 Adam 时的优化器状态:4 字节 * 0.11B 可训练参数 * 3 = 1.32GB
- 将以上所有项相加 -> 9.51 GB ~10GB -> 需要 1 块 A100 40GB GPU 🤯。需要 A100 40GB GPU 的原因是,训练时 2048 的长序列长度和批次大小为 4 会导致中间激活值带来更高的显存需求。如下文所示,所需 GPU 显存为 26GB,可以容纳在 A100 40GB GPU 上。此外,A100 GPU 与 Flash Attention 2 的兼容性更好。
在上述计算中,我们没有考虑中间激活检查点所需的显存,这部分显存需求相当大。我们利用 Flash Attention V2 和梯度检查点来克服这个问题。
- 对于 QLoRA 结合 Flash Attention V2 和梯度检查点,模型在单块 A100 40GB GPU 上占用的总显存为 26 GB,批次大小为 4。
- 对于使用 FSDP 结合 Flash Attention V2 和梯度检查点的全量微调,每块 GPU 占用的显存范围在 70 GB 到 77.6 GB 之间,per_gpu_batch_size 为 1。
请参考model-memory-usage,轻松计算在 🤗 Hugging Face Hub 上托管的模型上进行训练和执行大模型推理所需的 vRAM。
全量微调
我们将探讨如何使用 PyTorch 全分片数据并行(FSDP)技术在 8 块 A100 80GB GPU 上对 bigcode/starcoder(15B 参数)进行全量微调。有关 FSDP 的更多信息,请参考使用 PyTorch FSDP 微调 Llama 2 70B和使用 PyTorch 全分片数据并行加速大模型训练。
资源
- 代码库:链接。它使用了 Transformers 中最近添加的 Flash Attention V2 支持。
- FSDP 配置:fsdp_config.yaml
- 模型:bigcode/stacoder
- 数据集:smangrul/hf-stack-v1
- 微调模型:smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab
启动训练的命令见 run_fsdp.sh。
accelerate launch --config_file "configs/fsdp_config.yaml"  train.py \
    --model_path "bigcode/starcoder" \
    --dataset_name "smangrul/hf-stack-v1" \
    --subset "data" \
    --data_column "content" \
    --split "train" \
    --seq_length 2048 \
    --max_steps 2000 \
    --batch_size 1 \
    --gradient_accumulation_steps 2 \
    --learning_rate 5e-5 \
    --lr_scheduler_type "cosine" \
    --weight_decay 0.01 \
    --num_warmup_steps 30 \
    --eval_freq 100 \
    --save_freq 500 \
    --log_freq 25 \
    --num_workers 4 \
    --bf16 \
    --no_fp16 \
    --output_dir "starcoder-personal-copilot-A100-40GB-colab" \
    --fim_rate 0.5 \
    --fim_spm_rate 0.5 \
    --use_flash_attn
总训练时间为 9 小时。按照 lambdalabs 上 8 块 A100 80GB GPU 每小时 $12.00 的价格计算,总成本为 $108。
PEFT
我们将探讨如何使用 QLoRA 在单块 A100 40GB GPU 上利用 🤗 PEFT 微调 bigcode/starcoder(15B 参数)。有关 QLoRA 和 PEFT 方法的更多信息,请参阅 Making LLMs even more accessible with bitsandbytes, 4-bit quantization and QLoRA 和 🤗 PEFT: Parameter-Efficient Fine-Tuning of Billion-Scale Models on Low-Resource Hardware。
资源
- 代码库:链接。它使用了 Transformers 中最近新增的 Flash Attention V2 支持。
- Colab notebook:链接。请确保选择 A100 GPU 并开启 High RAM 设置。
- 模型:bigcode/stacoder
- 数据集:smangrul/hf-stack-v1
- QLoRA 微调模型:smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab
启动训练的命令见 run_peft.sh。总训练时间为 12.5 小时。按照 lambdalabs 上 $1.10 / 小时 的价格计算,总成本为 $13.75。相当不错 🚀!在成本方面,它比全量微调的成本低 7.8 倍。
对比
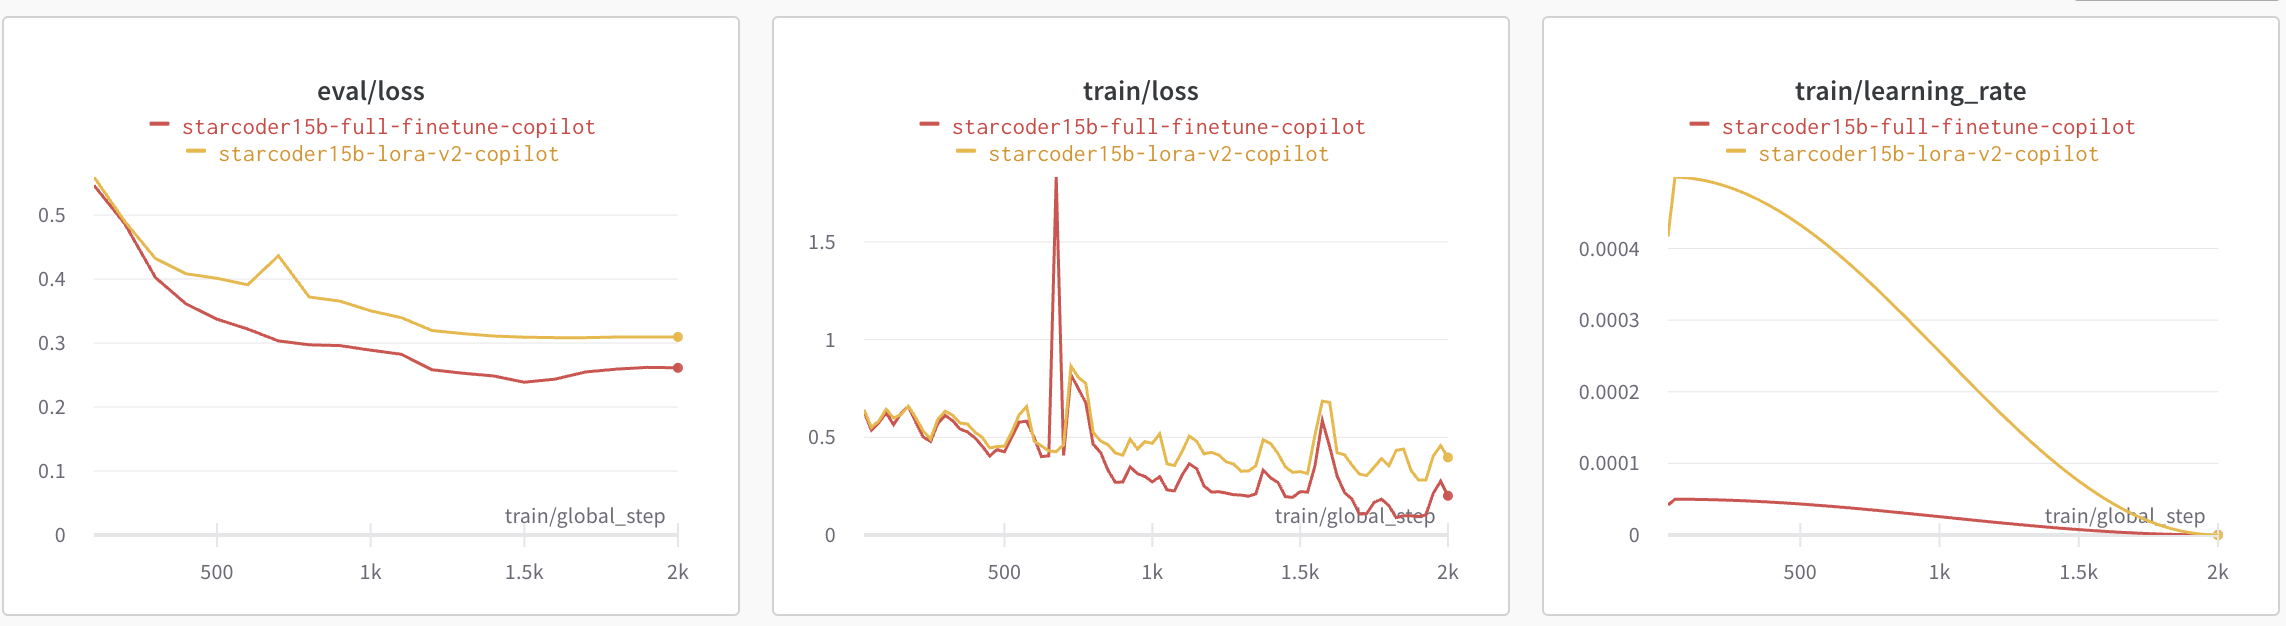
下图展示了 QLoRA 与全量微调的评估损失、训练损失和学习率调度器。我们观察到,与 QLoRA 相比,全量微调导致的损失略低,收敛速度也稍快。PEFT 微调的学习率是全量微调的 10 倍。
为了确保我们的 QLoRA 模型不会导致灾难性遗忘,我们在其上运行了 Python Human Eval。以下是我们得到的结果。Pass@1 衡量的是每个问题仅考虑生成一个代码候选时的完成通过率。我们可以观察到,基础 bigcode/starcoder(15B 参数)与微调后的 PEFT 模型 smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab 在 humaneval-python 上的表现相当。
| 模型 | Pass@1 |
| bigcode/starcoder | 33.57 |
| smangrul/peft-lora-starcoder15B-v2-personal-copilot-A100-40GB-colab | 33.37 |
现在让我们看一些定性示例。在我们的手动分析中,我们注意到 QLoRA 导致了轻微的过拟合,因此我们通过 PEFT 的 add_weighted_adapter 工具创建一个权重为 0.8 的新加权适配器来降低其权重。
我们将看 2 个代码填充示例,其中模型的任务是填充由 <FILL_ME> 占位符表示的部分。我们将考虑来自 GitHub Copilot、QLoRA 微调模型和全量微调模型的填充补全。
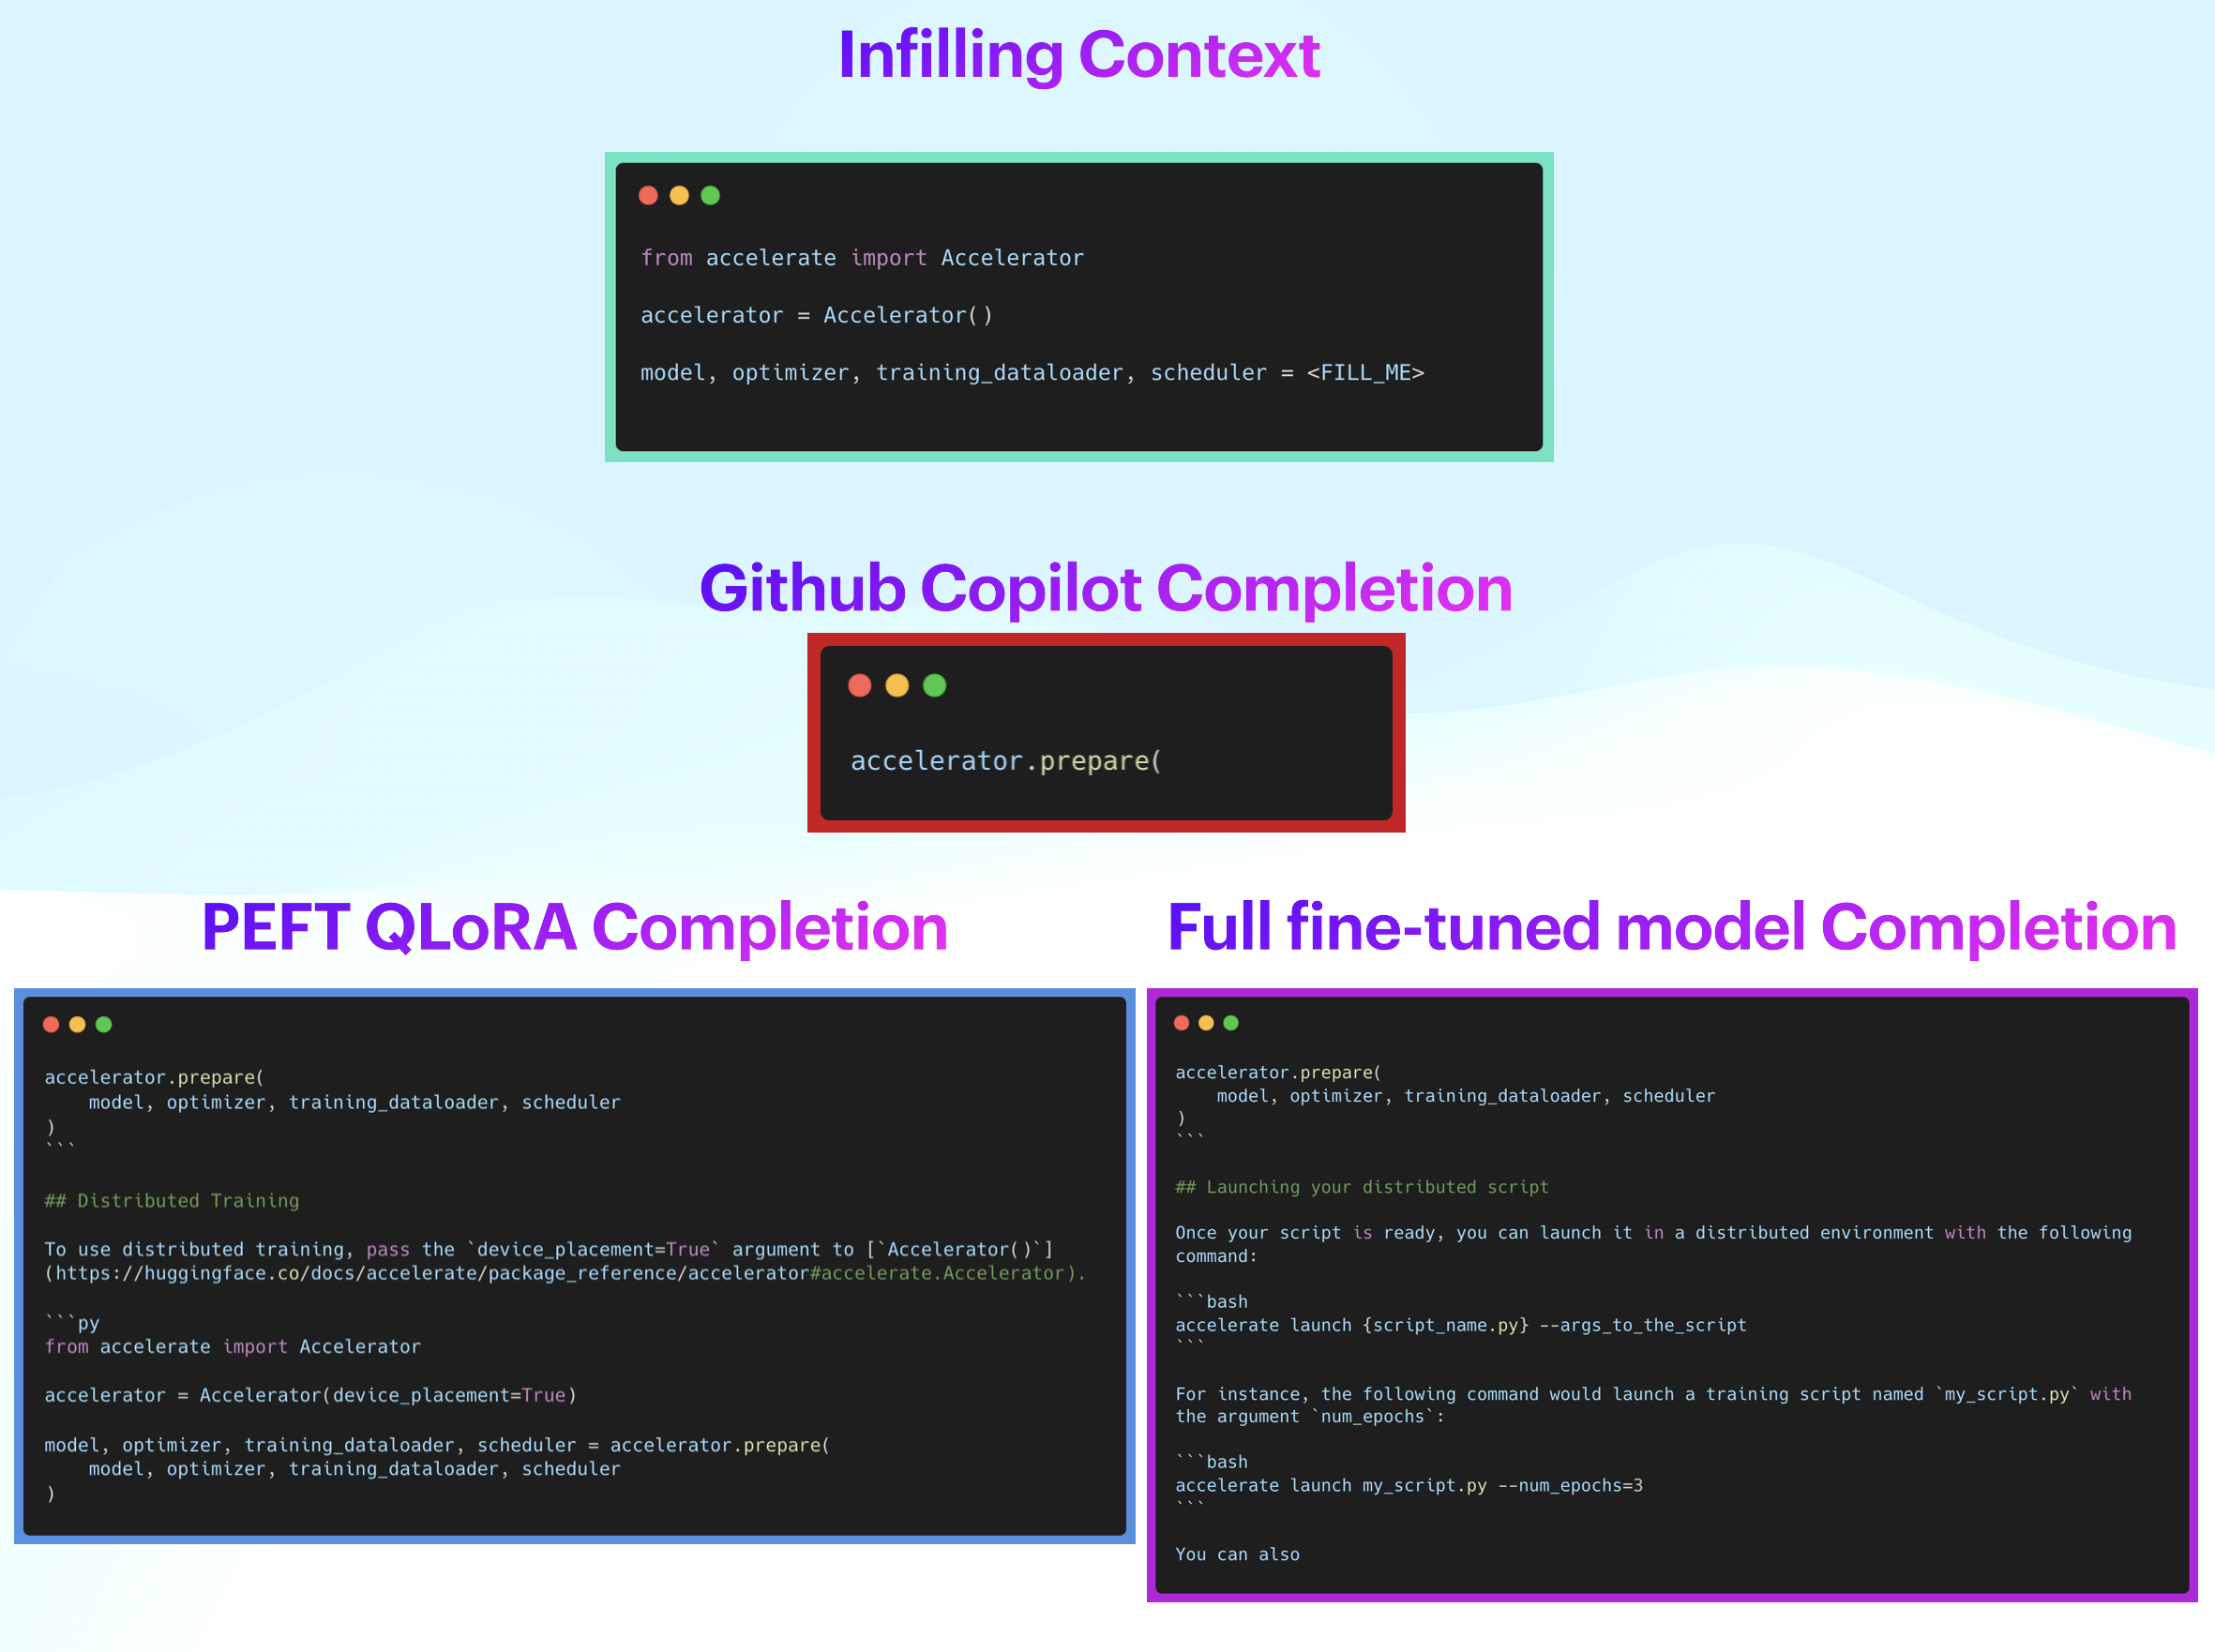 定性示例 1
在上面的示例中,GitHub Copilot 的补全方向正确,但帮助不大。另一方面,QLoRA 和全量微调模型的补全正确地用必要的参数填充了整个函数调用。然而,它们之后也添加了更多噪声。这可以通过后处理步骤来控制,将补全限制在右括号或换行处。请注意,QLoRA 和全量微调模型产生的结果质量相似。
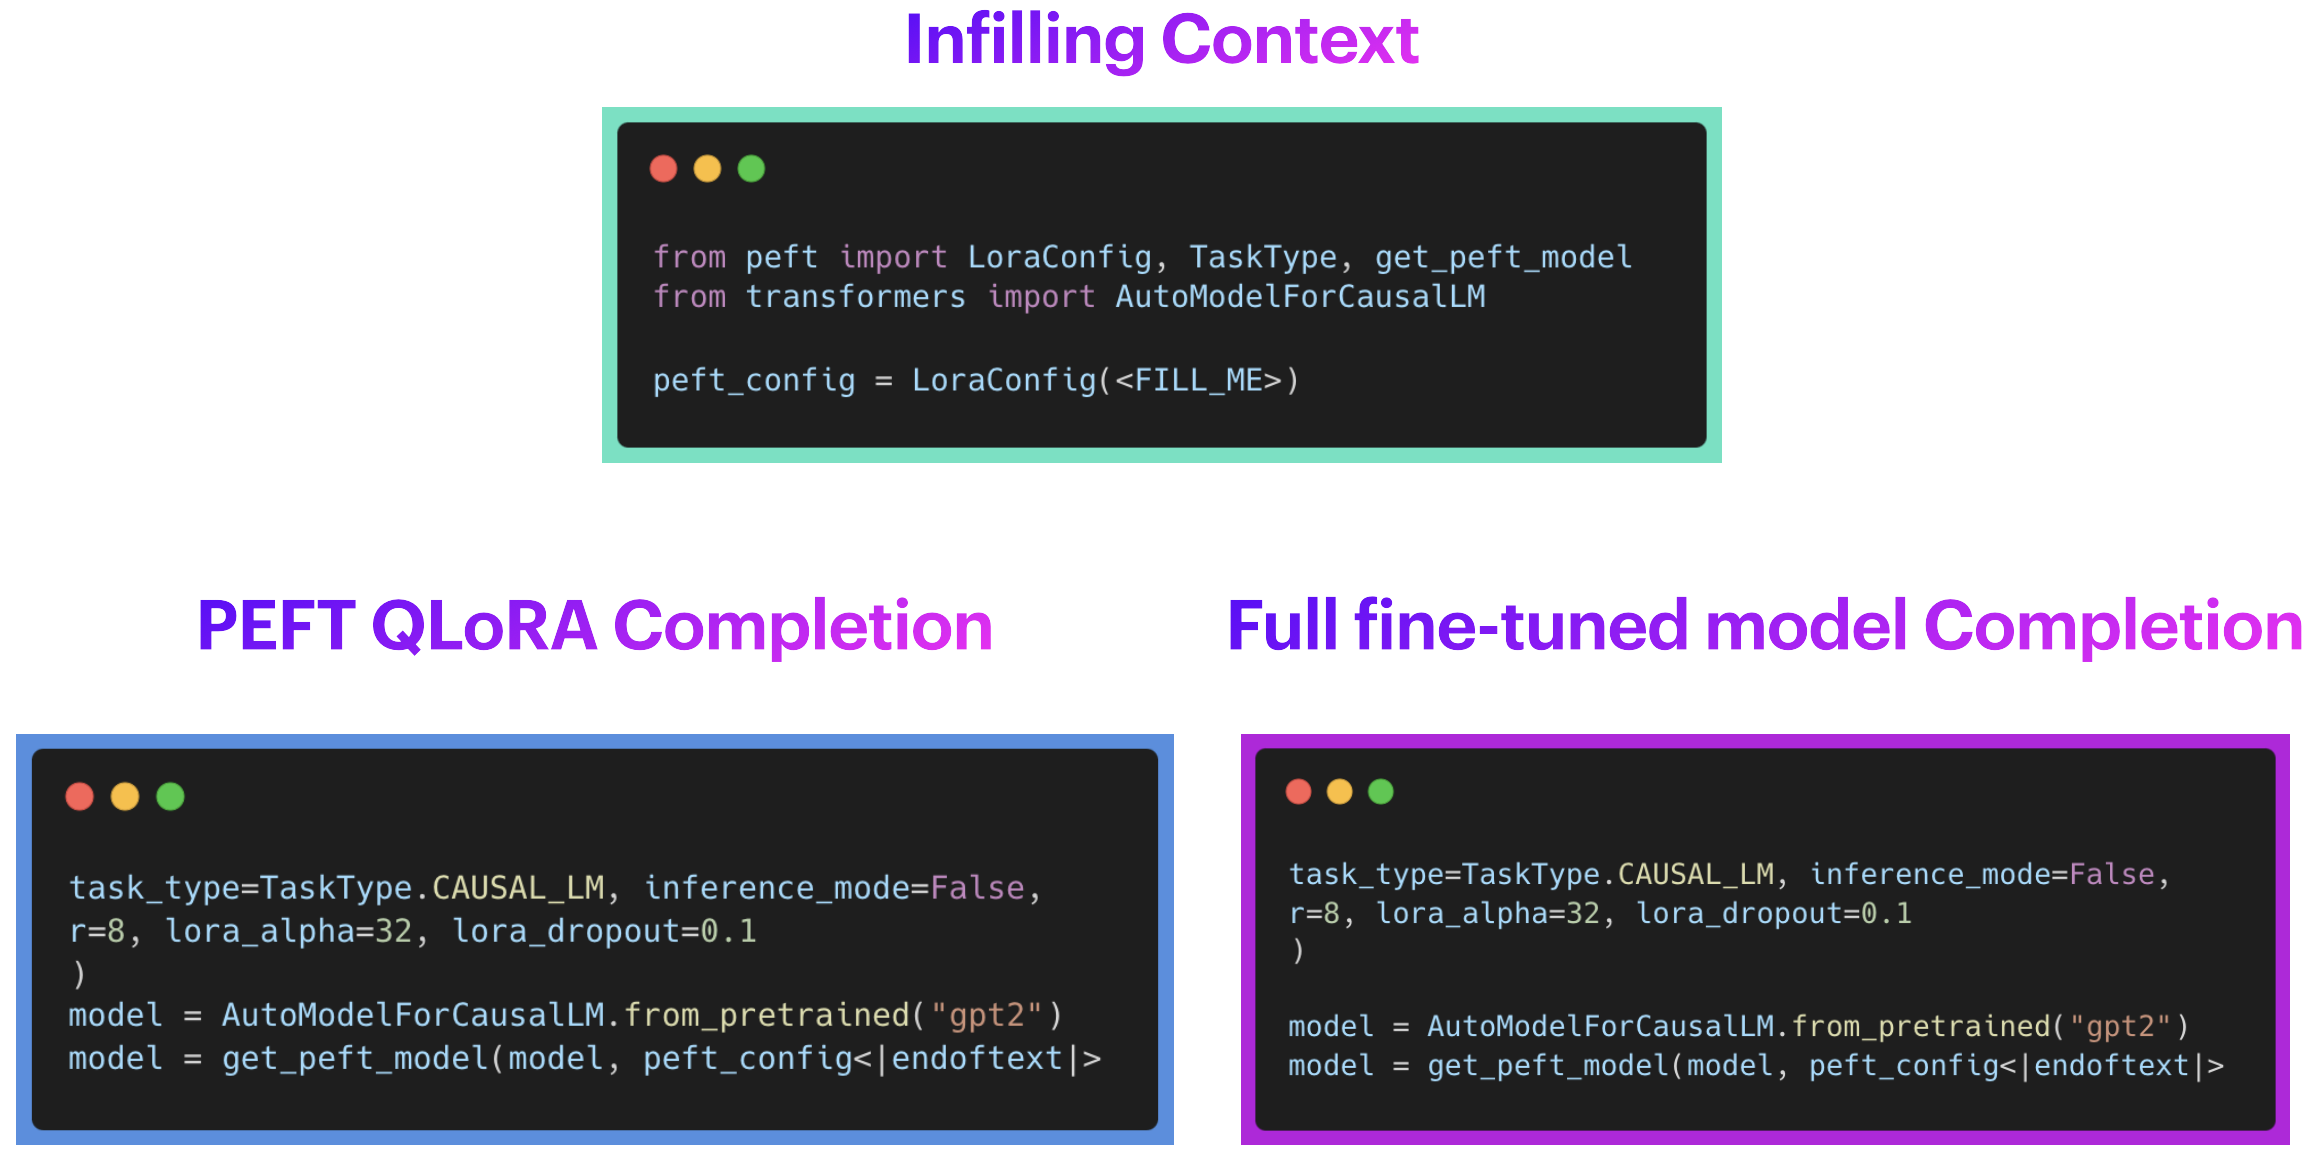 定性示例 2
在上面的第二个示例中,GitHub Copilot 没有给出任何补全。这可能是因为 🤗 PEFT 是一个较新的库,尚未包含在 Copilot 的训练数据中,而这正是我们试图解决的问题类型。另一方面,来自 QLoRA 和完全微调模型的补全正确地用必要的参数填充了整个函数调用。再次注意,QLoRA 和完全微调模型都给出了质量相似的生成结果。完全微调模型和 peft 模型的推理代码及各种示例分别可在 Full_Finetuned_StarCoder_Inference.ipynb 和 PEFT_StarCoder_Inference.ipynb 中获取。
因此,我们可以观察到两个变体的生成结果都符合预期。太棒了!🚀
如何在 VS Code 中使用它?
你可以使用 🤗 llm-vscode VS Code 扩展,并通过 🤗 Inference EndPoints 托管模型,轻松在 VS Code 中配置自定义代码补全 LLM。我们将在下面介绍所需步骤。你可以在 inference endpoints 文档中了解更多关于部署端点的详细信息。
设置 Inference Endpoint
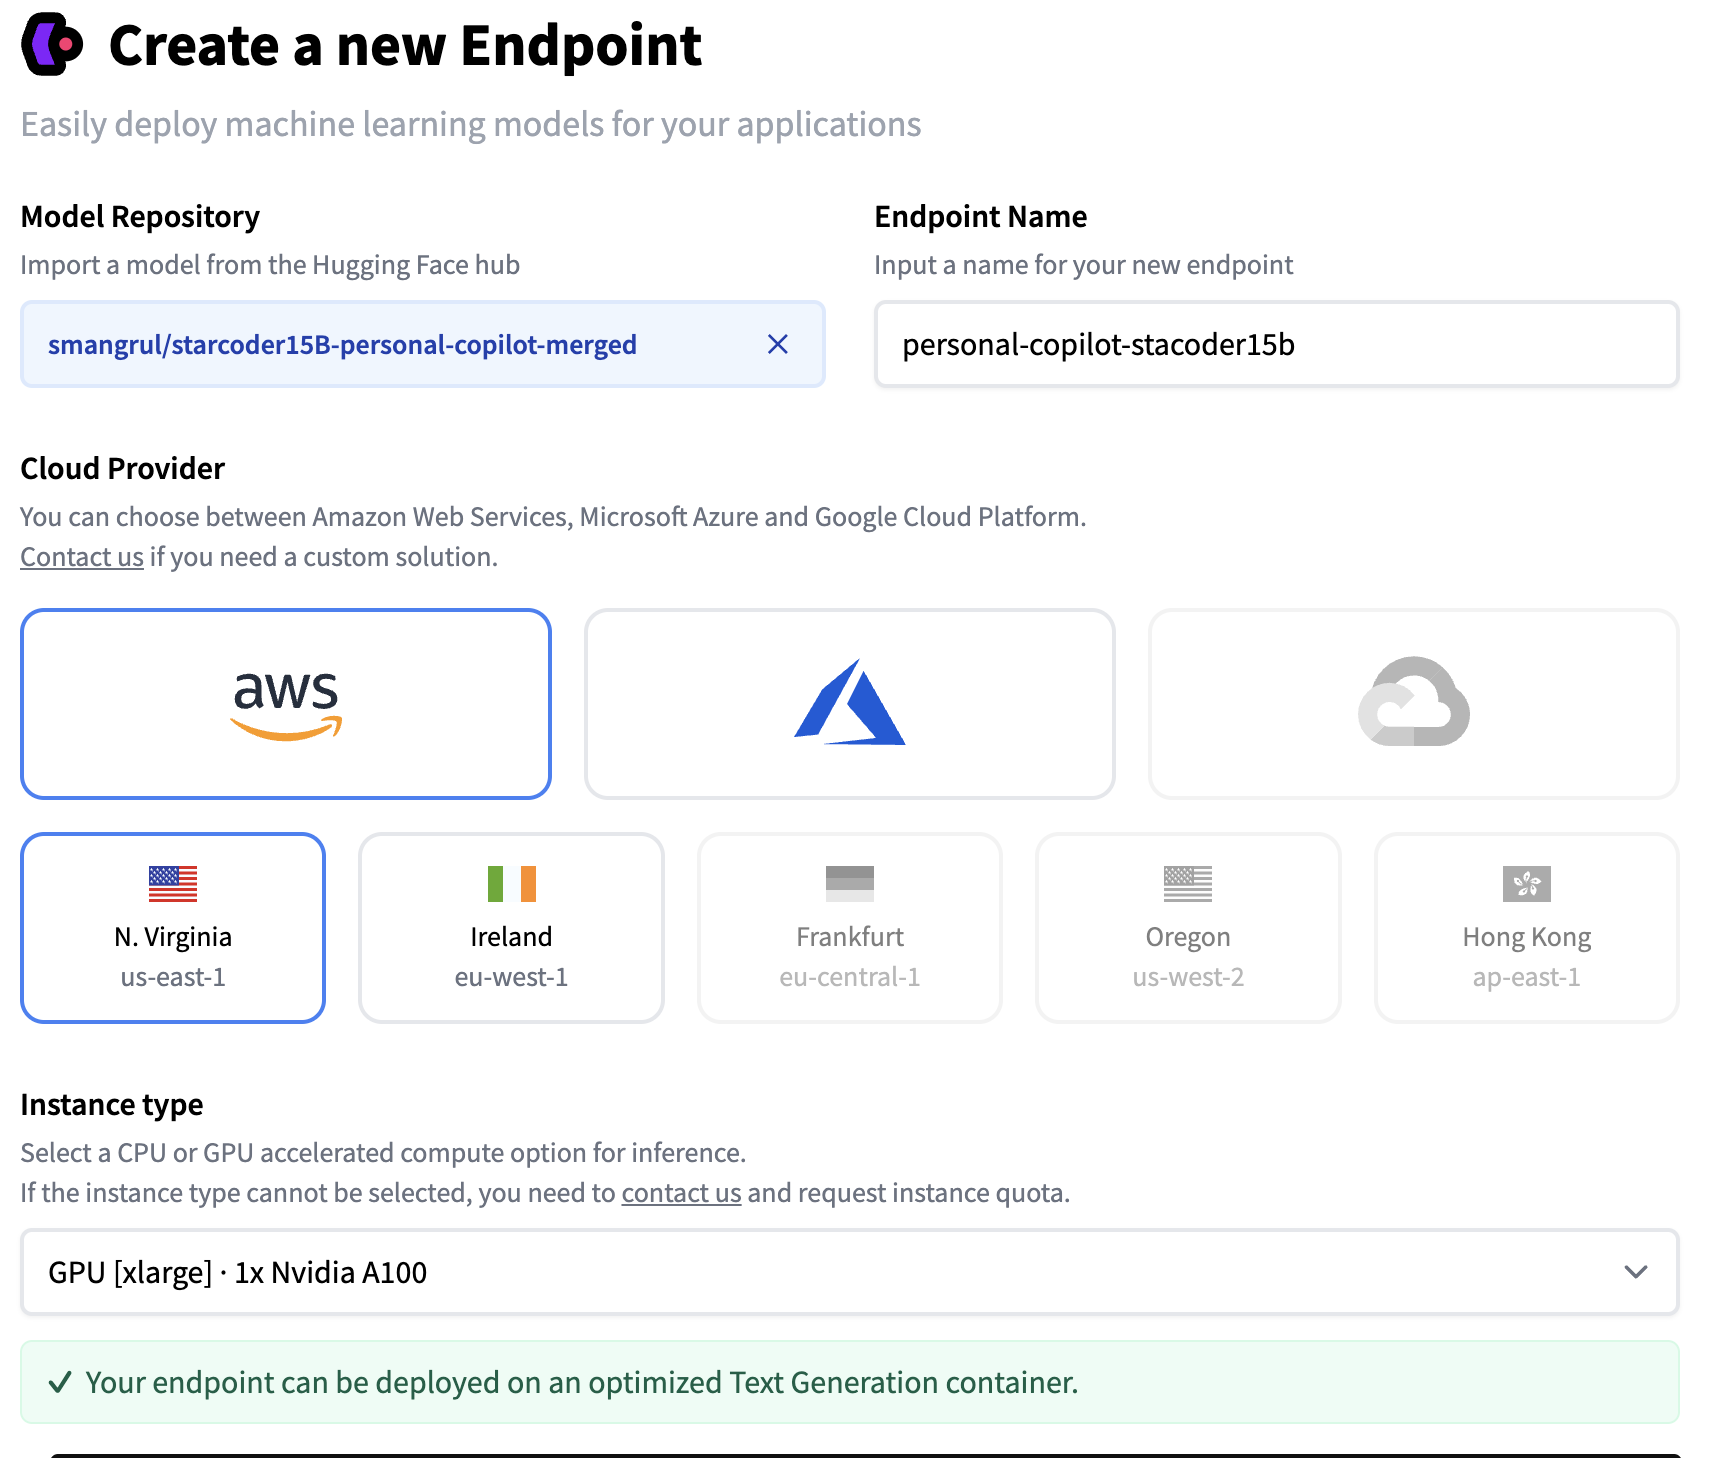
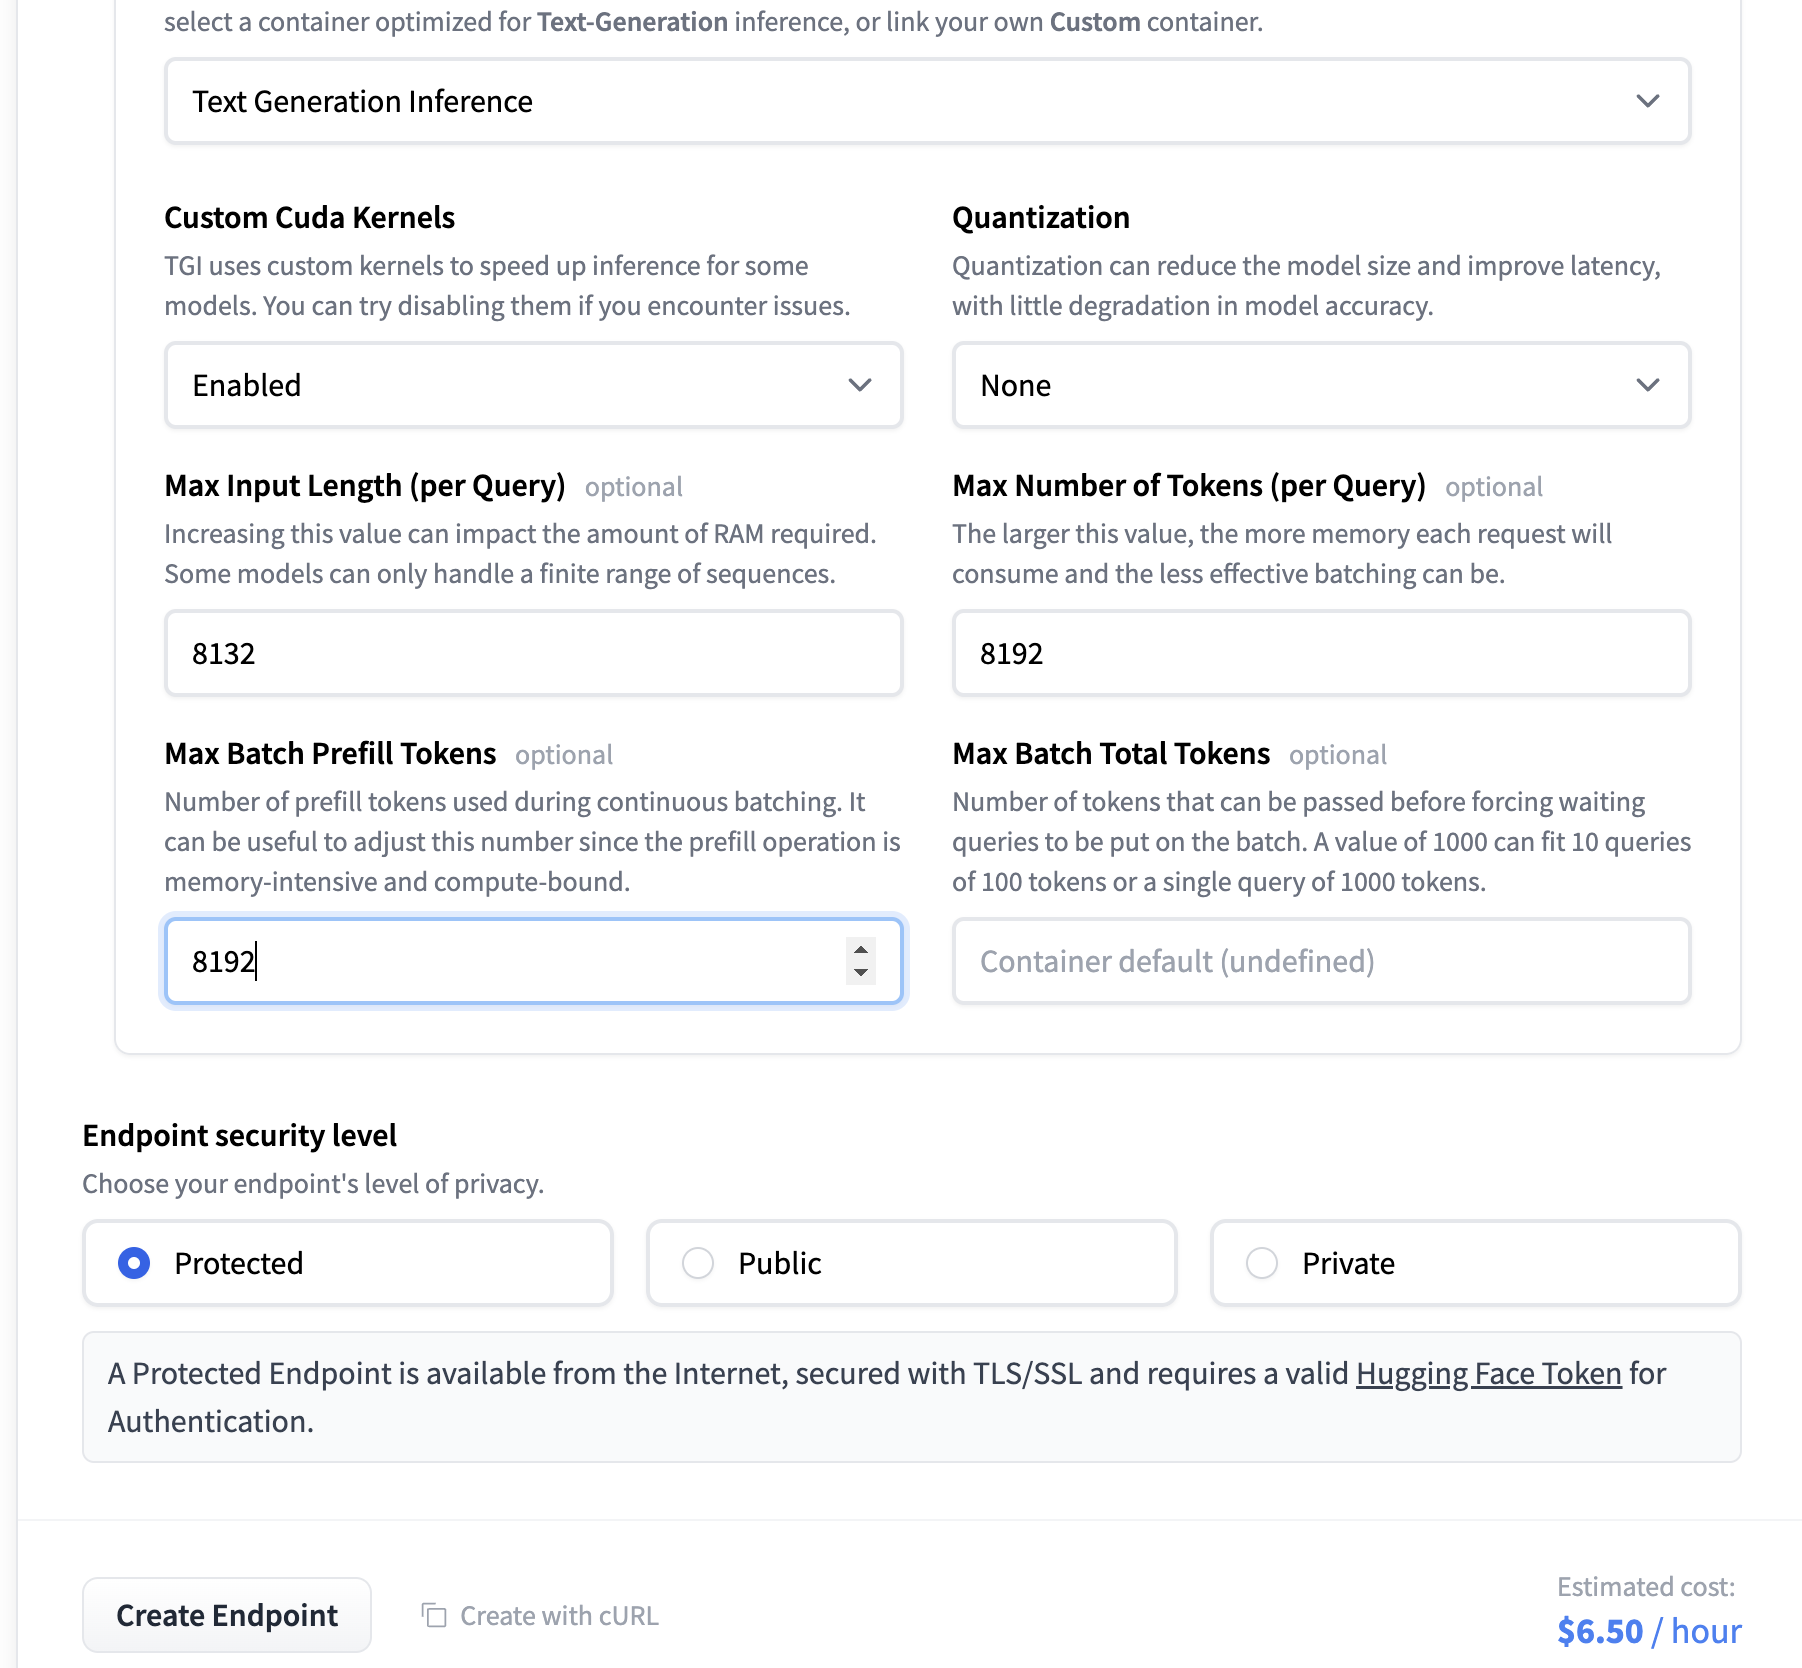
以下是创建自定义 Inference Endpoint 时所遵循步骤的截图。我们使用了 QLoRA 模型,将其导出为完整大小的合并模型,可以轻松在 transformers 中加载。
设置 VS Code 扩展
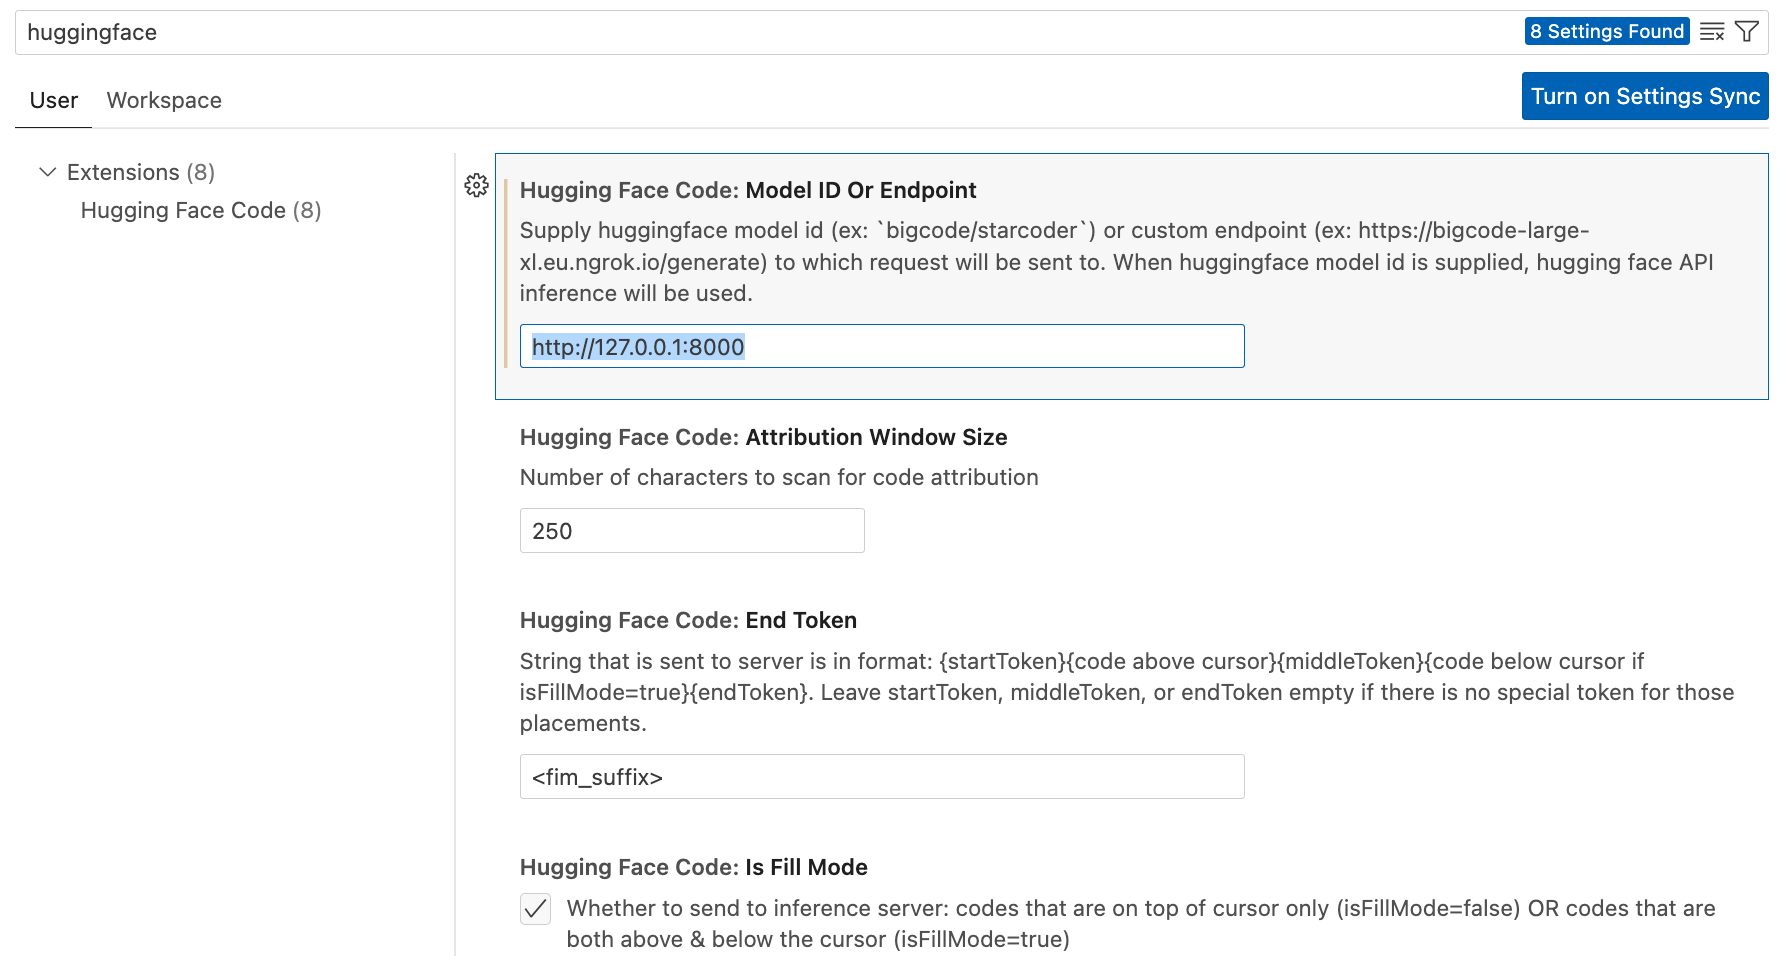
只需按照安装步骤操作。在设置中,替换下方字段中的端点,使其指向你部署的 HF Inference Endpoint。
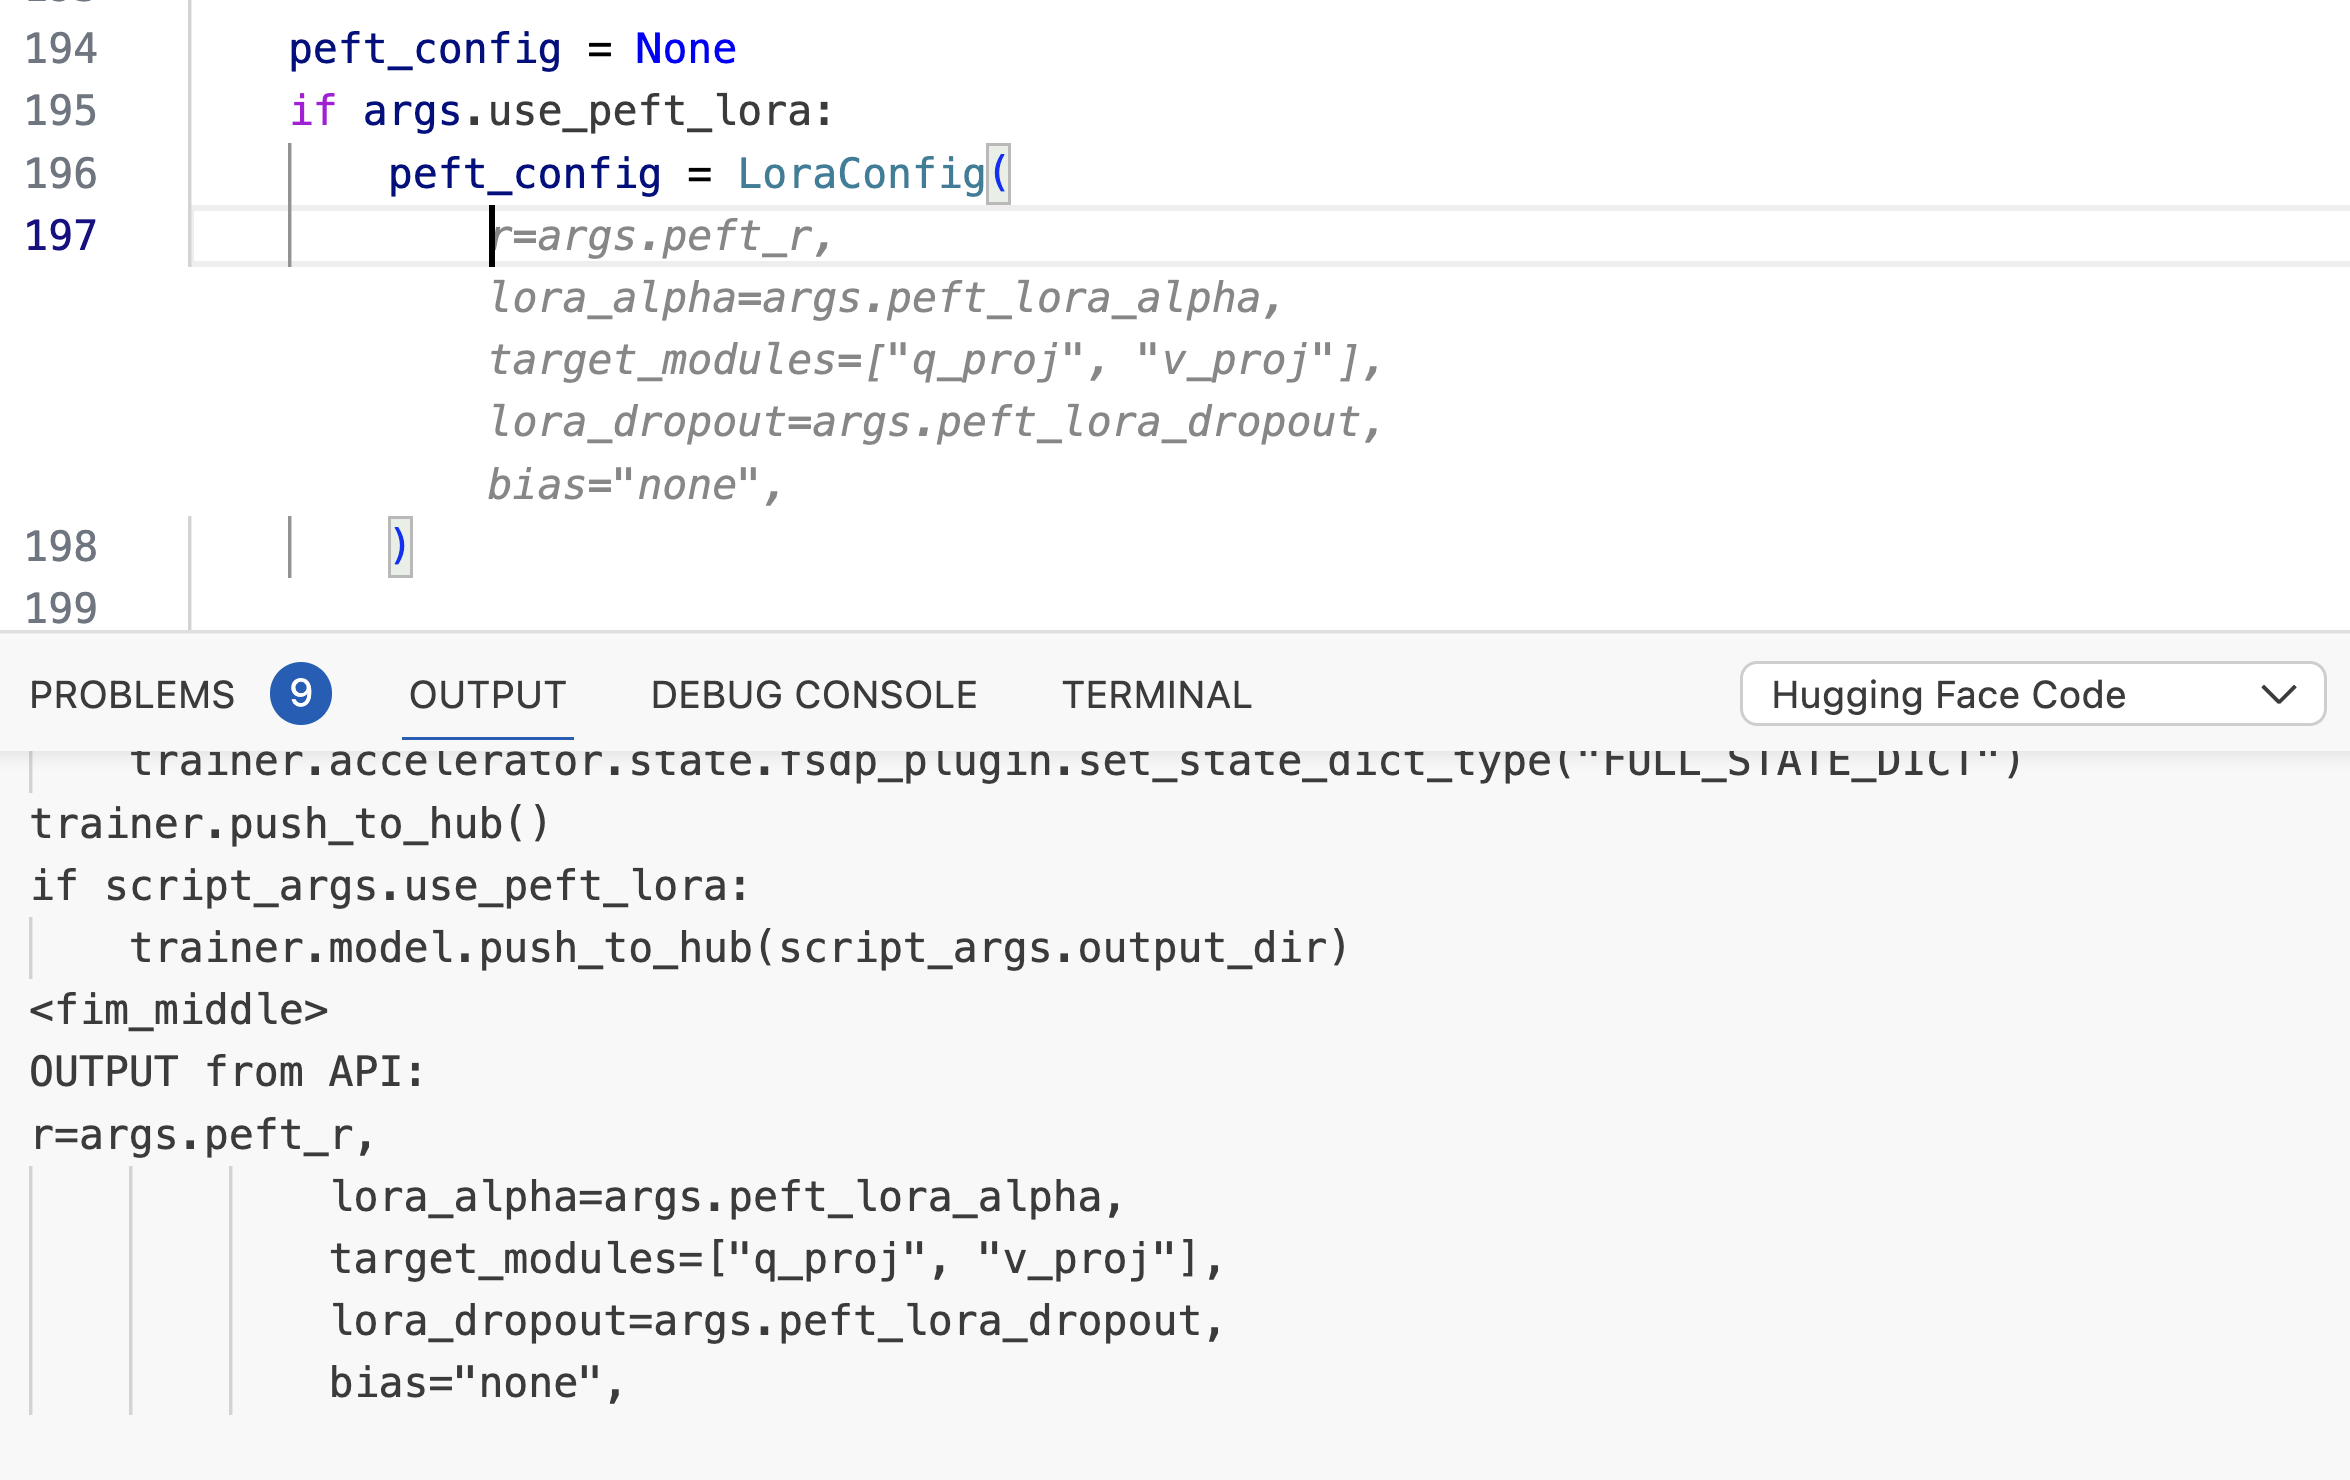
使用效果如下所示:
微调你自己的代码聊天助手
到目前为止,我们训练的模型都是专门作为代码补全任务的个人副驾驶进行训练的。它们并未经过训练来执行对话或问答。Octocoder 和 StarChat 就是此类模型的绝佳示例。本节简要介绍如何实现这一点。
资源
- 代码库:链接。它使用了 Transformers 中最近添加的 Flash Attention V2 支持。
- Colab notebook:链接。请确保选择具有高内存设置的 A100 GPU。
- 模型:bigcode/stacoderplus
- 数据集:smangrul/code-chat-assistant-v1。混合了
LIMA+GUANACO,并采用适合训练的格式进行了适当格式化。 - 训练后的模型:smangrul/peft-lora-starcoderplus-chat-asst-A100-40GB-colab
LoRA 之舞
如果你曾涉猎 Stable Diffusion 模型和 LoRA 来制作自己的 Dreambooth 模型,你可能熟悉将不同 LoRA 以不同权重组合、以及将 LoRA 模型与不同于其训练基础模型的基础模型一起使用的概念。在文本/代码领域,这仍是一片未探索的领域。我们在这方面进行了实验,并观察到了非常有前景的发现。准备好了吗?出发!🚀
混搭 LoRA
PEFT 目前支持 3 种组合 LoRA 模型的方式:linear、svd 和 cat。更多详情,请参阅 tuners#peft.LoraModel.add_weighted_adapter。
我们的 notebook Dance_of_LoRAs.ipynb 包含了所有推理代码以及各种 LoRA 加载组合,例如在 starcoder 之上加载聊天助手,而不是在 starcodeplus 上加载,后者是我们微调的基础模型。
在这里,我们将考虑 2 种能力(chatting/QA 和 code-completion)在 2 种数据分布(top 10 public hf codebase 和 generic codebase)上的表现。这为我们提供了 4 个维度,我们将在这些维度上进行一些定性评估分析。
首先,让我们考虑 chatting/QA 任务。
如果我们禁用适配器,我们会观察到两个数据集上的任务都失败了,因为基础模型(starcoder)仅用于代码补全,不适合 chatting/question-answering。启用 copilot 适配器的表现与禁用情况类似,因为这个 LoRA 也是专门为代码补全微调的。
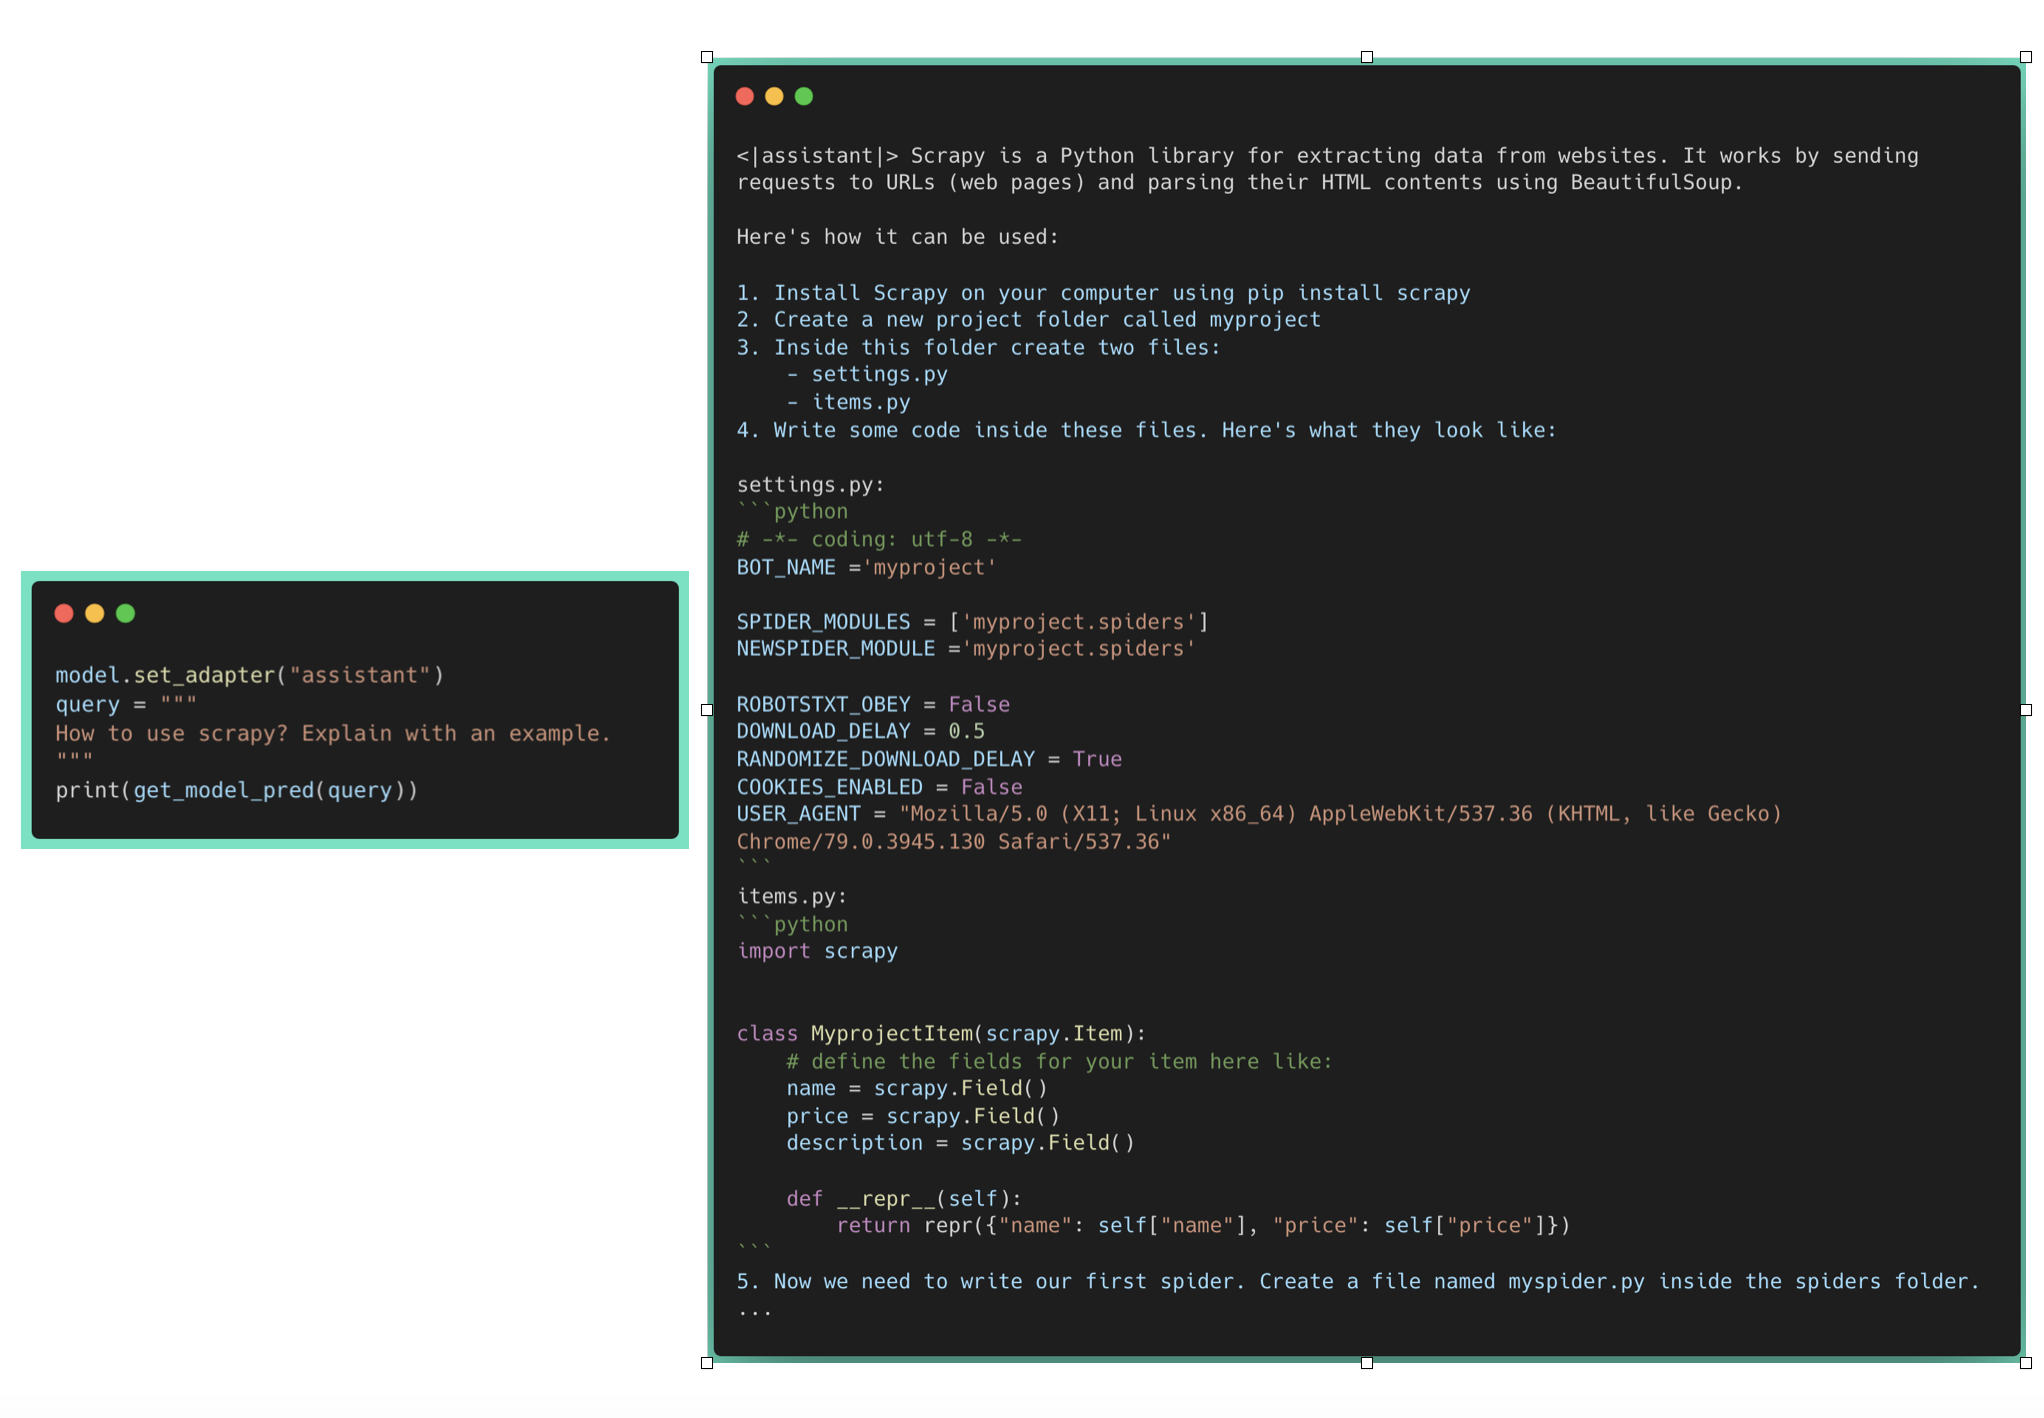
现在,让我们启用 assistant 适配器。
 基于通用代码的问答
 基于 HF 代码的问答
我们可以观察到,关于 scrapy 的通用问题得到了正确回答。然而,对于 HF 代码相关的问题却失败了,因为这些问题不在其预训练数据中。
现在让我们考虑 code-completion 任务。
禁用适配器时,我们观察到通用 two-sum 的代码补全按预期工作。然而,HF 代码补全失败,向 LoraConfig 传递了错误的参数,因为基础模型在其预训练数据中未曾见过它。启用 assistant 的表现与禁用情况类似,因为它是在自然语言对话上训练的,其中不包含任何 Hugging Face 代码仓库。
现在,让我们启用 copilot 适配器。
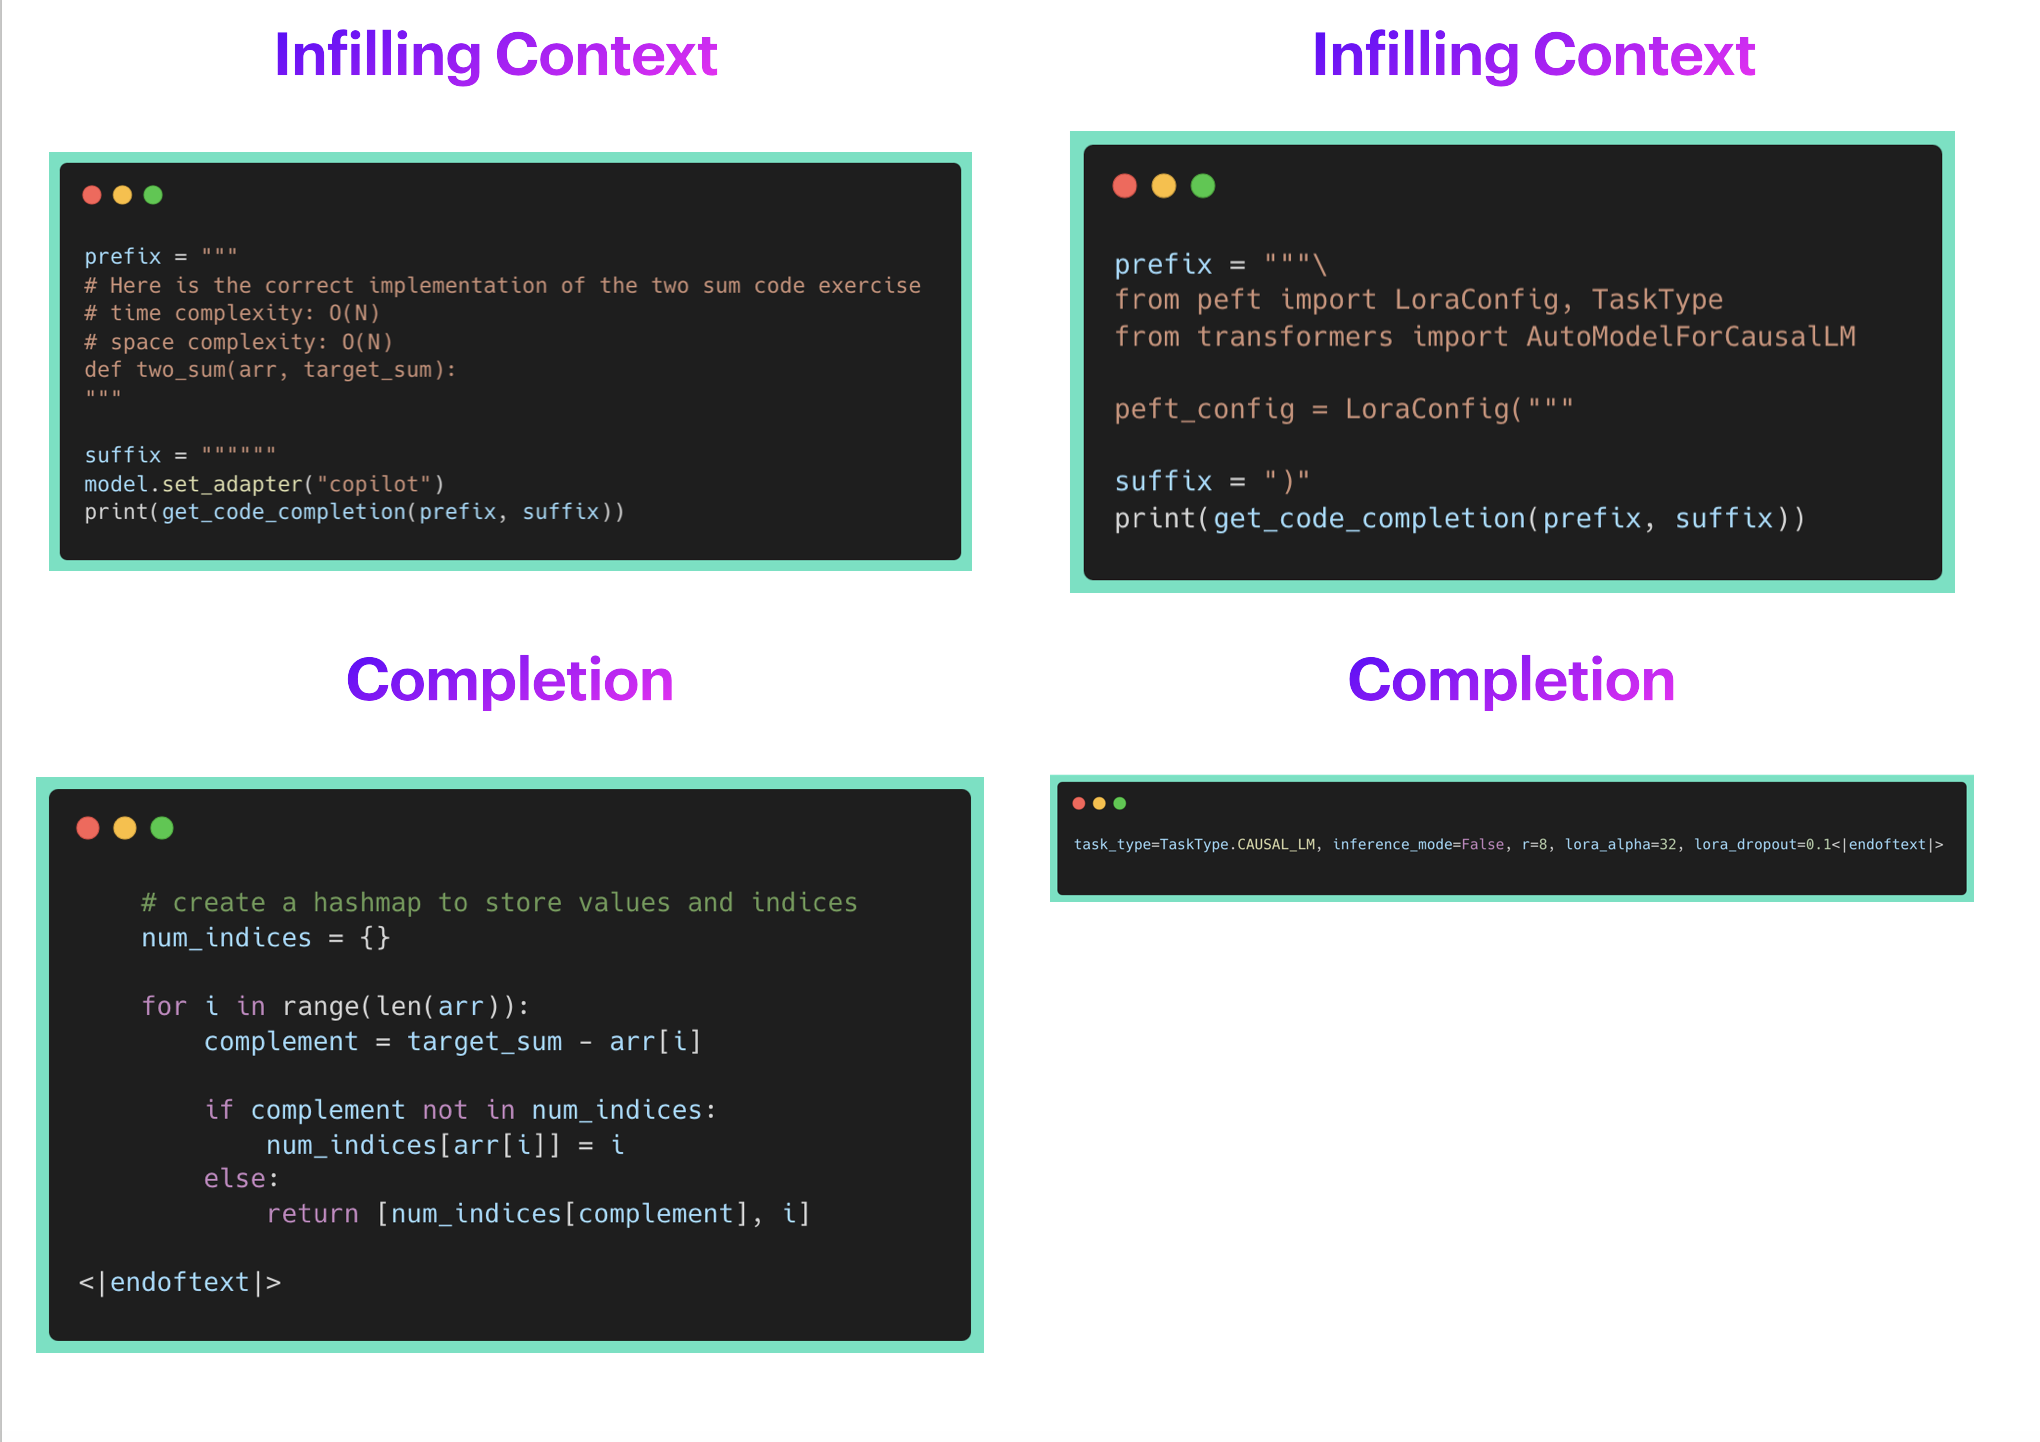
我们可以观察到,copilot 适配器在两种情况下都能正确处理。因此,在处理 HF 特定代码库以及通用代码库时,它在代码补全方面表现符合预期。
现在,作为用户,我希望结合 assistant 以及 copilot 的能力。这将使我能够在 IDE 中编码时使用它进行代码补全,同时也能将其作为聊天机器人来回答我关于 API、类、方法、文档的问题。它应该能够针对我的代码库回答诸如 How do I use x、Please write a code snippet for Y 之类的问题。
PEFT 允许你通过 add_weighted_adapter 来实现这一点。让我们创建一个新的适配器 code_buddy,其权重与 assistant 和 copilot 适配器相等。
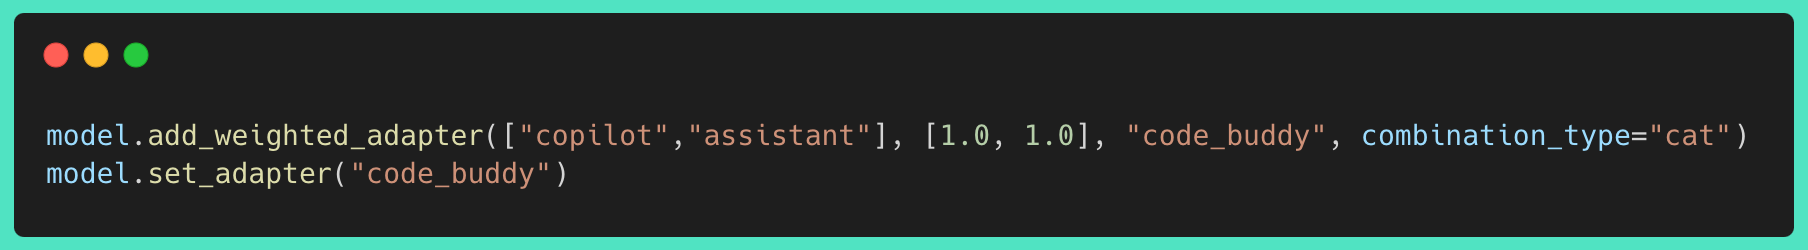 组合多个适配器
现在,让我们看看 code_buddy 在 chatting/question_answering 任务上的表现。
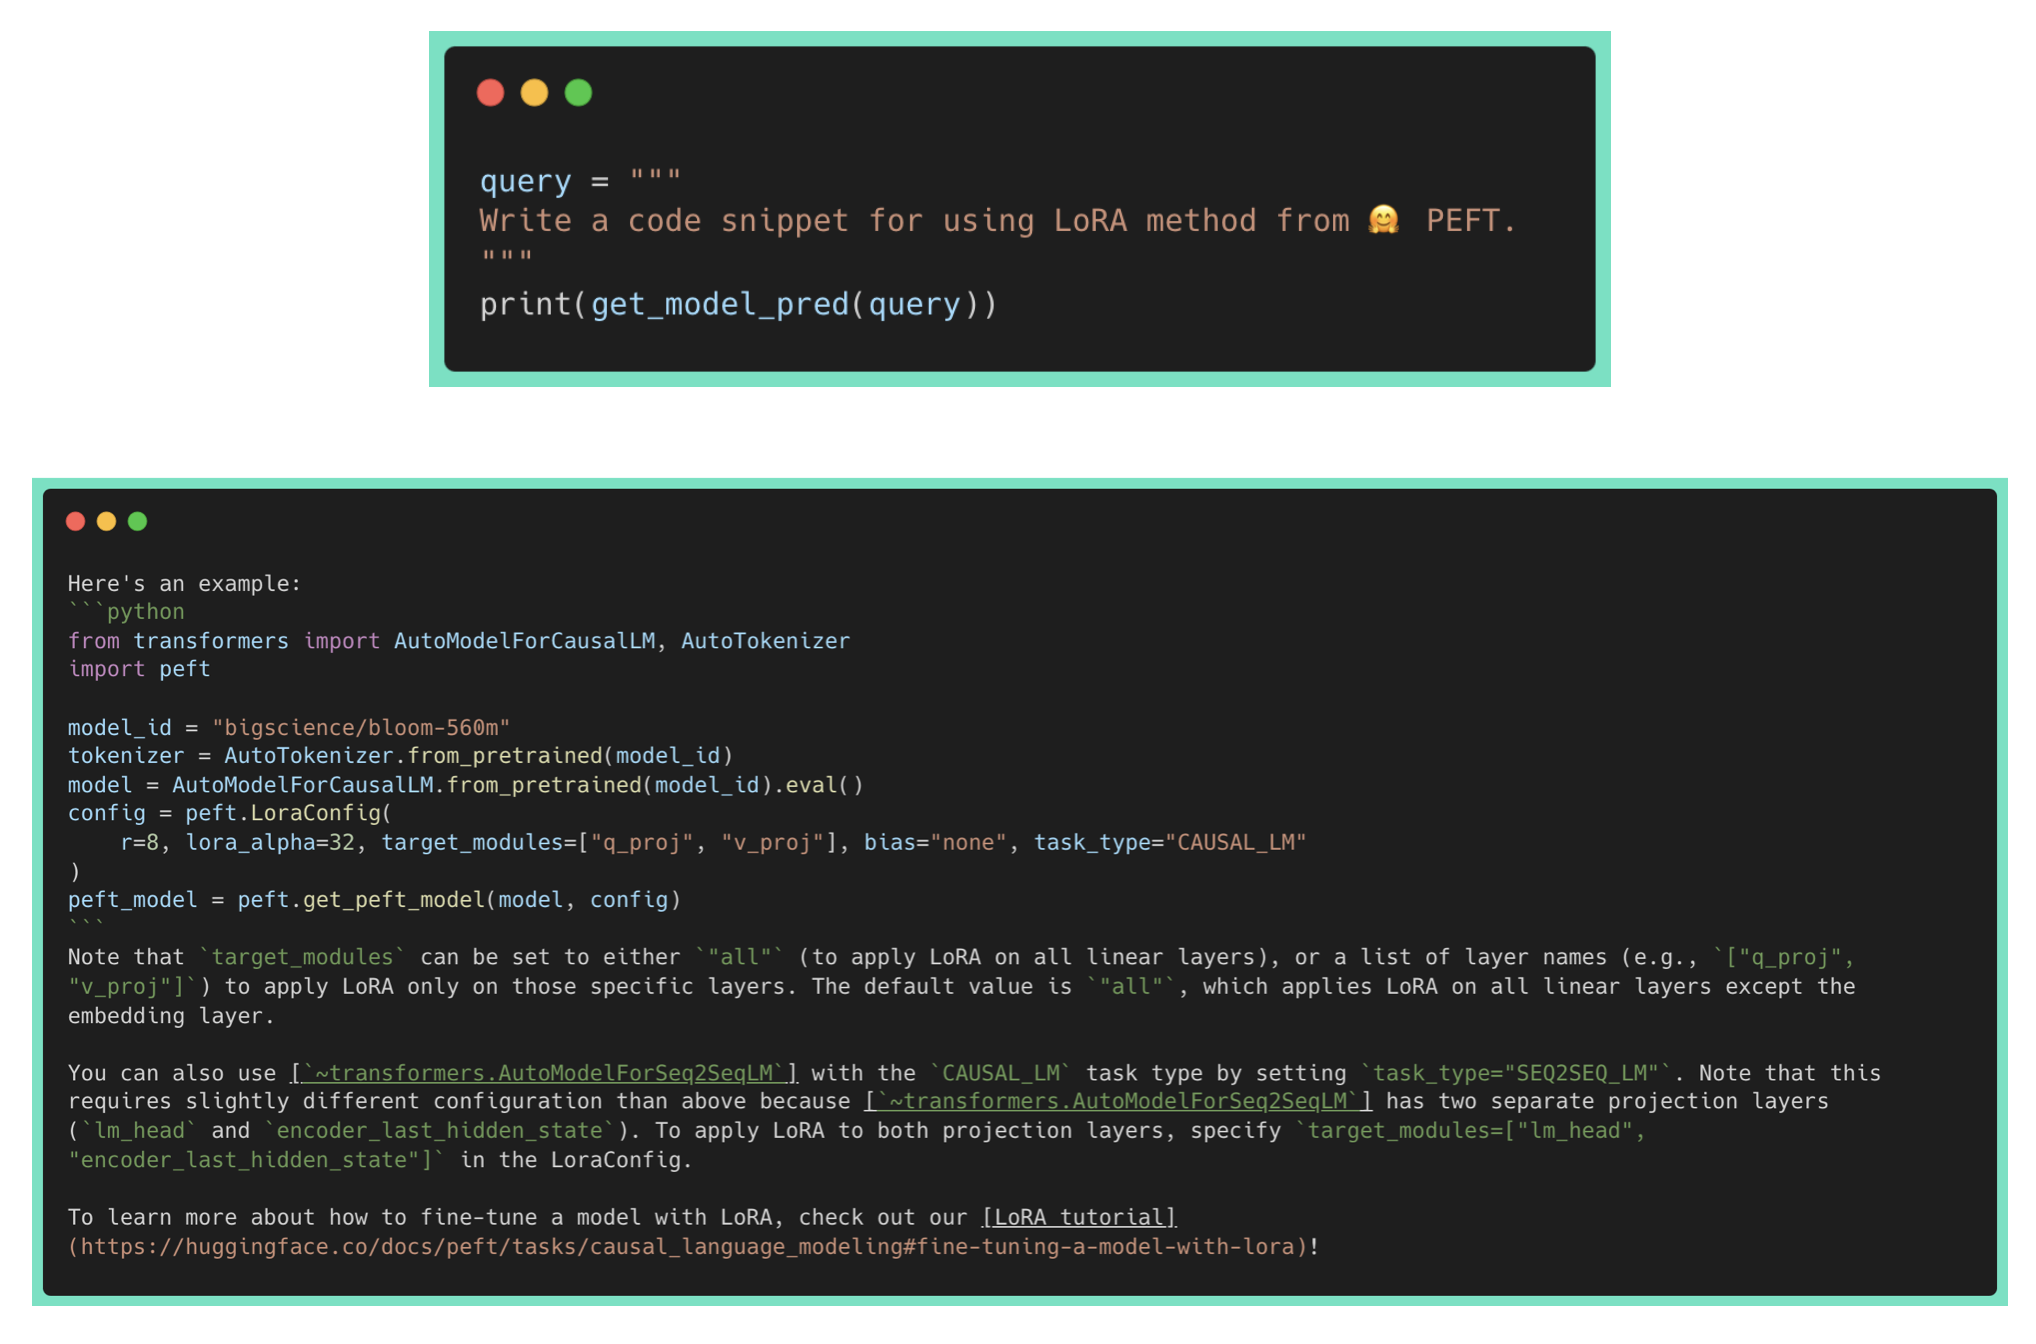
我们可以观察到,code_buddy 的表现远好于单独的 assistant 或 copilot 适配器!它能够回答 编写代码片段 的请求,展示如何使用特定的 HF 仓库 API。然而,它也会产生错误的链接/解释,这仍然是 LLM 面临的一个开放挑战。
以下是 code_buddy 在代码补全任务上的表现。
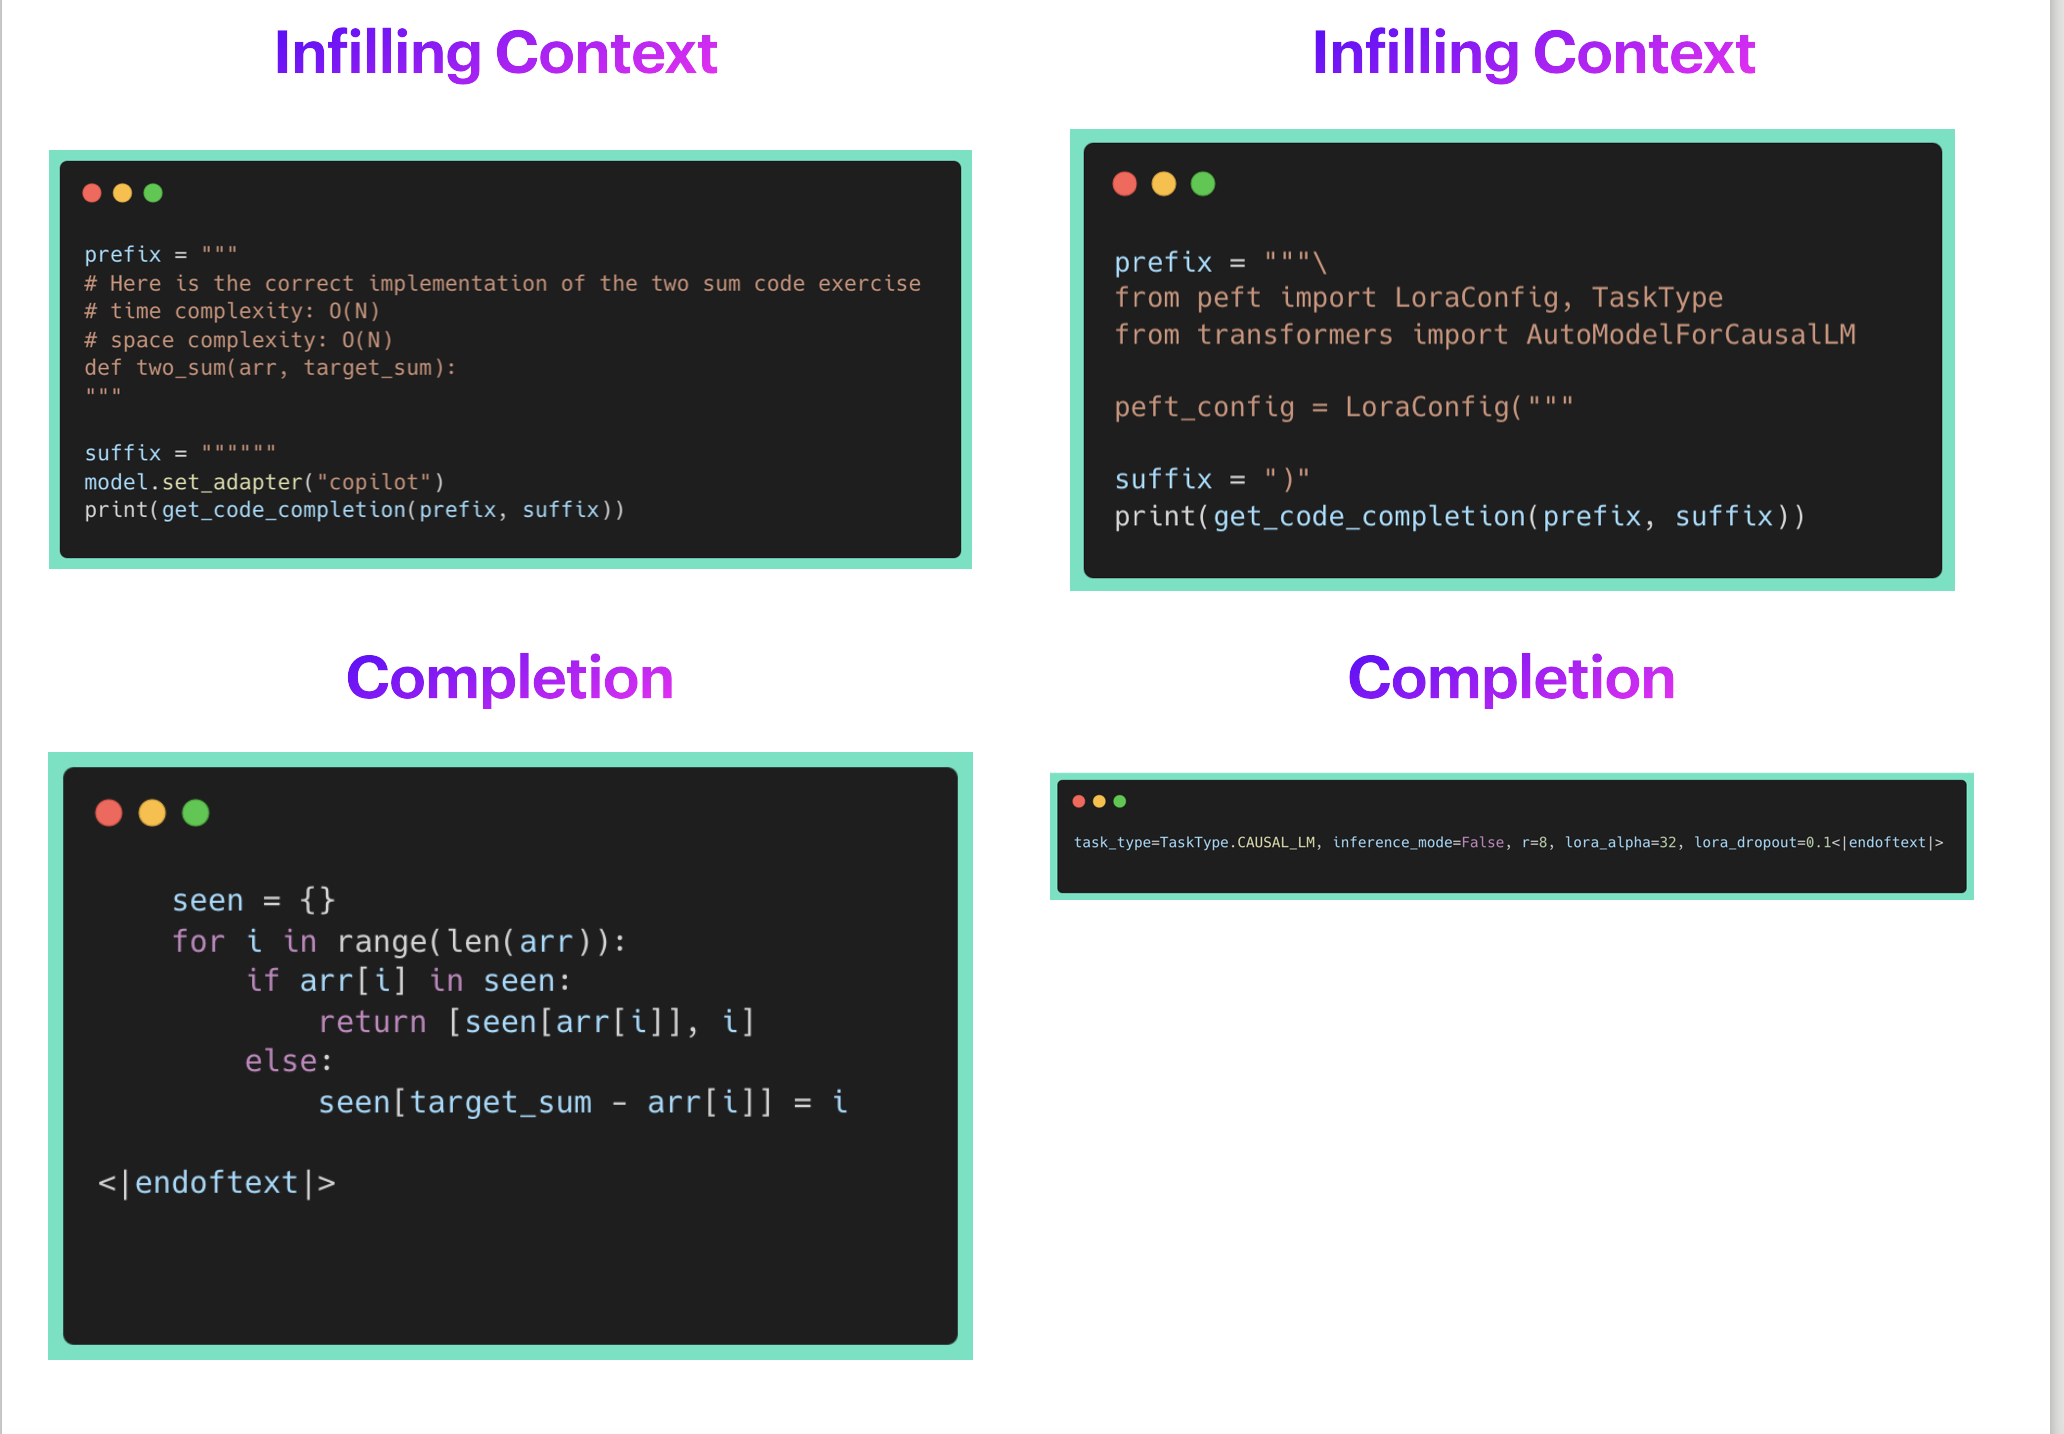
我们可以观察到,code_buddy 的表现与专门为此任务微调的 copilot 不相上下。
将 LoRA 迁移到不同的基础模型
我们还可以将 LoRA 模型迁移到不同的基础模型。我们将采用最新的 Octocoder 模型,并将我们在 starcoder 基础模型上训练的上述 LoRA 应用于它。请参阅以下 notebook PEFT_Personal_Code_CoPilot_Adapter_Transfer_Octocoder.ipynb 获取完整代码。
代码补全任务上的表现
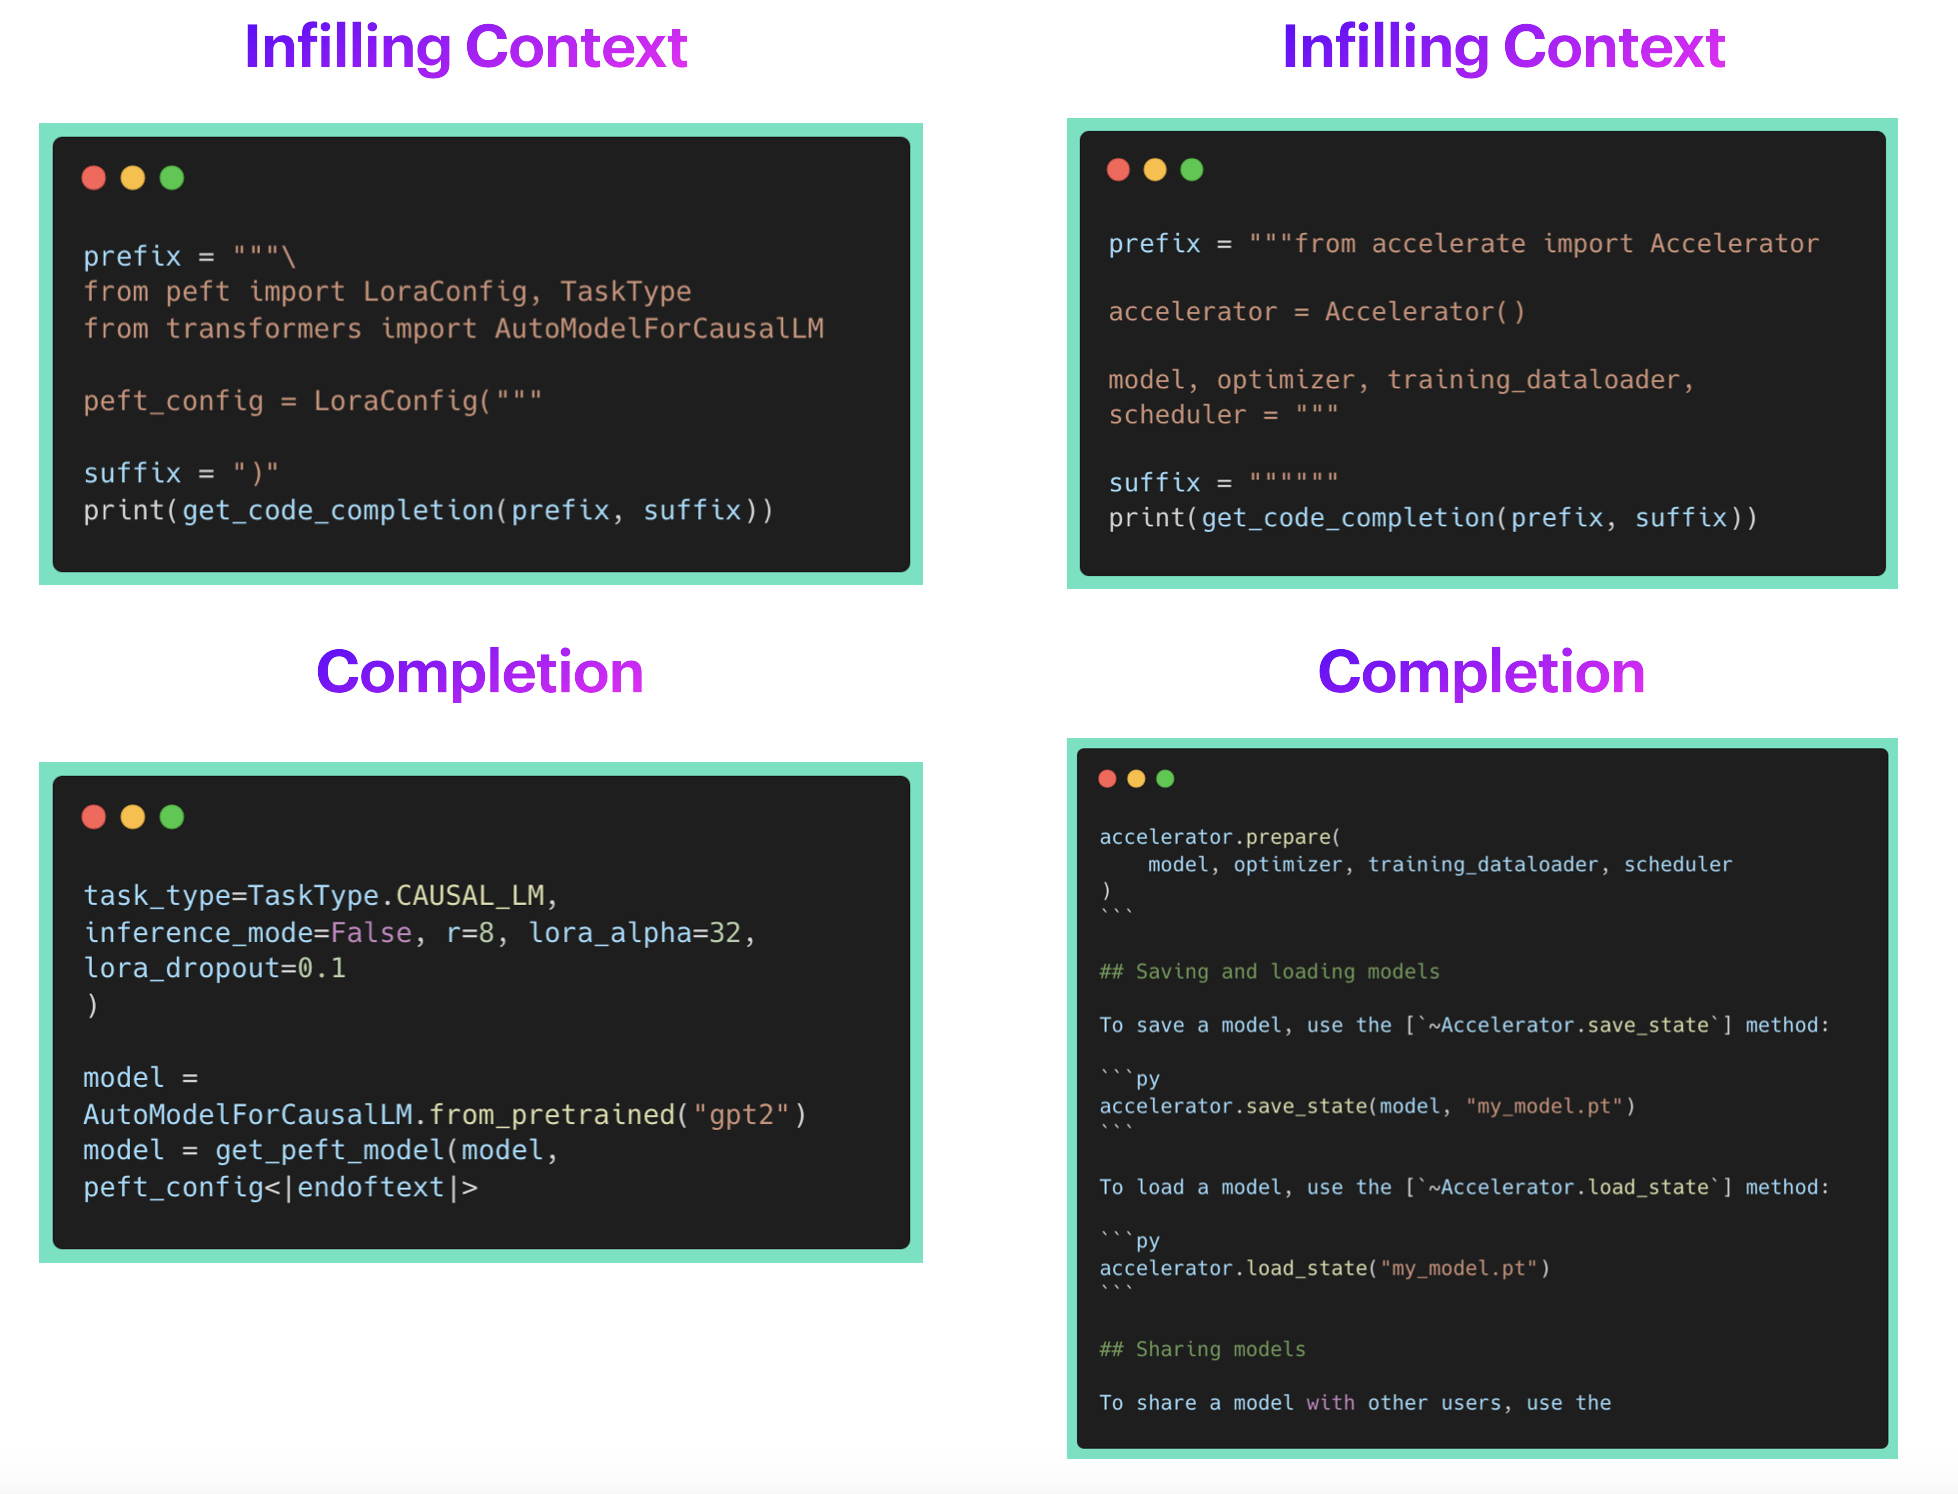
我们可以观察到,octocoder 表现很棒。它能够补全 HF 特定的代码片段。如 notebook 中所示,它也能够补全通用代码片段。
聊天/问答任务上的表现
由于 Octocoder 被训练来回答问题和进行关于编码的对话,让我们看看它能否使用我们的 LoRA 适配器来回答 Hugging Face 相关的问题。
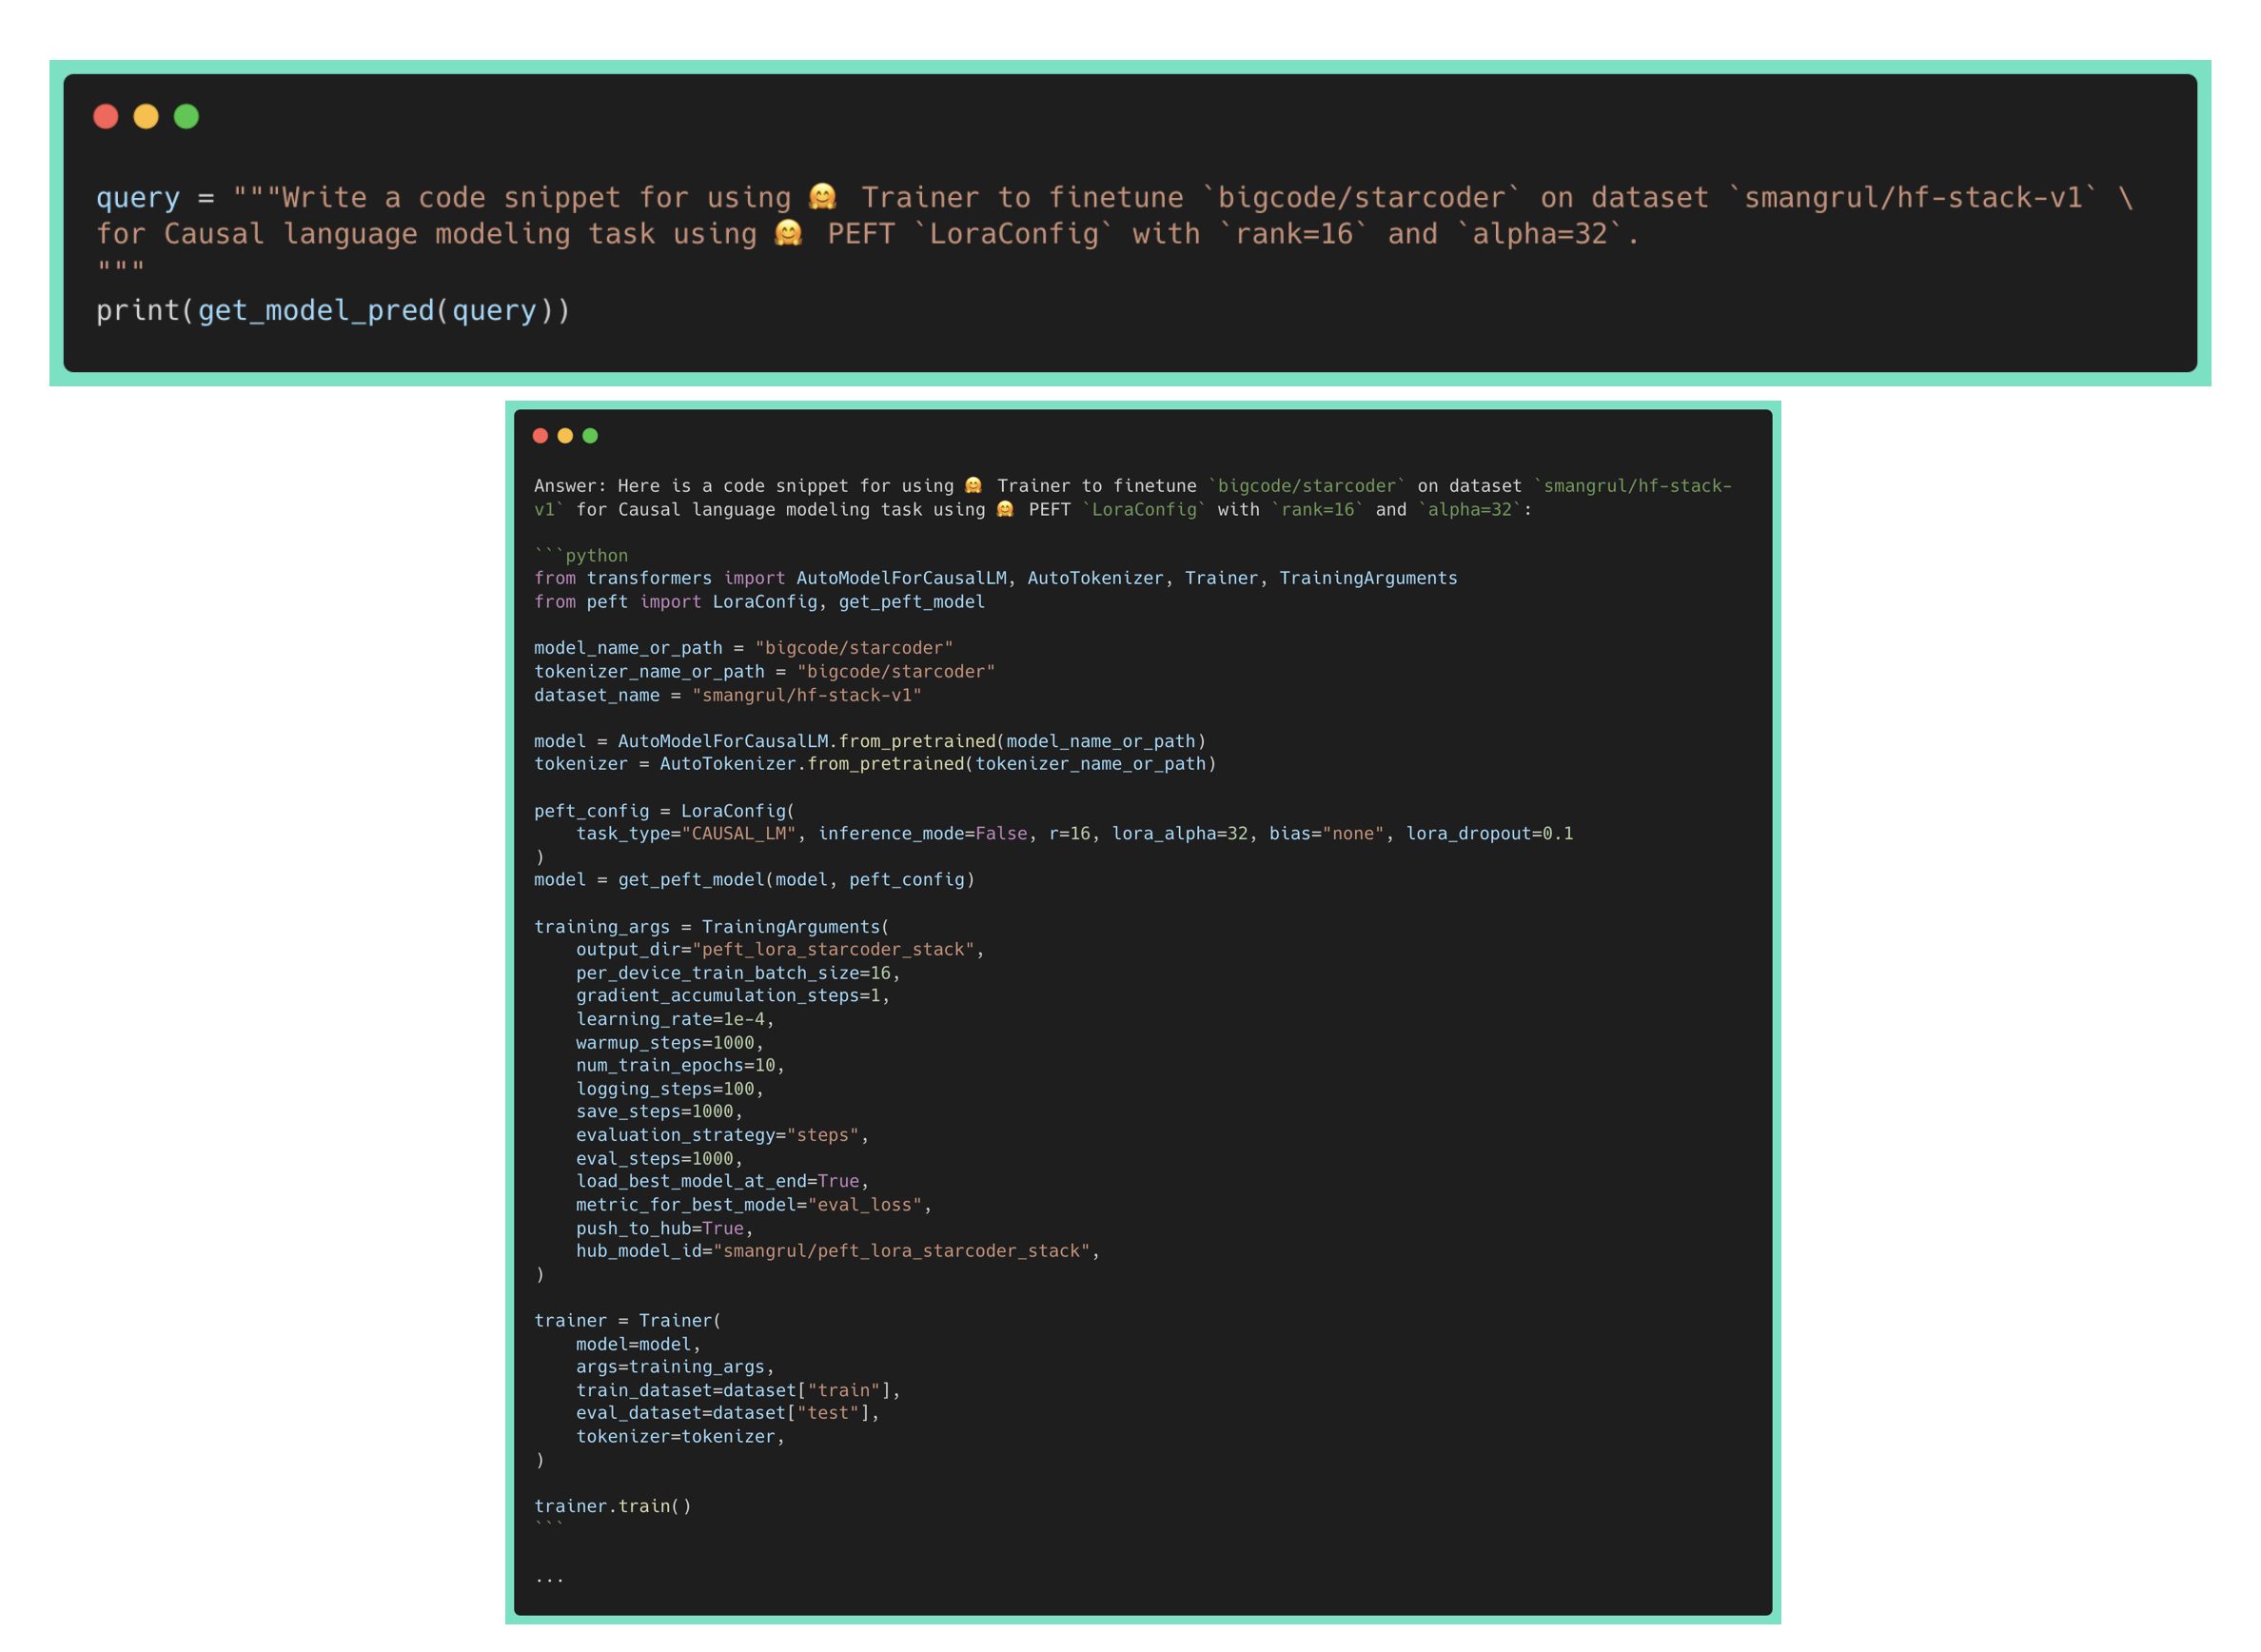
耶!它正确地详细回答了如何创建 LoraConfig 以及相关的 peft 模型,并正确使用了模型名称、数据集名称以及 LoraConfig 的参数值。在禁用适配器后,它无法正确使用 LoraConfig 的 API 或创建 PEFT 模型,这表明这些内容不在 Octocoder 的训练数据中。
如何在本地运行它?
我知道,在经历了这一切之后,你想在你的代码库上微调 starcoder,并在你的消费级硬件上本地使用它,比如配备 M1 GPU 的 Mac 笔记本电脑、配备 RTX 4090/3090 GPU 的 Windows 电脑…… 别担心,我们已经为你准备好了。
我们将使用这个超级酷的开源库 mlc-llm 🔥。具体来说,我们将使用这个分支 pacman100/mlc-llm,它包含了一些改动,使其能够与 VS Code 的 Hugging Face Code Completion 扩展配合使用。在我的配备 M1 Metal GPU 的 Mac 笔记本电脑上,15B 模型慢得令人痛苦。因此,我们将从小处着手,训练一个 PEFT LoRA 版本以及一个完全微调版本的 bigcode/starcoderbase-1b。训练用的 colab notebook 链接如下:
- 用于
starcoderbase-1b的完全微调和 PEFT LoRA 微调的 Colab notebook:链接
训练损失、评估损失以及学习率调度图如下所示:
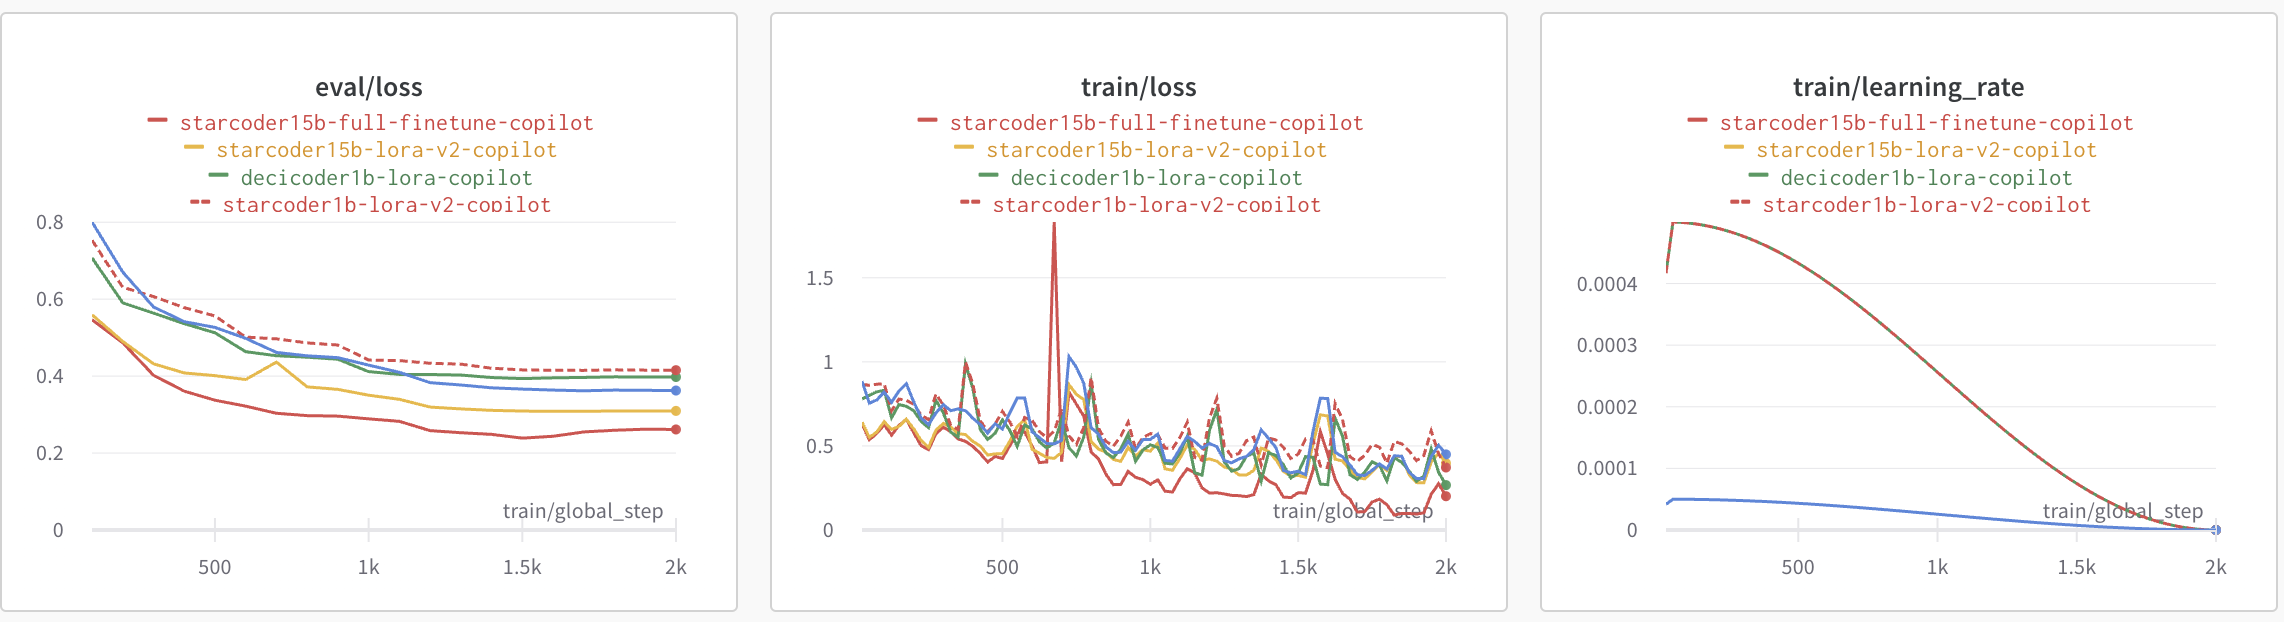
现在,我们将介绍在本地托管合并后的模型 smangrul/starcoder1B-v2-personal-copilot-merged 并将其与 🤗 llm-vscode VS Code 扩展一起使用的详细步骤。
- 克隆仓库
git clone --recursive https://github.com/pacman100/mlc-llm.git && cd mlc-llm/
- 安装 mlc-ai 和 mlc-chat(以可编辑模式):
pip install --pre --force-reinstall mlc-ai-nightly mlc-chat-nightly -f https://mlc.ai/wheels
cd python
pip uninstall mlc-chat-nightly
pip install -e "."
- 通过以下方式编译模型:
time python3 -m mlc_llm.build --hf-path smangrul/starcoder1B-v2-personal-copilot-merged --target metal --use-cache=0
- 在
dist/starcoder1B-v2-personal-copilot-merged-q4f16_1/params/mlc-chat-config.json中用以下值更新配置:
{
    "model_lib": "starcoder7B-personal-copilot-merged-q4f16_1",
    "local_id": "starcoder7B-personal-copilot-merged-q4f16_1",
    "conv_template": "code_gpt",
-    "temperature": 0.7,
+    "temperature": 0.2,
-    "repetition_penalty": 1.0,
    "top_p": 0.95,
-    "mean_gen_len": 128,
+    "mean_gen_len": 64,
-    "max_gen_len": 512,
+    "max_gen_len": 64,
    "shift_fill_factor": 0.3,
    "tokenizer_files": [
        "tokenizer.json",
        "merges.txt",
        "vocab.json"
    ],
    "model_category": "gpt_bigcode",
    "model_name": "starcoder1B-v2-personal-copilot-merged"
}
- 运行本地服务器:
python -m mlc_chat.rest --model dist/starcoder1B-v2-personal-copilot-merged-q4f16_1/params --lib-path dist/starcoder1B-v2-personal-copilot-merged-q4f16_1/starcoder1B-v2-personal-copilot-merged-q4f16_1-metal.so
- 将 VS Code 中 HF Code Completion 扩展的端点更改为指向本地服务器:
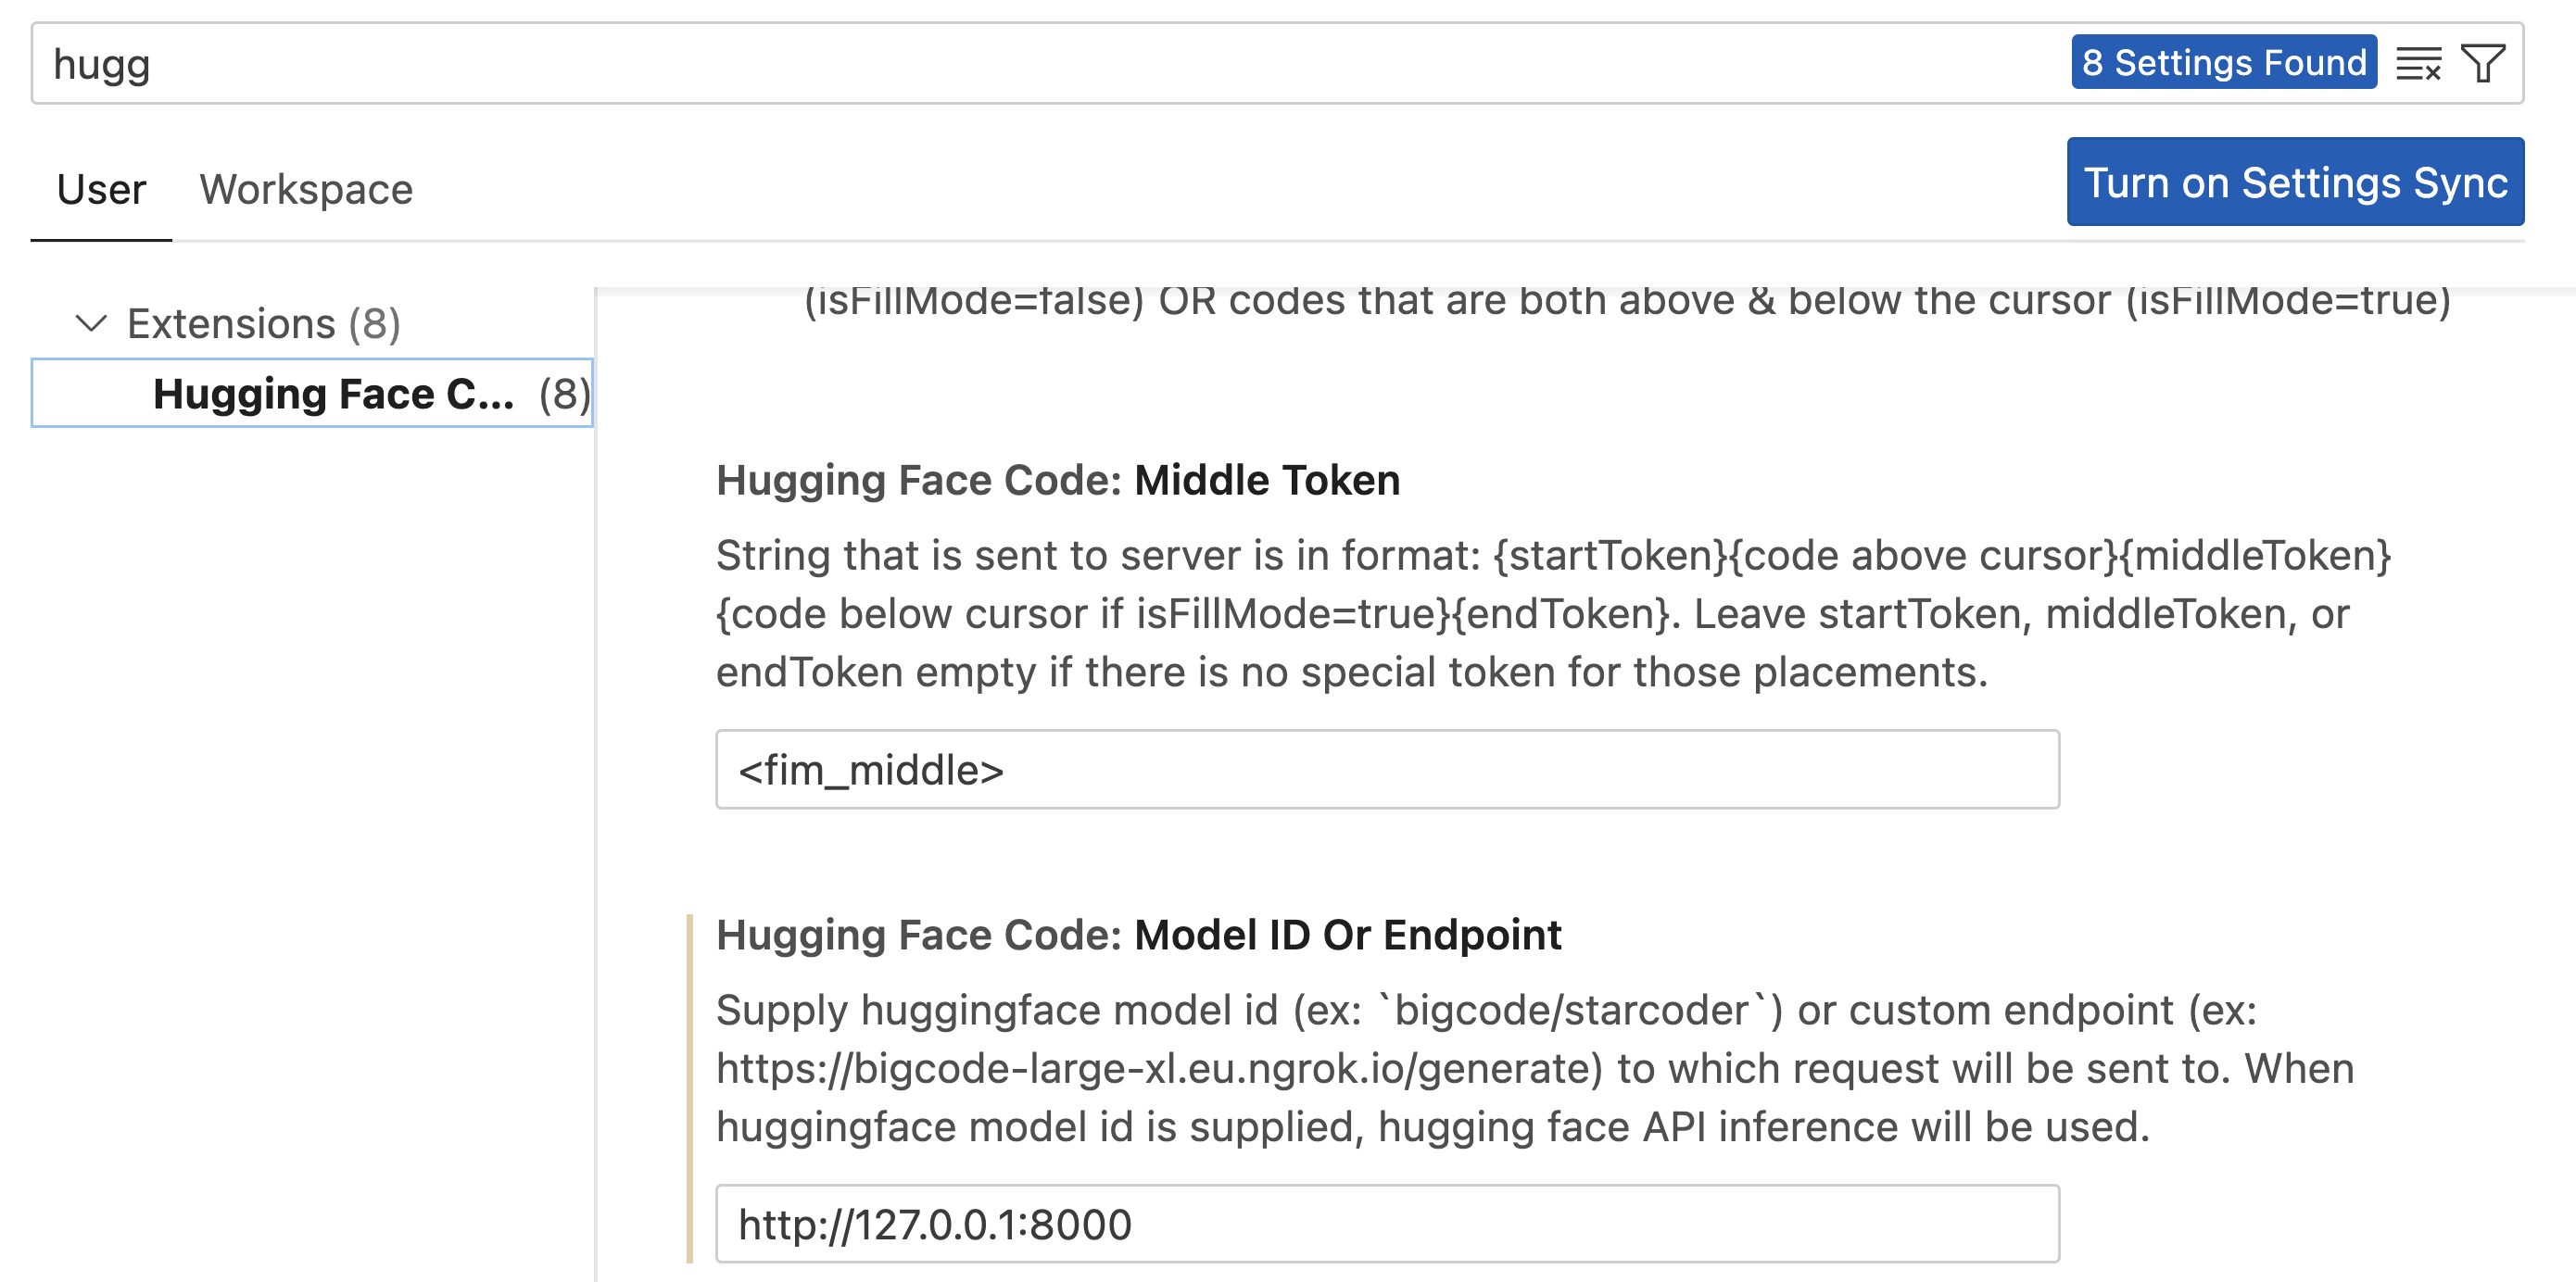
- 在 VS Code 中打开一个新文件,粘贴下面的代码,并将光标放在文档引号之间,以便模型尝试填充文档字符串:
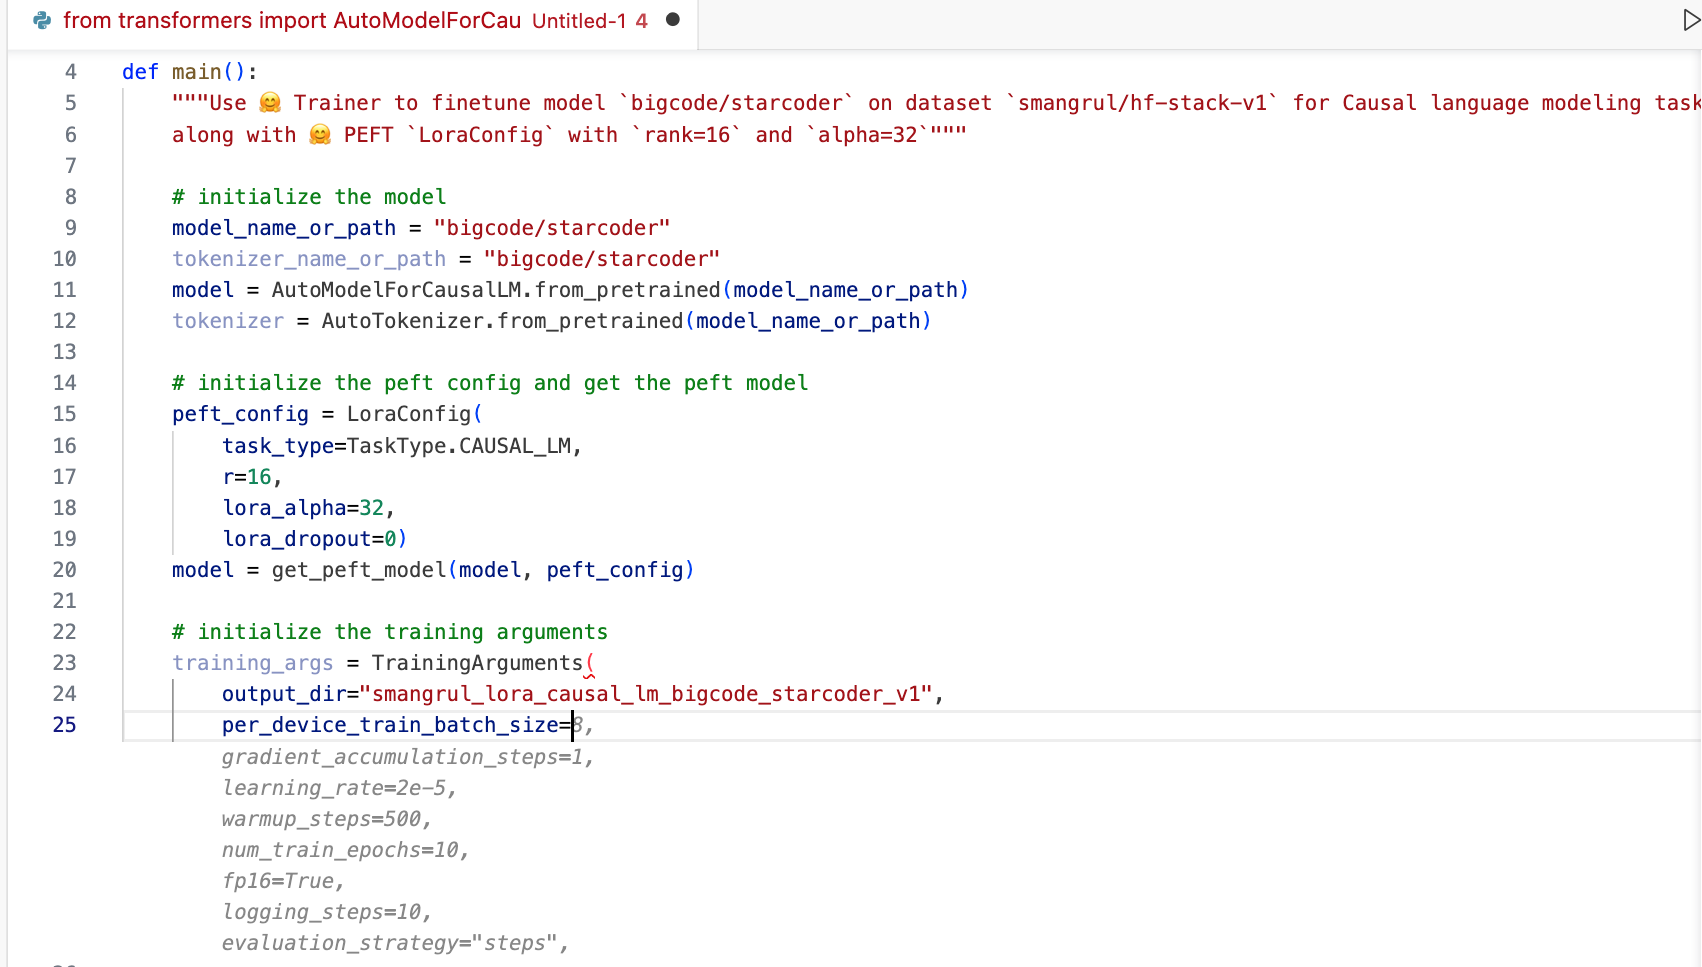
瞧!⭐️
本文开头的演示就是在我 Mac 笔记本电脑上本地运行的 1B 模型。
结论
在这篇博客文章中,我们看到了如何微调 starcoder 来创建一个了解我们代码的个人 copilot。我们将其称为 🤗 HugCoder,因为我们是在 Hugging Face 代码上训练它的 :) 在了解了数据收集工作流程之后,我们比较了使用 QLoRA 训练与完全微调。我们还尝试了组合不同的 LoRA,这在文本/代码领域仍是一种尚未探索的技术。在部署方面,我们研究了使用 🤗 Inference Endpoints 进行远程推理,还展示了使用 VS Code 和 MLC 在设备上执行较小模型。
如果你将这些方法用于你自己的代码库,请告诉我们!
致谢
我们要感谢 Pedro Cuenca、Leandro von Werra、Benjamin Bossan、Sylvain Gugger 和 Loubna Ben Allal 在撰写这篇博客文章时提供的帮助。
来源:Hugging Face:Blog(RSS) · huggingface.co