Hugging Face 用 10 亿训练句对训练句子嵌入模型的方法复盘
Train a Sentence Embedding Model with 1B Training Pairs
Hugging Face 在社区周活动中用 7 台 TPU v3-8 和最多 10 亿句对训练了 20 个通用 Sentence Transformers 模型,包括 Mini-LM、RoBERTa、DistilBERT 和 MPNet,在多个通用句子相似度评测任务上达到 SOTA。
作者复盘了用 10 亿句对训练句子嵌入模型的对比学习方法和批次设计经验,方法可迁移到类似训练场景。
句子嵌入是一种将句子映射为实数向量的方法。理想情况下,这些向量能够捕捉句子的语义,并且具有高度通用性。这样的表示随后可用于许多下游应用,如聚类、文本挖掘或问答。
我们在项目“用 10 亿训练对训练史上最佳句子嵌入模型”中开发了最先进的句子嵌入模型。该项目在 Hugging Face 组织的使用 JAX/Flax 进行 NLP 与 CV 的社区周期间开展。我们受益于高效硬件基础设施来运行该项目:7 个 TPU v3-8,以及来自 Google Flax、JAX 和 Cloud 团队成员关于高效深度学习框架的指导!
训练方法
模型
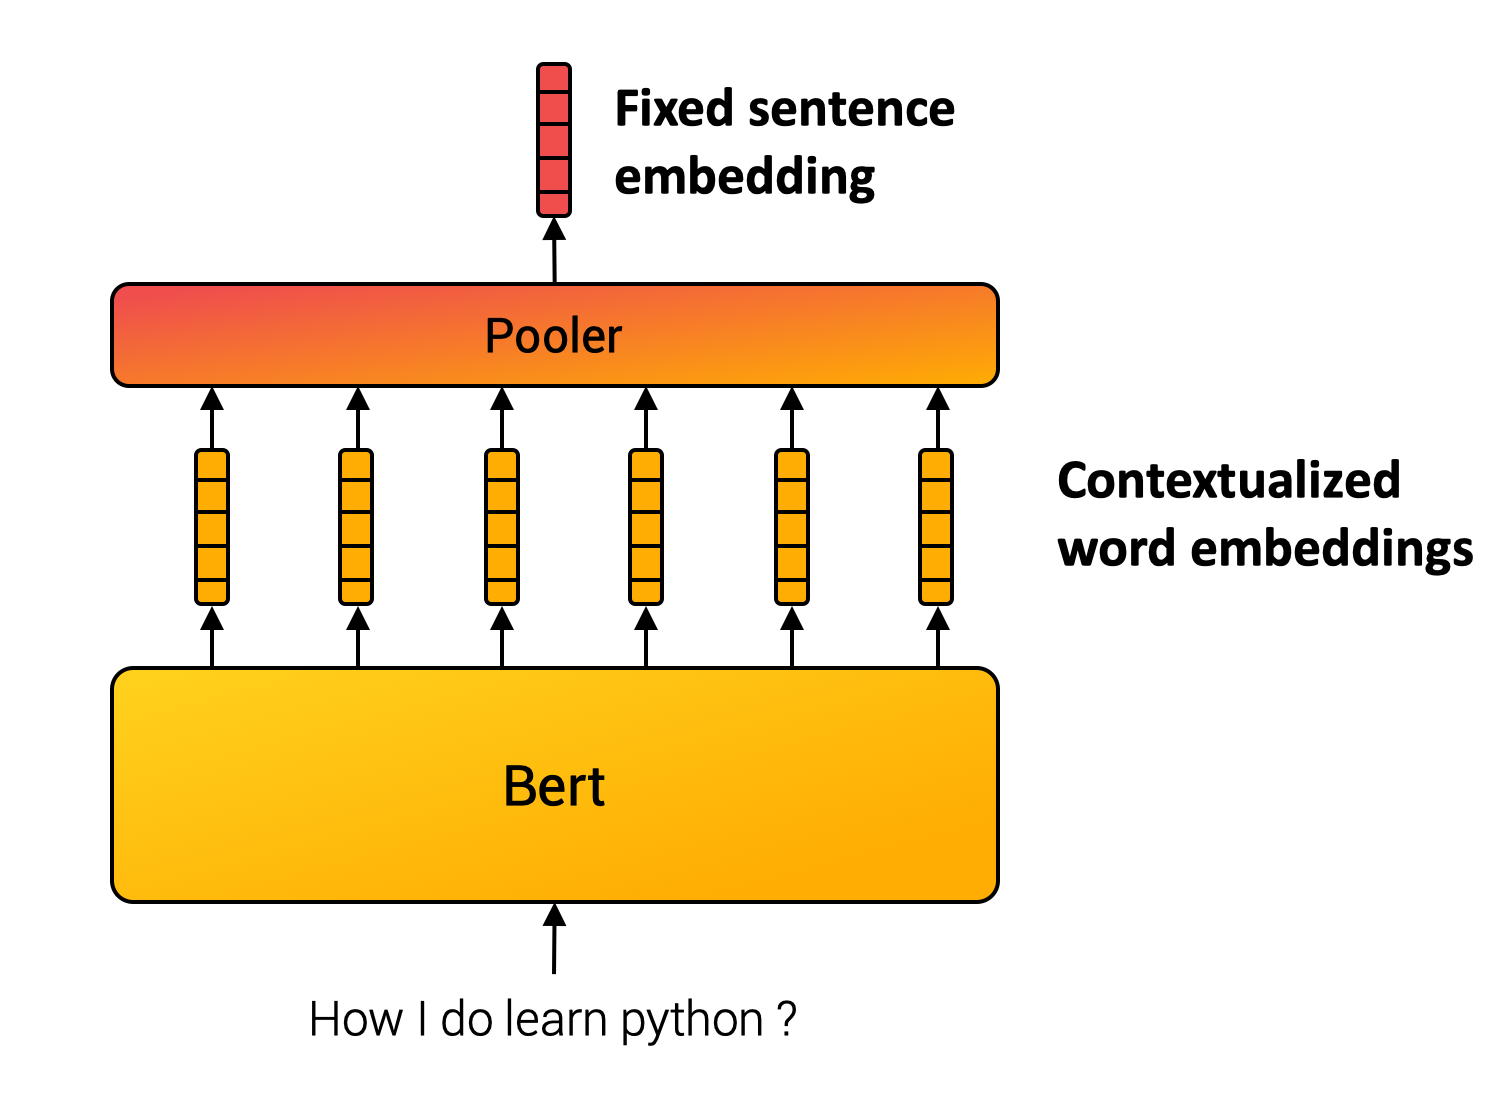
与单词不同,我们无法定义有限的句子集合。因此,句子嵌入方法通过组合内部单词来计算最终表示。例如,SentenceBert 模型(Reimers and Gurevych, 2019)使用 Transformer——许多 NLP 应用的基石——随后对上下文化词向量进行池化操作。(参见下图。)
多重负样本排序损失
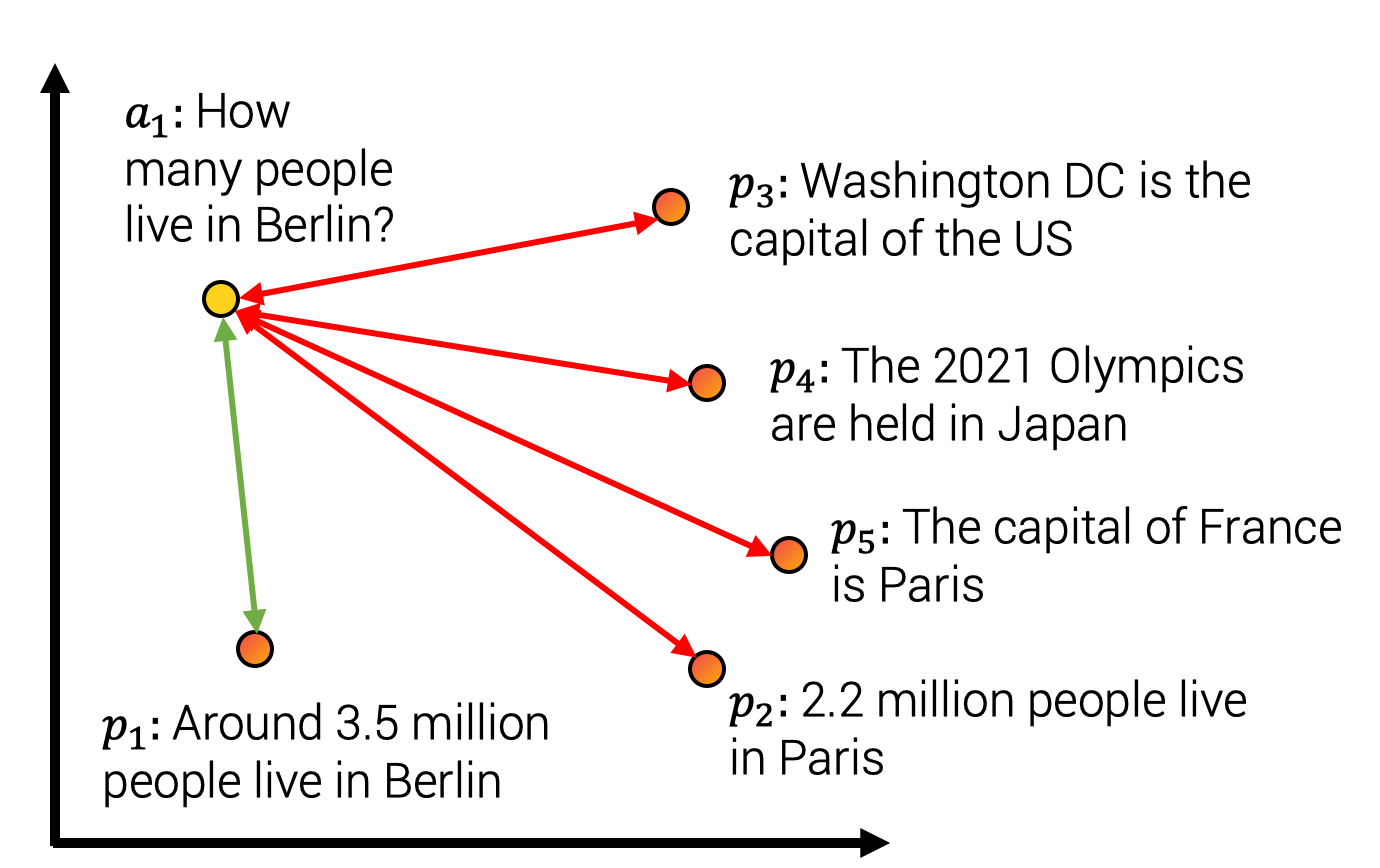
组合模块的参数通常使用自监督目标来学习。对于该项目,我们使用了如下图所示的对比训练方法。我们构建一个由句子对 (ai,pi) (a_i, p_i) 组成的数据集,使得对中的句子具有相近的含义。例如,我们考虑诸如(查询,答案段落)、(问题,重复问题)、(论文标题,被引论文标题)这样的对。然后训练我们的模型,将配对 (ai,pi) (a_i , p_i) 映射到相近的向量,同时将不匹配的对 (ai,pj),i≠j (a_i , p_j), i \neq j 分配到嵌入空间中相距较远的向量。这种训练方法也称为批内负样本训练、InfoNCE 或 NTXentLoss。
形式上,给定一批训练样本,模型优化以下损失函数:
−1n∑i=1nexp(sim(ai,pi))∑jexp(sim(ai,pj))-\frac{1}{n}\sum_{i=1}^n\frac{exp(sim(a_i, p_i))}{\sum_j exp(sim(a_i, p_j))}
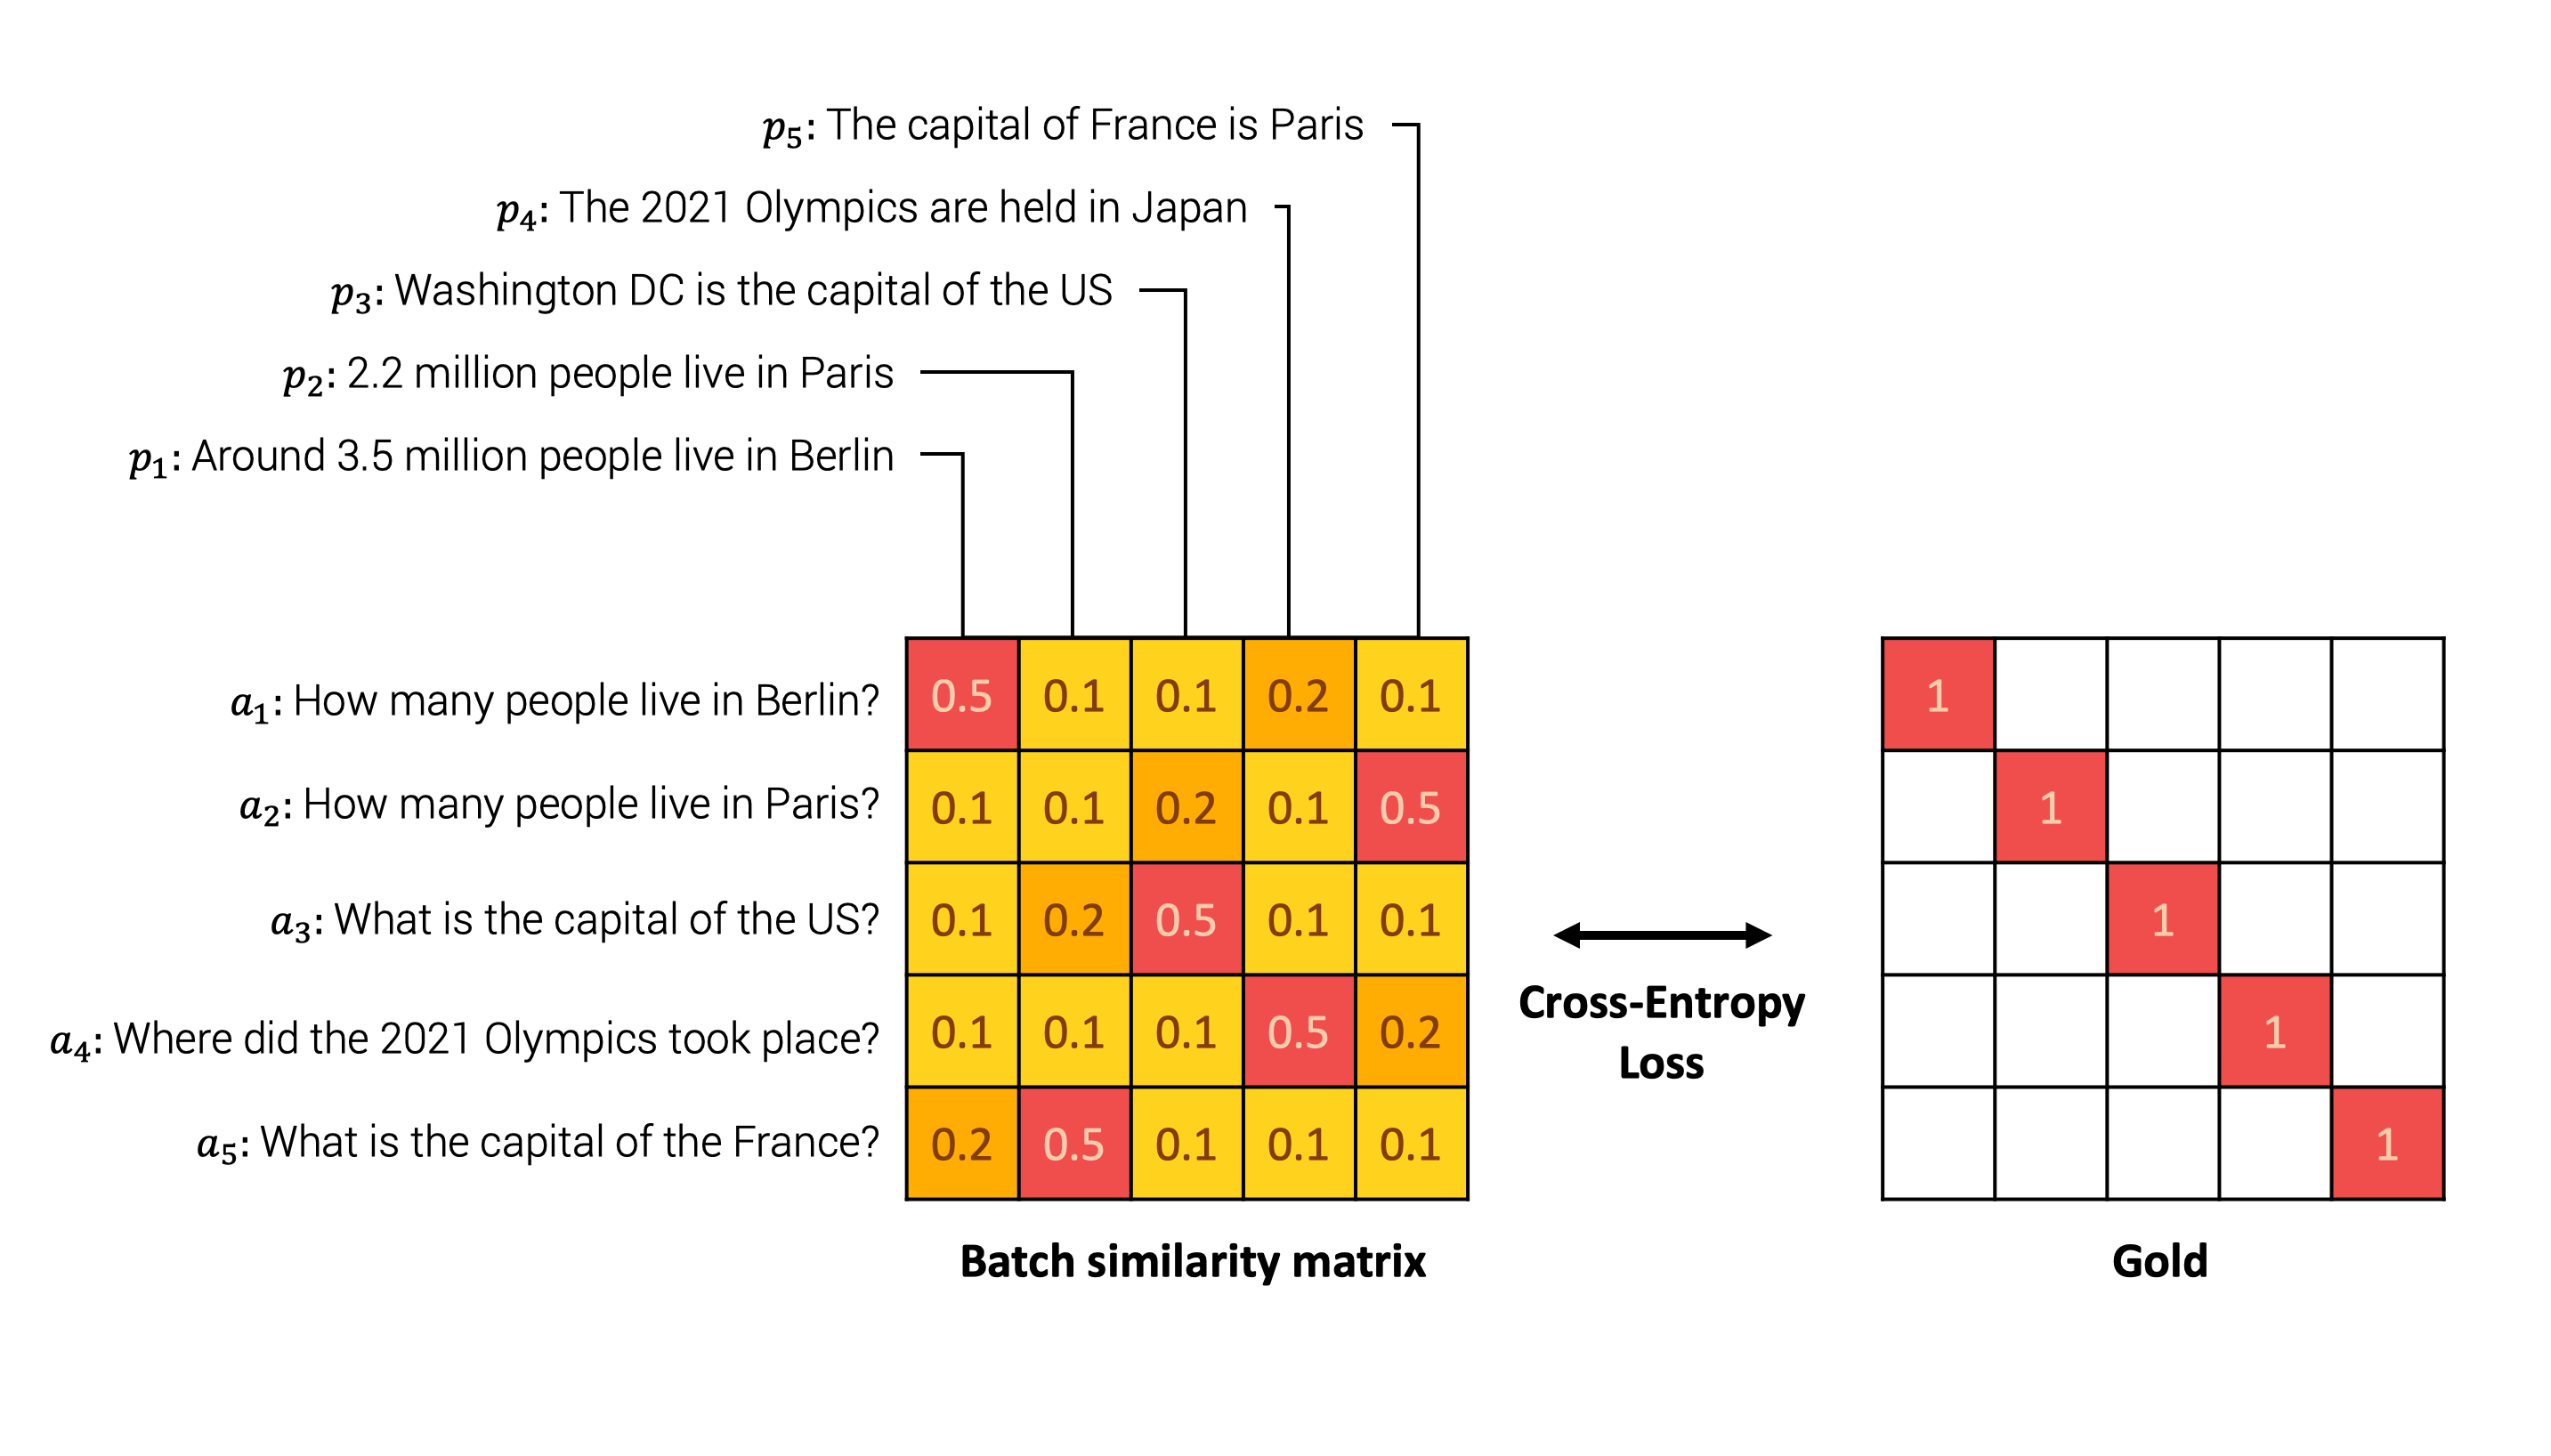
下面是一个示例说明。模型首先嵌入批次中每一对里的每个句子。然后,我们计算每个可能对 (ai,pj) (a_i, p_j) 之间的相似度矩阵。接着,我们将相似度矩阵与真实标签(指示原始配对)进行比较。最后,我们使用交叉熵损失进行比较。
直观上,模型应为句子« How many people live in Berlin? »和« Around 3.5 million people live in Berlin »分配高相似度,而对其他负样本答案(如« The capital of France is Paris »)分配低相似度,如下图所示。
在损失方程中,sim 表示 (a,p) (a, p) 之间的相似度函数。相似度函数可以是余弦相似度或点积算子。两种方法各有优缺点,总结如下(Thakur et al., 2021,Bachrach et al., 2014):
| 余弦相似度 | 点积 |
|---|---|
| 向量与自身的相似度最高,因为 cos(a,a)=1 cos(a, a)=1 。 | 其他向量可能具有更高的点积 dot(a,a)<dot(a,b) dot(a, a) < dot (a, b) 。 |
| 对于归一化向量,它等于点积。最大向量长度等于 1。 | 在某些近似最近邻方法中可能会更慢,因为最大向量未知。 |
| 对于归一化向量,它与欧几里得距离成正比。它适用于 k-means 聚类。 | 它不适用于 k-means 聚类。 |
在实践中,我们使用缩放后的相似度,因为分数差异往往太小,并应用缩放因子 C C ,使得 simscaled(a,b)=C∗sim(a,b) sim_{scaled}(a, b) = C * sim(a, b) ,通常 C=20 C = 20 (Henderson and al., 2020,Radford and al., 2021)。
通过更好的批次提升质量
在我们的方法中,我们构建样本对 (ai,pi) (a_i , p_i) 的批次。我们将批次中的所有其他样本 (ai,pj),i≠j (a_i , p_j), i \neq j 视为负样本对。因此,批次组成是训练的关键方面。鉴于该领域的文献,我们主要关注批次的三个主要方面。
1. 大小很重要
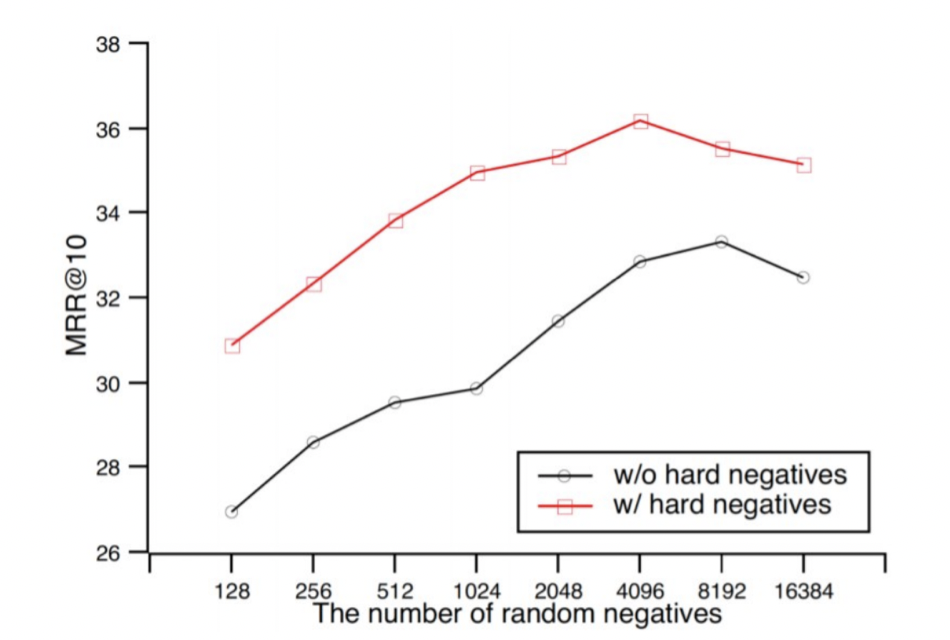
在对比学习中,更大的批次大小意味着更好的性能。如 Qu and al.(2021)提取的图所示,更大的批次大小会提高结果。
2. 难负样本
在同一张图中,我们观察到包含难负样本也能提高性能。难负样本是难以与 pi p_i 区分的样本 pj p_j 。在我们的例子中,可能是“What is the capital of France?”和“What is the capital of the US?”这样的对,它们具有相近的语义内容,需要准确理解整个句子才能正确回答。相反,样本“What is the capital of France?”和“How many Star Wars movies is there?”则不那么难以区分,因为它们不涉及同一主题。
3. 跨数据集批次
我们拼接多个数据集来训练我们的模型。我们构建了一个大批次,并从同一批次数据集中收集样本,以限制主题分布并倾向于难负样本。然而,我们也在批次中混合至少两个数据集,以学习主题之间的全局结构,而不仅仅是主题内的局部结构。
训练基础设施和数据
如前所述,数据量和批次大小直接影响模型性能。作为项目的一部分,我们受益于高效的硬件基础设施。我们在 TPU 上训练我们的模型,TPU 是 Google 开发的计算单元,在矩阵乘法方面非常高效。TPU 有一些硬件特性,可能需要一些特定的代码实现。
此外,我们在大型语料库上训练模型,因为我们拼接了多个数据集,多达 10 亿个句子对!所有使用的数据集在每个模型的模型卡片中都有详细说明。
结论
你可以在我们的 HuggingFace 仓库 中找到我们在挑战期间创建的所有模型和数据集。我们训练了 20 个通用 Sentence Transformers 模型,例如 Mini-LM(Wang 等人,2020)、RoBERTa(Liu 等人,2019)、DistilBERT(Sanh 等人,2020)和 MPNet(Song 等人,2020)。我们的模型在多个通用句子相似度评估任务上达到了 SOTA。我们还分享了 8 个数据集,专门用于问答、句子相似度和性别评估。
通用句子嵌入可用于许多应用。我们构建了一个 Spaces 演示 来展示几个应用:
- 句子相似度模块将主文本与您选择的其他文本的相似度进行比较。在后台,该演示为每个文本提取嵌入,并使用余弦相似度计算源句子与其他句子之间的相似度。
- 非对称问答将给定查询的答案可能性与您选择的候选答案进行比较。
- 搜索 / 聚类从查询中返回附近的答案。例如,如果您输入 « python »,它将使用点积距离检索最接近的句子。
- 性别偏见评估通过随机抽样句子来报告训练集中的固有性别偏见。给定一个未提及目标职业性别的锚文本和两个带有性别代词的命题,我们比较模型是否对给定命题赋予更高的相似度,从而评估它们偏向特定性别的比例。
使用 JAX/Flax 进行 NLP 和 CV 的社区周是一次紧张且收获颇丰的经历!Google 的 Flax、JAX 和 Cloud 以及 Hugging Face 团队成员的高质量指导和他们的参与帮助我们所有人学到了很多。我们希望所有项目都和我们的一样有趣。如果您有任何问题或建议,请随时联系我们!
来源:Hugging Face:Blog(RSS) · huggingface.co