Hugging Face 发布 Evaluation on the Hub,一键评估任意模型与数据集
Announcing Evaluation on the Hub
Hugging Face 推出 Evaluation on the Hub,基于 AutoTrain,可在 Hub 上不写代码评估任意模型在任意数据集上的表现。
官方介绍无代码评估任意 Hub 模型与数据集的流程和排行榜用法,读者可据此了解如何复现和比较模型性能。
TL;DR:今天我们推出 Evaluation on the Hub,这是一个由 AutoTrain 驱动的新工具,让你无需编写任何代码,就能在 Hub 上对任何数据集评估任何模型!
AI 的进步堪称惊人,以至于现在有些人开始认真讨论 AI 模型是否在某些任务上可能比人类更优秀。然而,这种进步完全不是均衡的:对于几十年前的机器学习研究者来说,现代硬件和算法可能看起来不可思议,我们可支配的数据和算力之庞大也同样如此,但我们评估这些模型的方式却基本保持不变。
然而,毫不夸张地说,现代 AI 正处于一场评估危机之中。如今,恰当的评估涉及对许多模型进行测量,往往还要在多个数据集上、使用多种指标。但这样做却异常繁琐。如果我们关心可复现性,情况尤其如此,因为自我报告的结果可能受到无意中的 bug、实现上的细微差异,或者更糟情况的影响。
我们相信,如果我们——整个社区——建立一套更好的最佳实践并努力消除障碍,更好的评估是可以实现的。在过去的几个月里,我们一直在努力开发 Evaluation on the Hub:只需点击按钮,就能使用任何指标在任何数据集上评估任何模型。为了起步,我们在几个关键数据集上评估了数百个模型,并利用 Hub 上便捷的新 Pull Request 功能,在模型卡上开启了大量 PR,以展示其经过验证的性能。评估结果直接编码在模型卡元数据中,遵循适用于 Hub 上所有模型的一种格式。查看 DistilBERT 的模型卡,看看它是什么样子!
在 Hub 上
Evaluation on the Hub 为许多有趣的用例打开了大门。从需要决定部署哪个模型的数据科学家或高管,到试图在新数据集上复现论文结果的学者,再到想要更好地理解部署风险的伦理学家。如果非要挑出三个主要的初始用例场景,那就是这些:
为你的任务找到最佳模型
假设你确切知道自己的任务是什么,并且想为这项工作找到合适的模型。你可以查看代表你任务的数据集的排行榜,它汇总了所有结果。那太好了!如果你感兴趣的那个炫酷新模型还没有出现在该数据集的排行榜上呢?只需为它运行一次评估,无需离开 Hub。
在你全新的数据集上评估模型
那么,如果你有一个全新的数据集,想在上面运行基线呢?你可以将它上传到 Hub,并在上面评估任意数量的模型。无需代码。更重要的是,你可以确信,你在自己的数据集上评估这些模型的方式,与它们在其他数据集上的评估方式完全一致。
在许多其他相关数据集上评估你的模型
或者假设你有一个全新的问答模型,是在 SQuAD 上训练的?有数百个不同的问答数据集可供评估 :scream: 你可以挑选自己感兴趣的那些,直接从 Hub 上评估你的模型。
生态系统
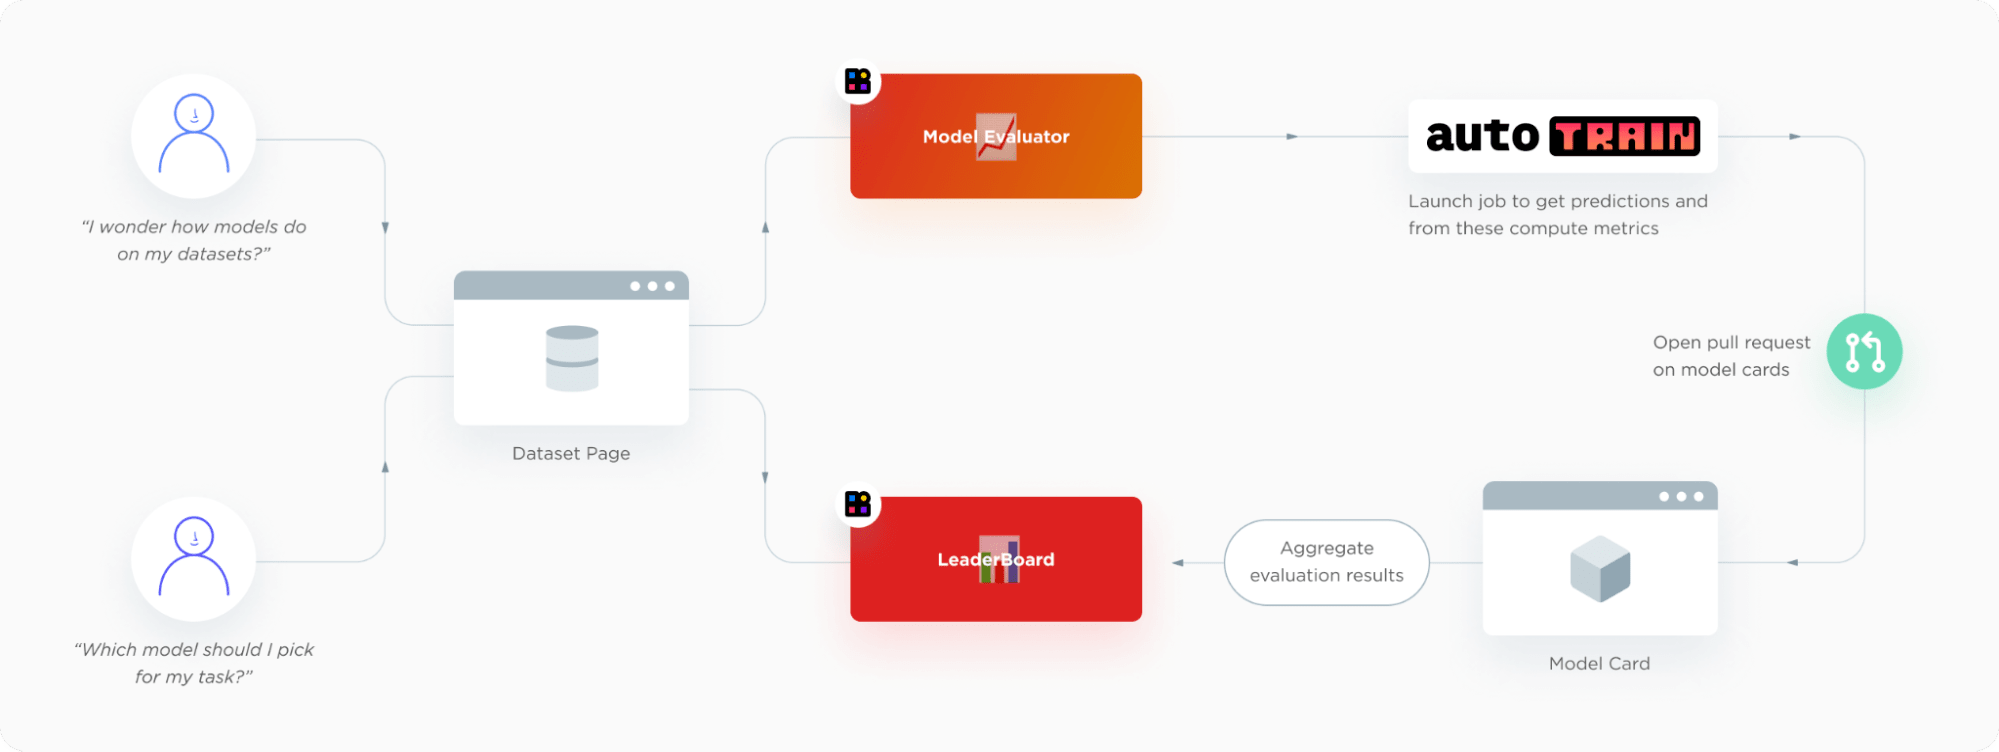
Hub 上的评估旨在让你的生活更轻松。但当然,背后有很多事情在发生。我们真正喜欢 Hub 上的评估的地方在于:它完美地融入现有的 Hugging Face 生态系统,我们几乎不得不做它。用户从数据集页面开始,在那里他们可以启动评估或查看排行榜。模型评估提交界面和排行榜是常规的 Hugging Face Spaces。评估后端由 AutoTrain 提供支持,它会为给定模型的模型卡片在 Hub 上打开一个 PR。
DogFood - 区分狗、松饼和炸鸡
那么它在实践中是什么样子的呢?让我们通过一个例子来了解一下。假设你的业务是区分狗、松饼和炸鸡(也就是 dogfooding!)。
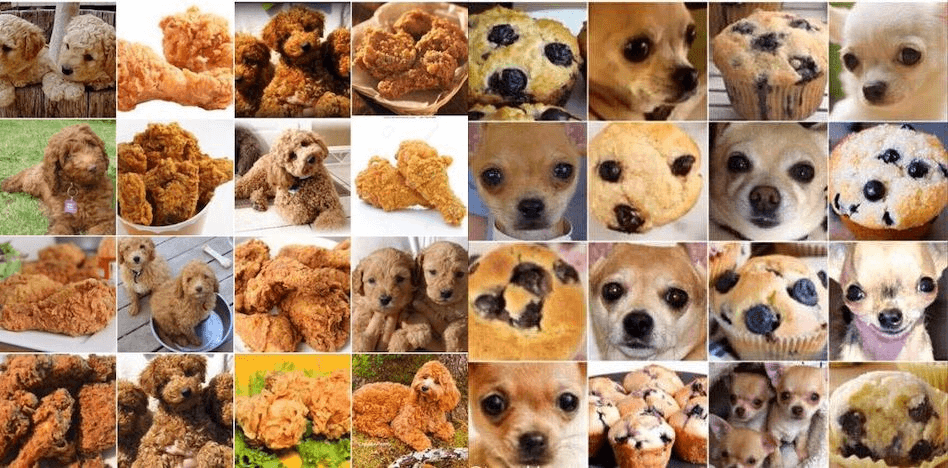
如上图所示,要解决这个问题,你需要:
- 一个包含狗、松饼和炸鸡图像的数据集
- 在这些图像上训练过的图像分类器
幸运的是,你的数据科学团队已经将一个数据集上传到 Hugging Face Hub,并在其上训练了几个不同的模型。所以现在你只需要挑选最好的一个——让我们使用 Hub 上的评估来看看它们在测试集上的表现如何!
配置评估任务
要开始,请前往model-evaluator Space并选择你想要评估模型的数据集。对于我们的狗和食物图像数据集,你会看到类似下图的内容:

现在,Hub 上的许多数据集都包含指定应如何配置评估的元数据(查看acronym_identification作为示例)。这允许你一键评估模型,但在我们的例子中,我们将向你展示如何手动配置评估。
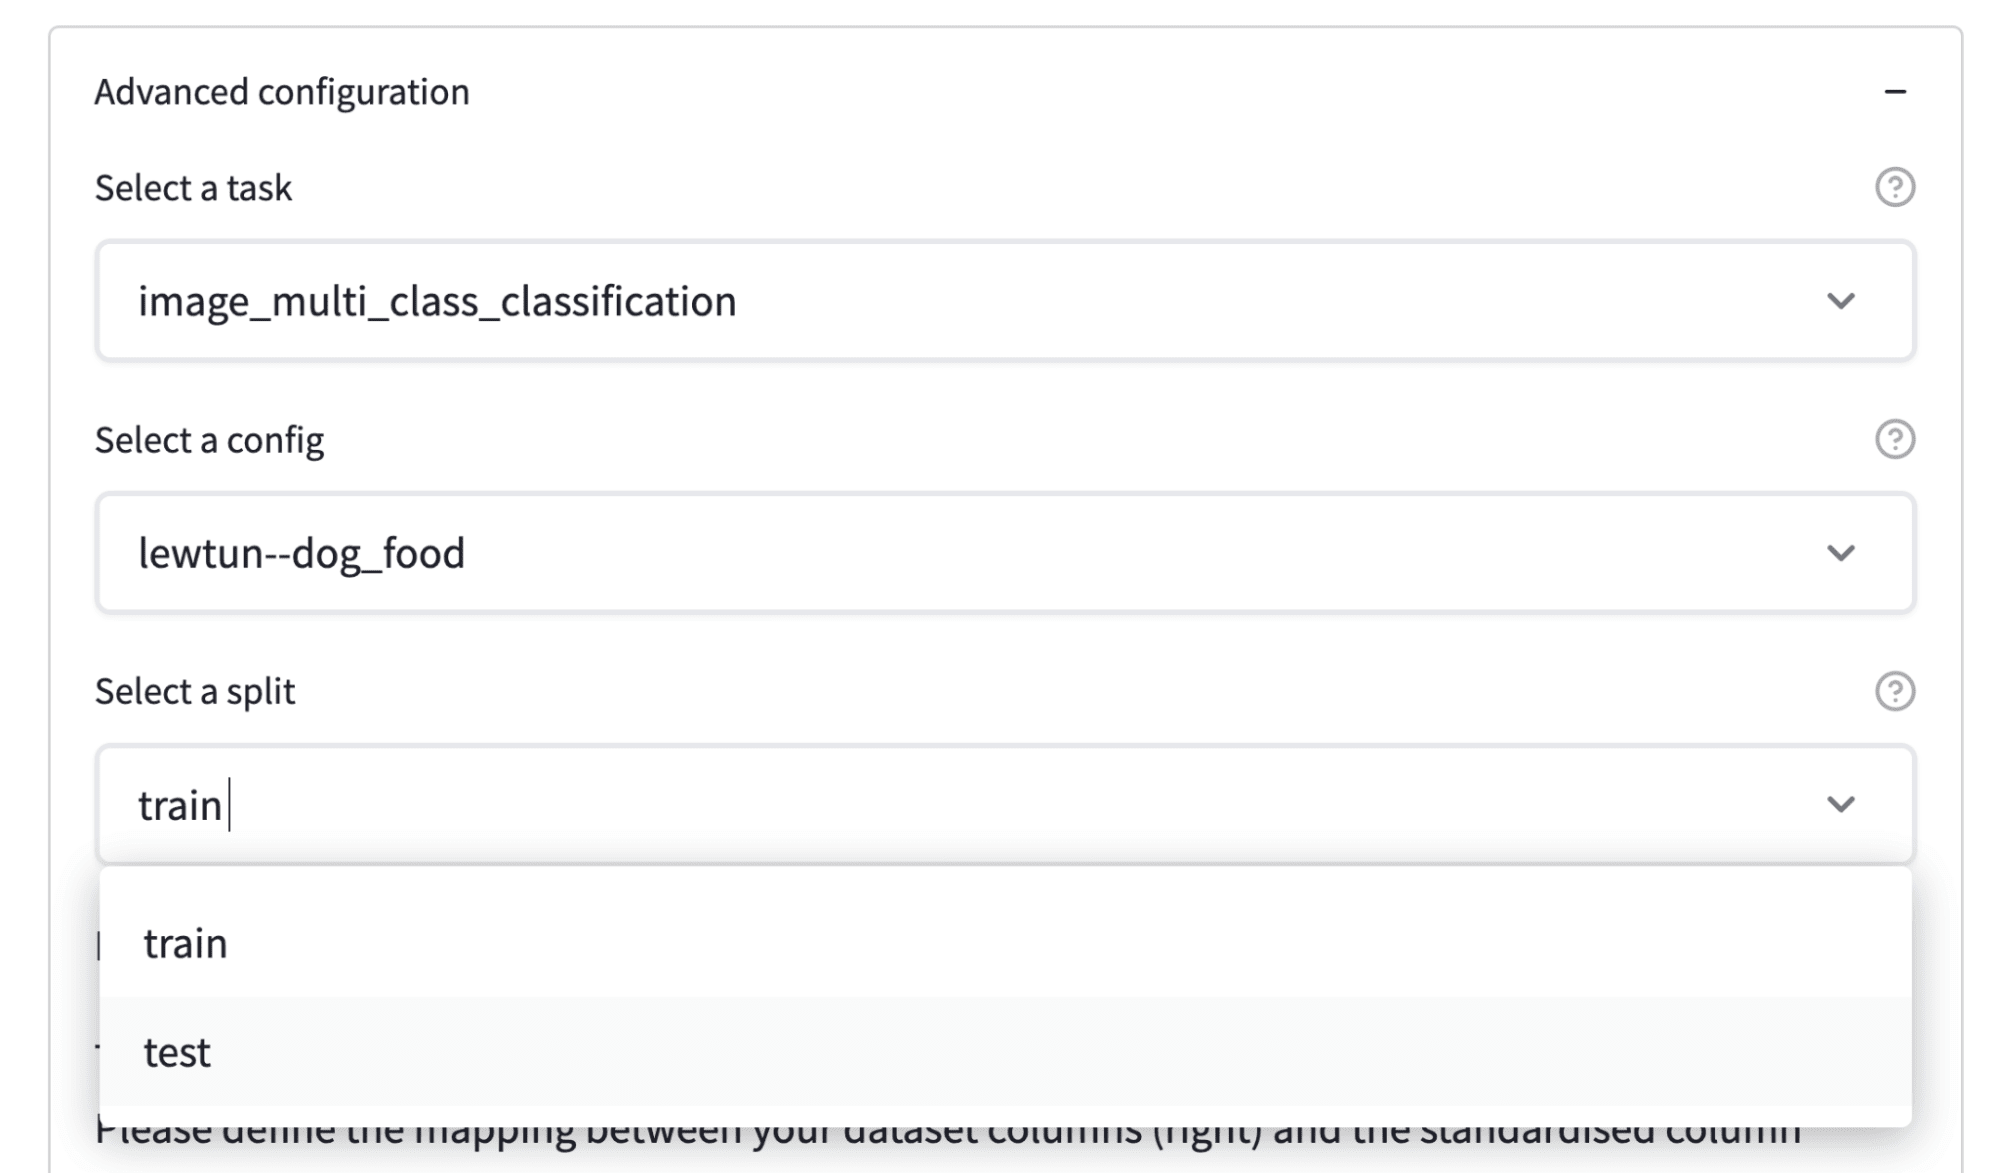
点击高级配置按钮将显示可供选择的各种设置:
- 任务、数据集和分割配置
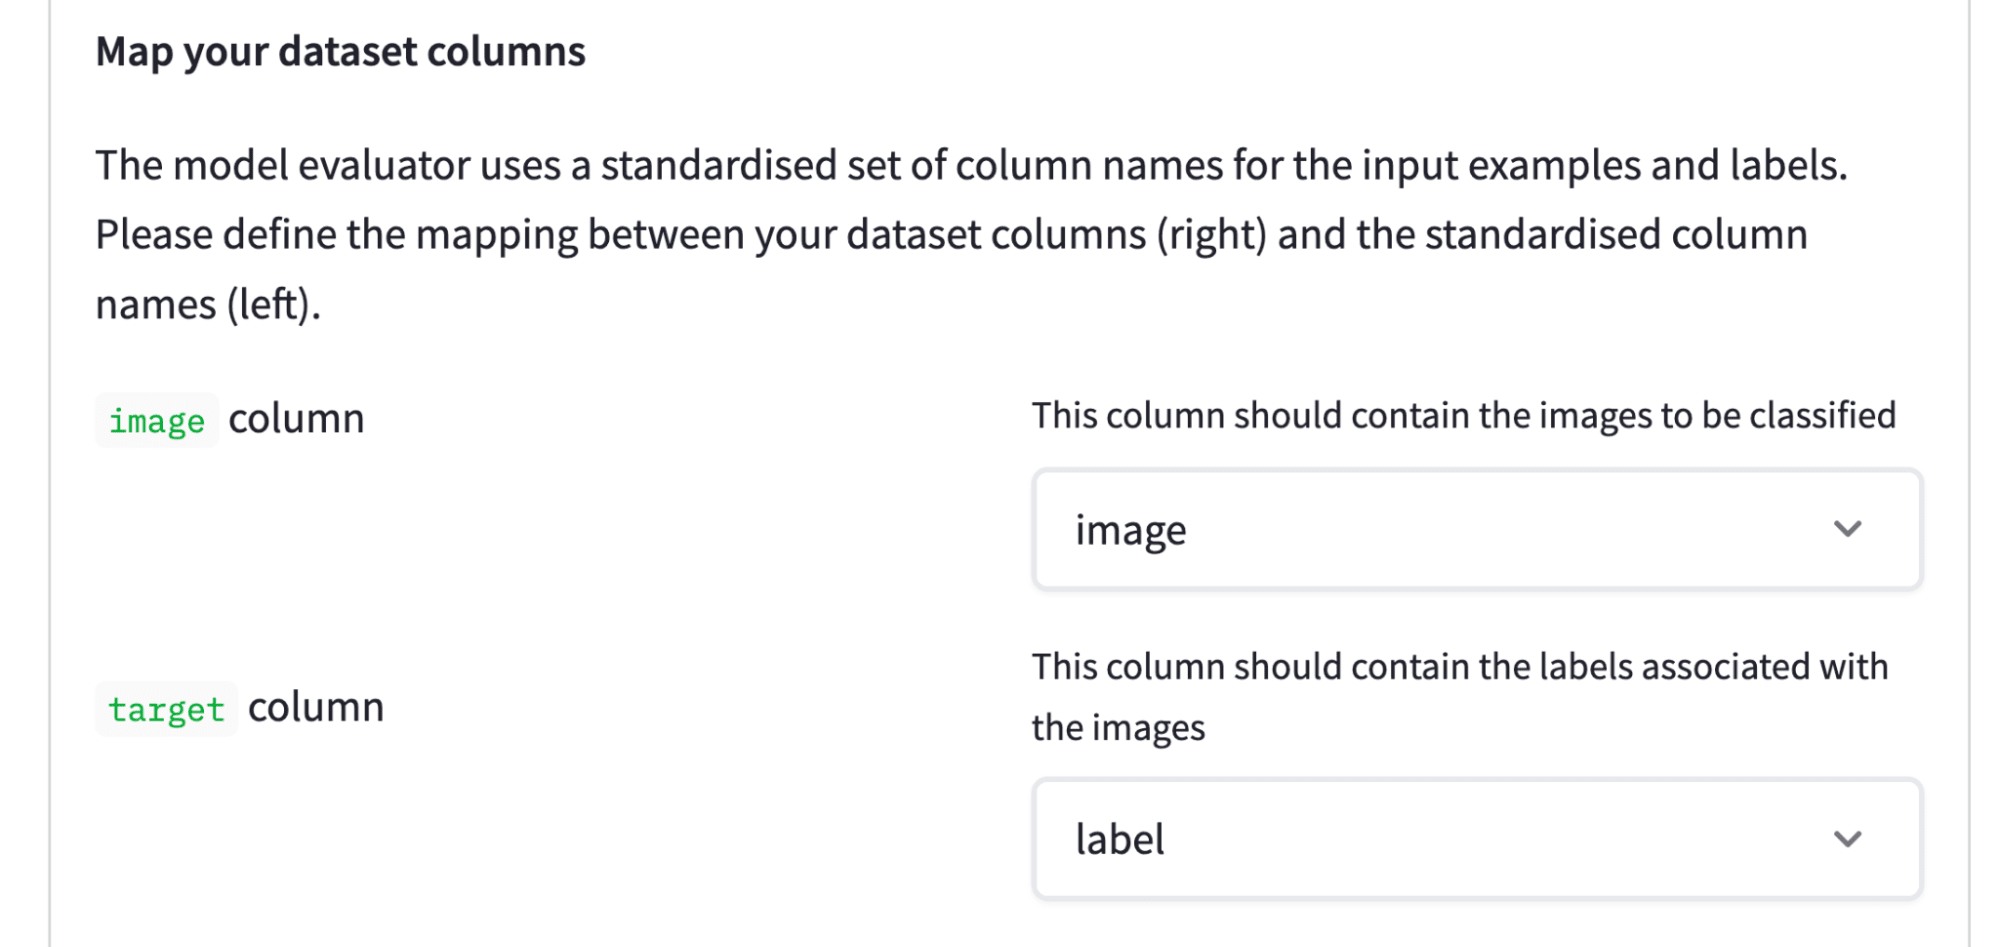
- 数据集列到标准格式的映射
- 指标的选择
如下图所示,配置要评估的任务、数据集和分割很简单:
下一步是定义哪些数据集列包含图像,哪些列包含标签:
现在任务和数据集已配置好,最后(可选)一步是选择要评估的指标。每个任务都关联一组默认指标。例如,下图显示 F1 分数、准确率等将自动计算。为了增加趣味,我们还将计算马修斯相关系数,它提供了分类器性能的平衡度量:
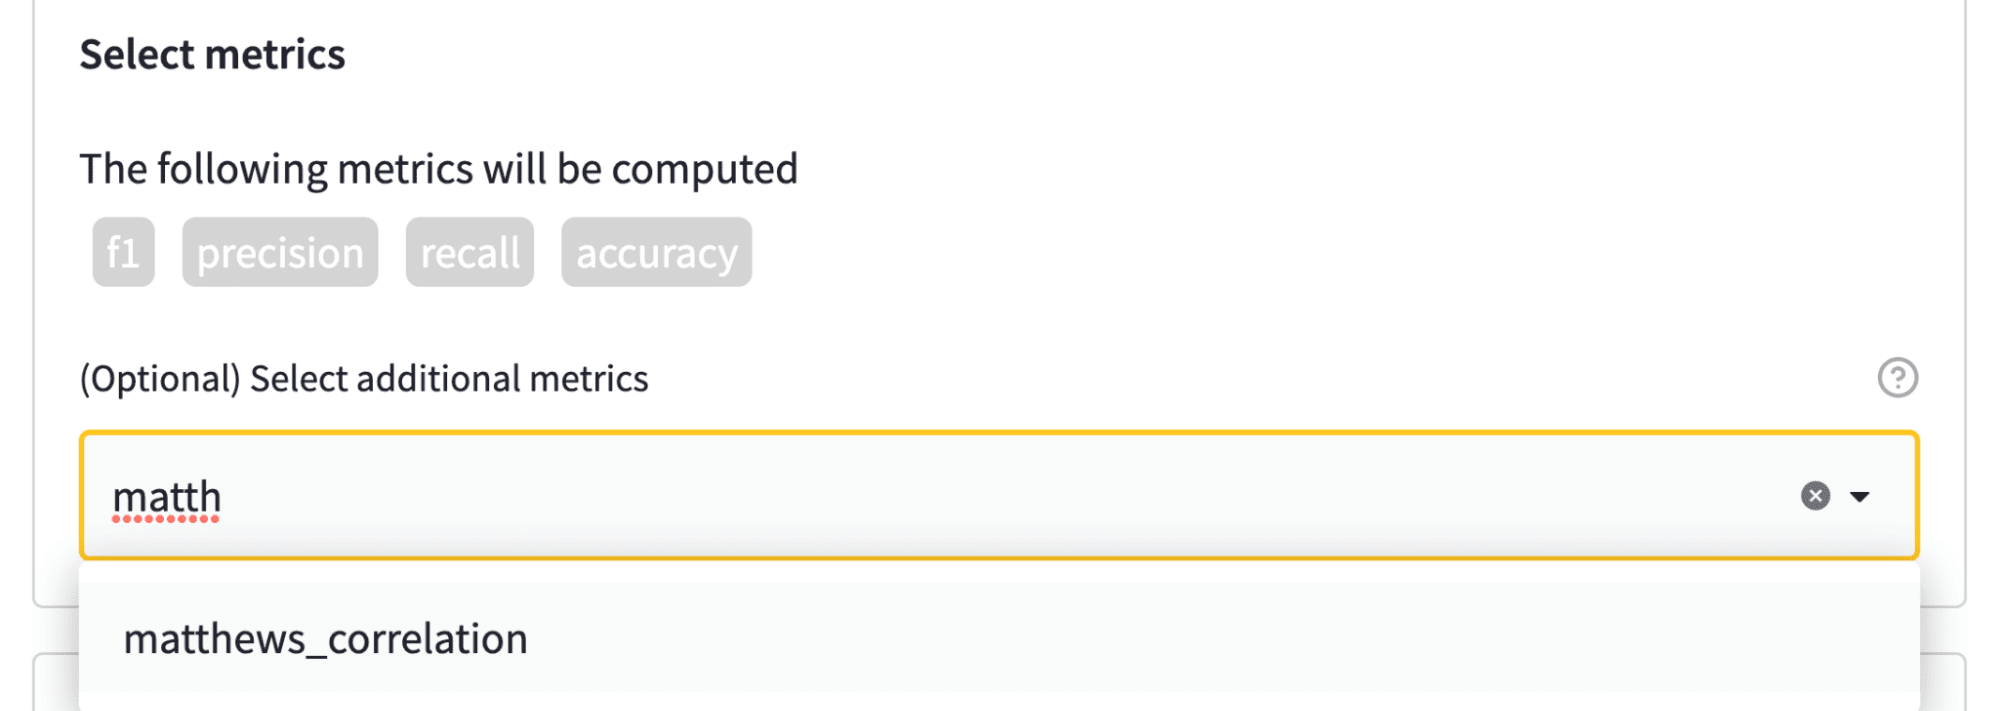
配置评估任务就只需要这些!现在我们只需要挑选一些要评估的模型——让我们来看看。
选择要评估的模型
Hub 上的评估通过模型卡片元数据中的标签链接数据集和模型。在我们的例子中,我们有三个模型可供选择,所以让我们全部选择它们!
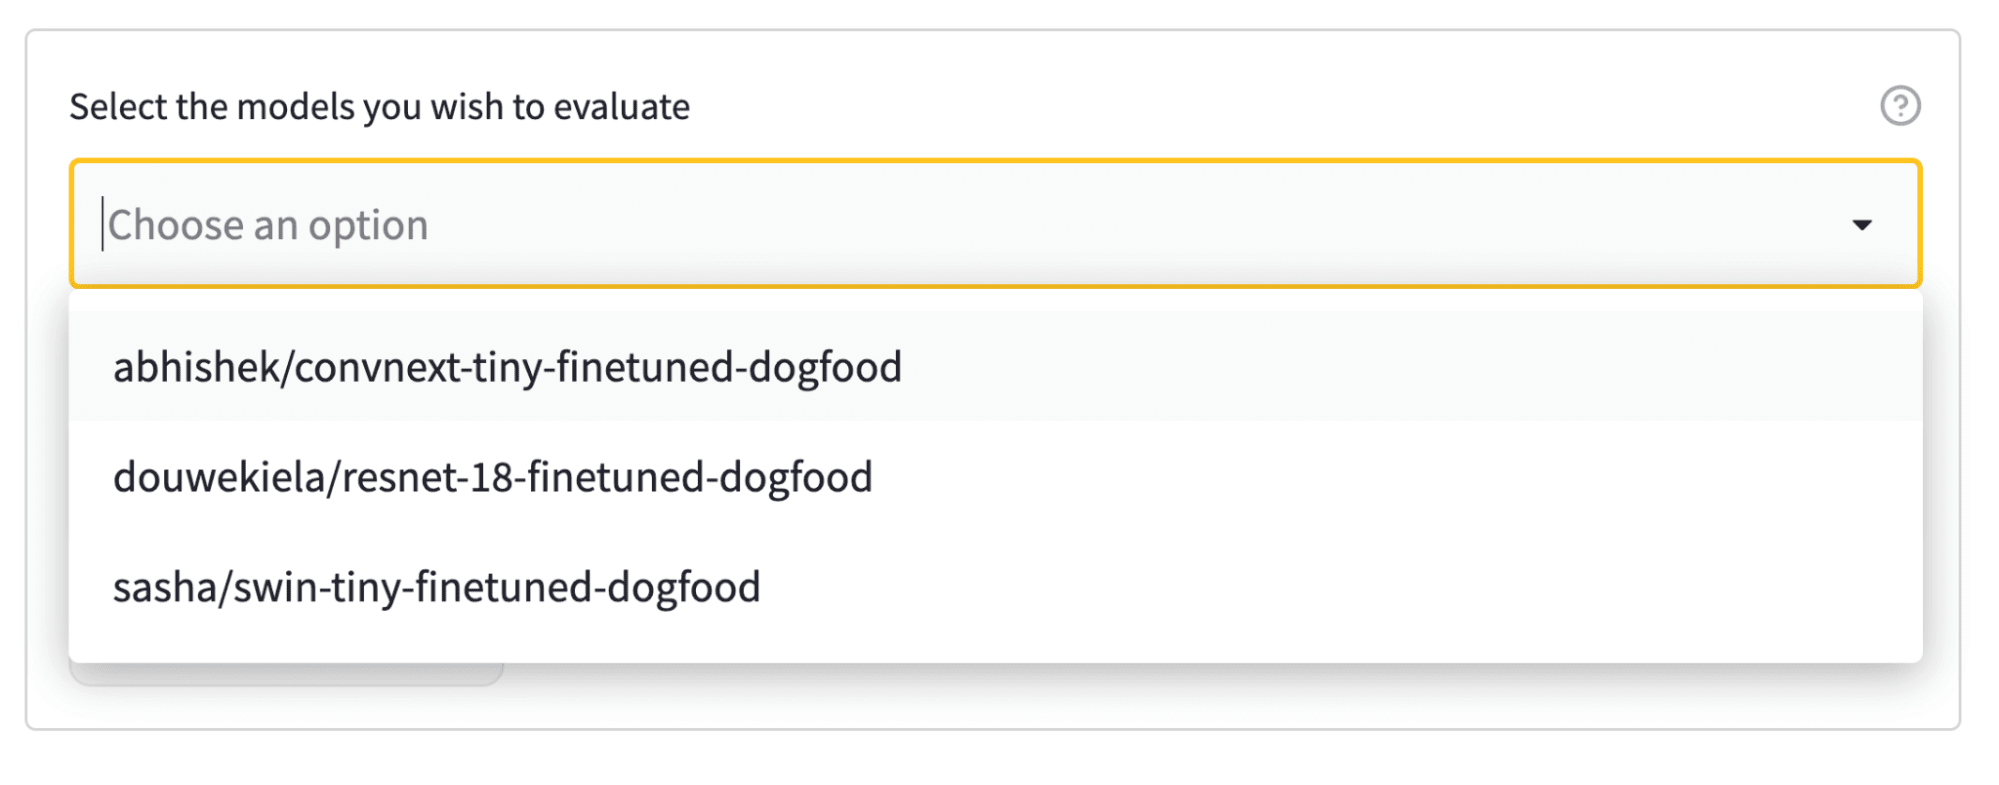
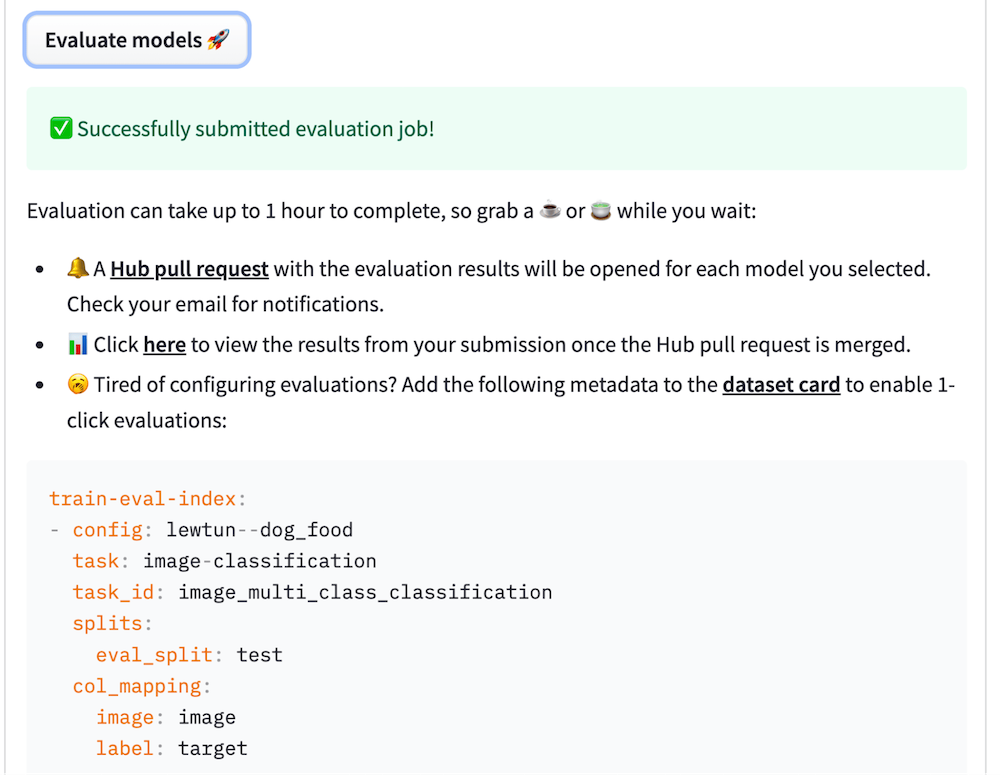
选择模型后,只需输入你的 Hugging Face Hub 用户名(以便在评估完成时收到通知),然后点击大的评估模型按钮:
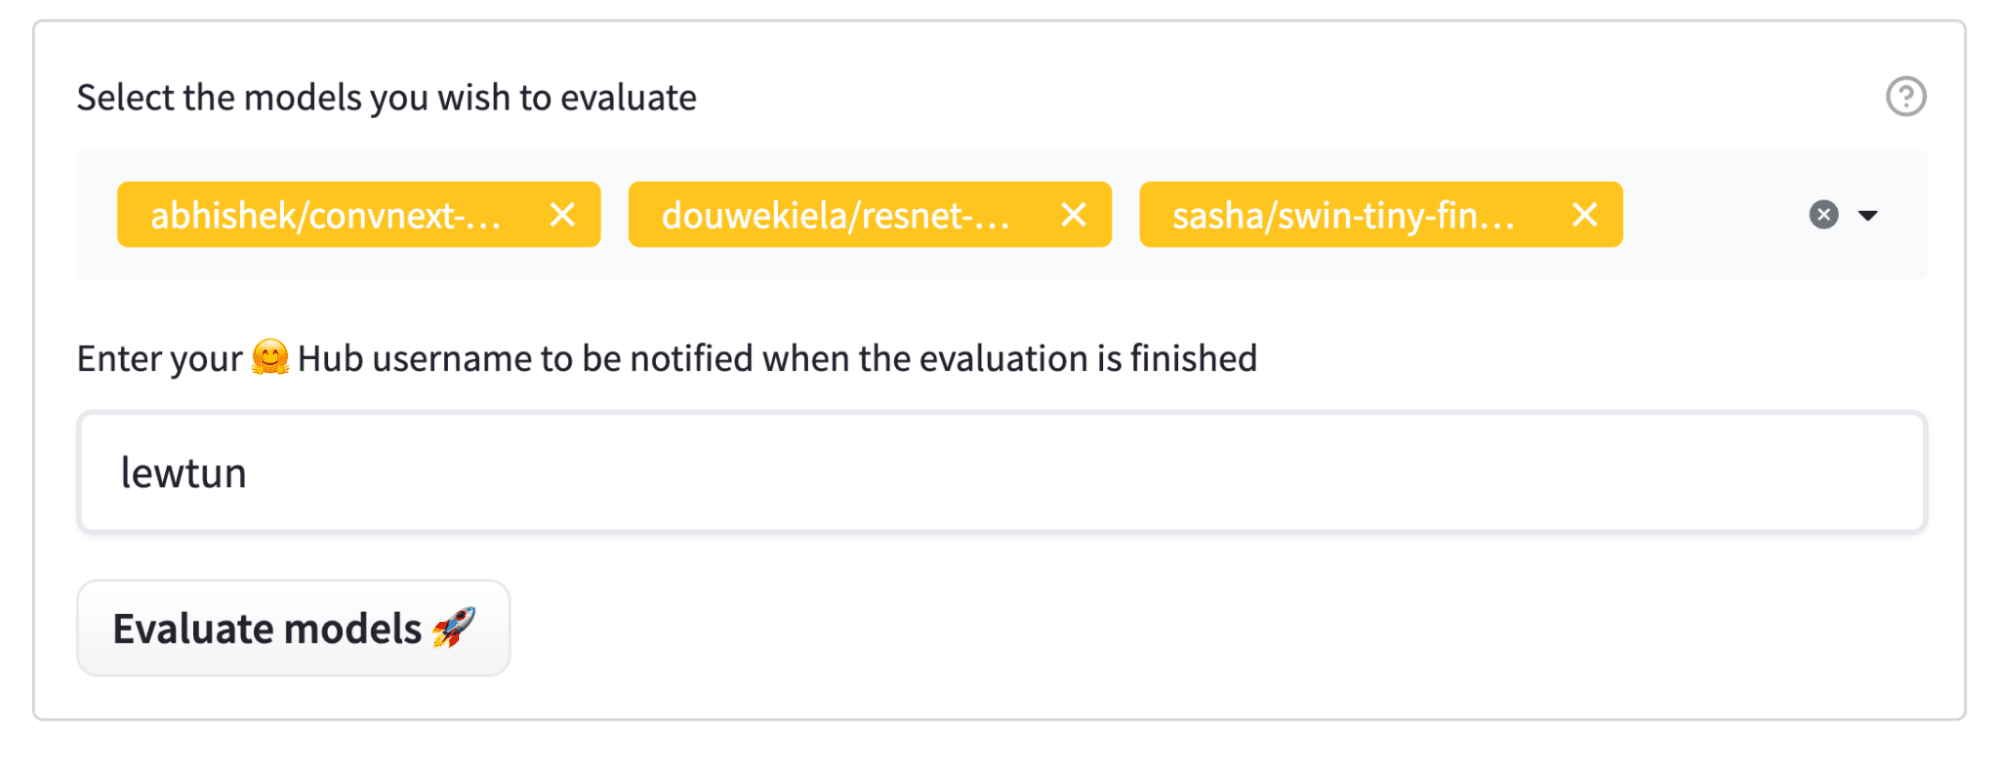
提交任务后,模型将自动评估,并会打开一个包含评估结果的 Hub 拉取请求:
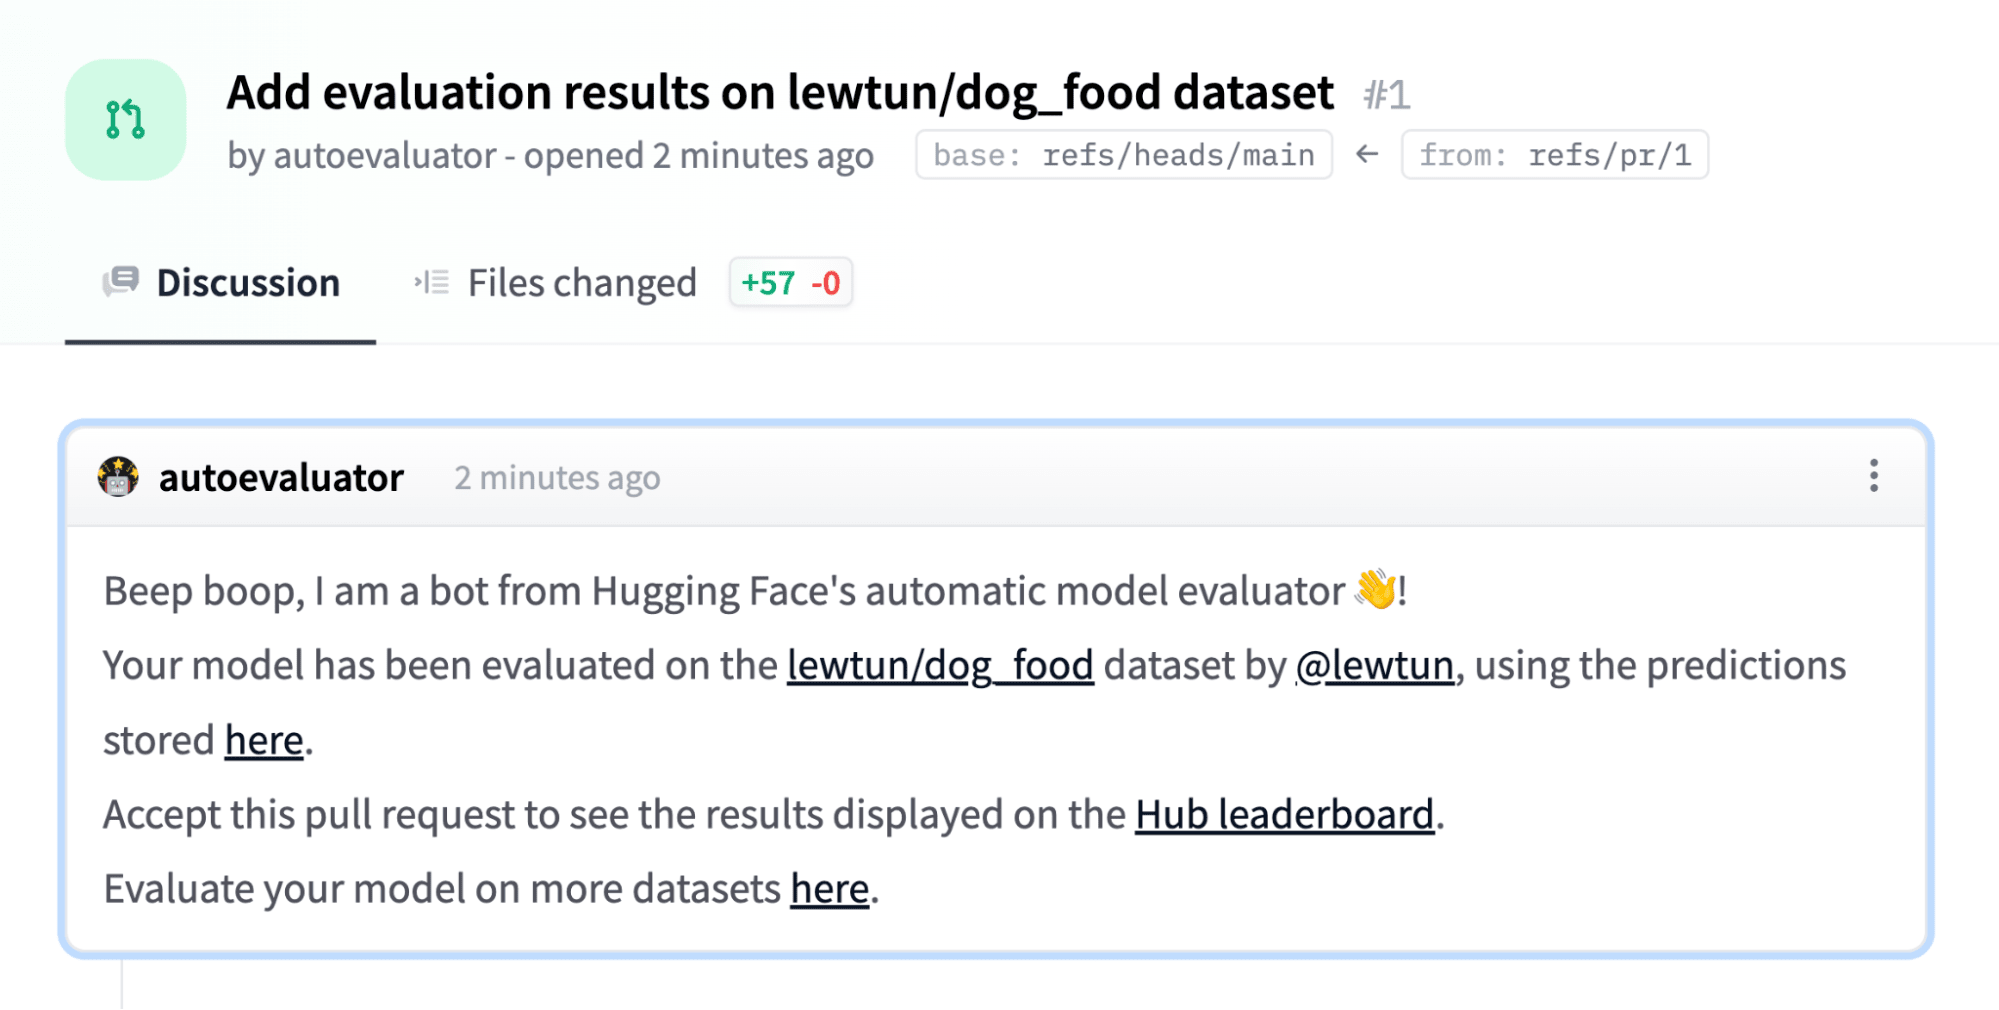
你也可以将评估元数据复制粘贴到数据集卡片中,这样你和社区下次就可以跳过手动配置了!
查看排行榜
为了方便模型比较,Evaluation on the Hub 还提供了排行榜,让你可以查看哪些模型在哪个数据划分和指标上表现最佳:
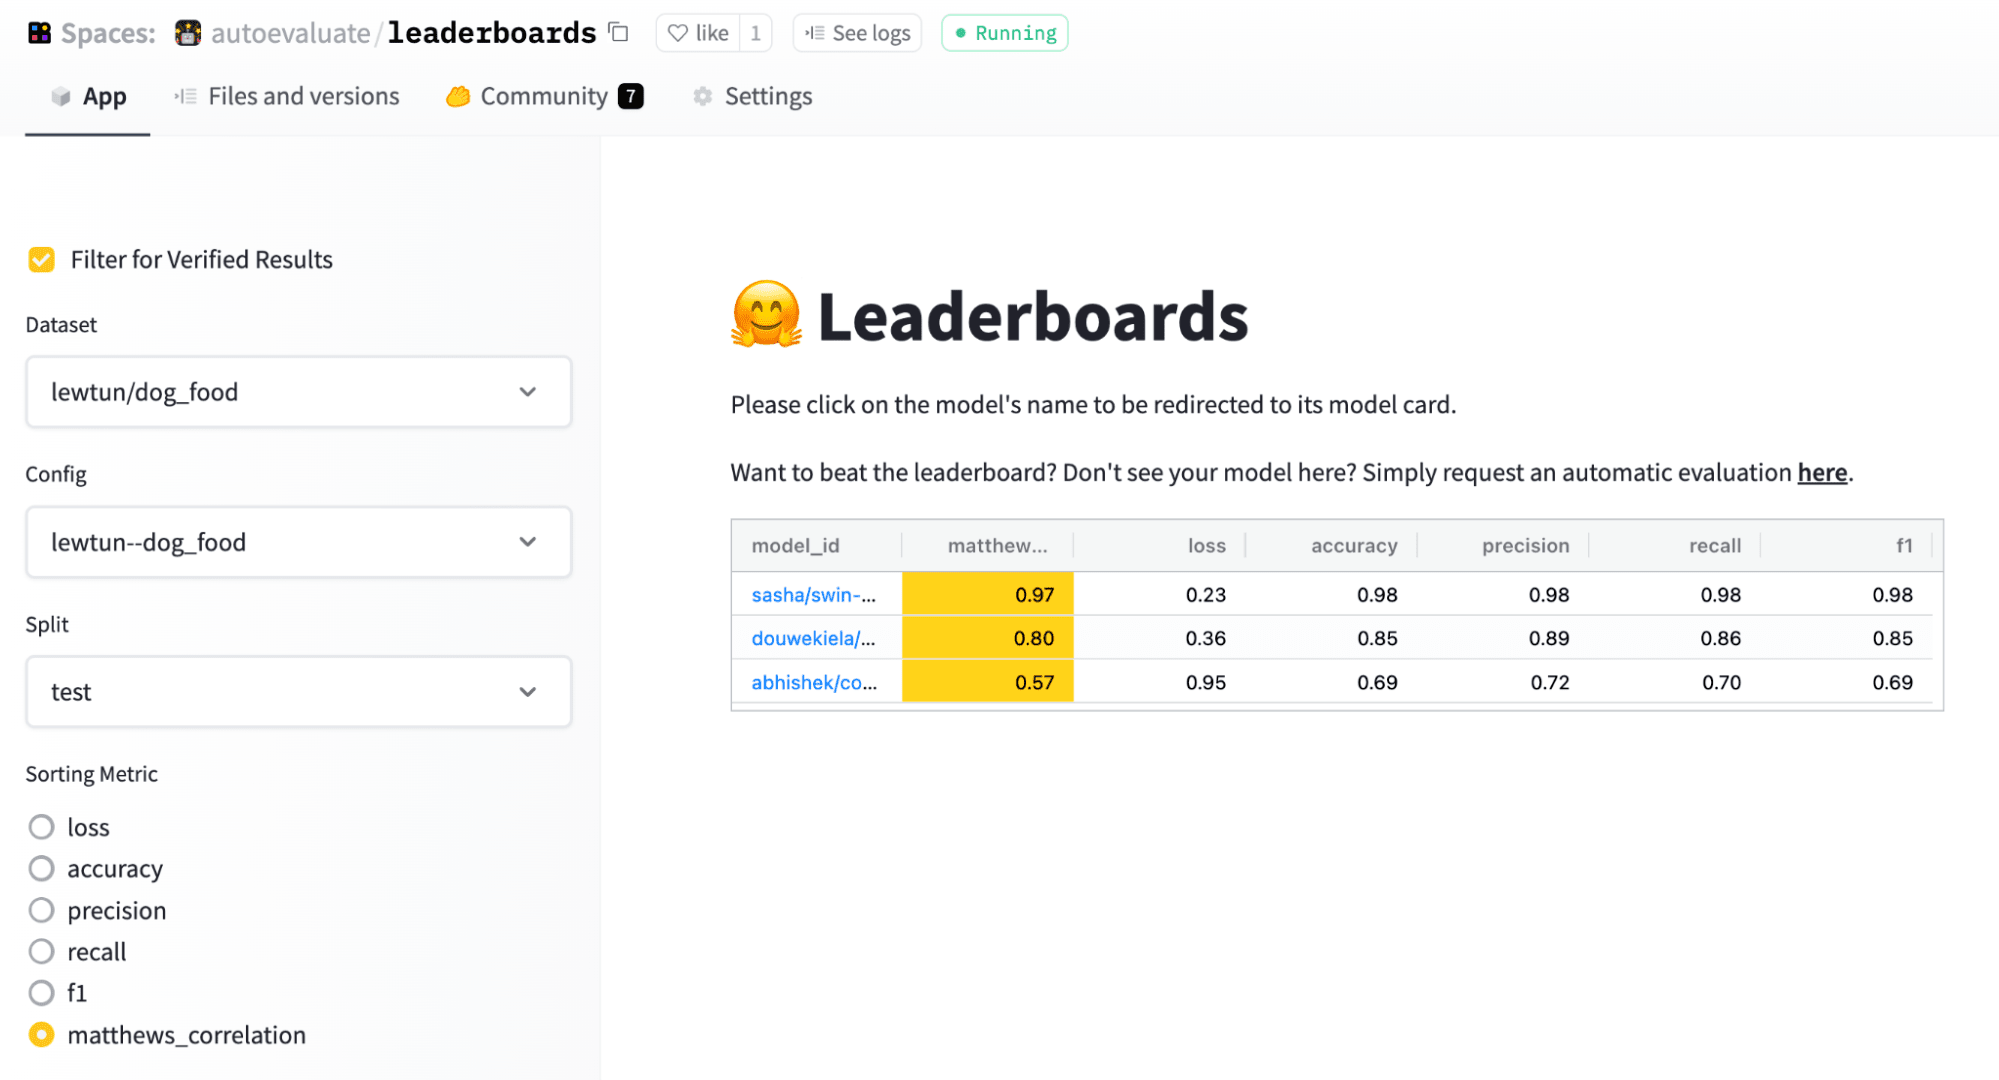
看起来 Swin Transformer 拔得头筹!
自己试试吧!
如果你想评估自己选择的模型,不妨通过查看这些热门数据集来体验一下 Evaluation on the Hub:
- Emotion 用于文本分类
- MasakhaNER 用于命名实体识别
- SAMSum 用于文本摘要
更大的图景
自机器学习诞生以来,我们一直通过在假定独立同分布的留出测试集上计算某种形式的准确率来评估模型。在现代 AI 的压力下,这一范式如今开始显现出严重的裂痕。
基准正在饱和,这意味着机器在某些测试集上超越人类的速度,几乎快于我们设计新测试集的速度。然而,众所周知,AI 系统很脆弱,并且会遭受——甚至更糟,会放大——严重的恶意偏见。可复现性不足。开放性只是事后才考虑的事。当人们紧盯排行榜时,部署模型的实际考量,如效率和公平性,往往被轻描淡写。数据在模型开发中极其重要的作用仍未得到足够重视。此外,预训练和基于提示的上下文学习实践,从一开始就模糊了“分布内”的含义。机器学习正在慢慢跟上这些变化,我们希望用我们的工作帮助该领域向前发展。
下一步
几周前,我们发布了 Hugging Face Evaluate 库,旨在降低机器学习评估最佳实践的门槛。我们还一直在托管基准,例如 RAFT 和 GEM。Evaluation on the Hub 是我们努力实现这样一个未来的合理下一步:模型以更全面的方式、沿着许多评估维度、以可信且可保证可复现的方式进行评估。敬请期待更多即将发布的内容,包括更多任务,以及一个全新改进的数据测量工具!
我们很期待看到社区会把它带向何方!如果你想帮忙,就尽情在尽可能多的数据集上评估尽可能多的模型吧。一如既往,请给我们大量反馈,可以在社区标签页或论坛上留言!
来源:Hugging Face:Blog(RSS) · huggingface.co