Hugging Face 发布开源非扩散文生图模型 aMUSEd
Welcome aMUSEd: Efficient Text-to-Image Generation
Hugging Face 发布 aMUSEd,一个基于 Masked Image Modeling 的开源非扩散文生图模型,是 Google MUSE 的开放复现,采用 OpenRAIL 许可证。
官方开源了非扩散路线的 MIM 文生图模型,给出推理效率、小体积和 LoRA 微调显存等可核验细节。
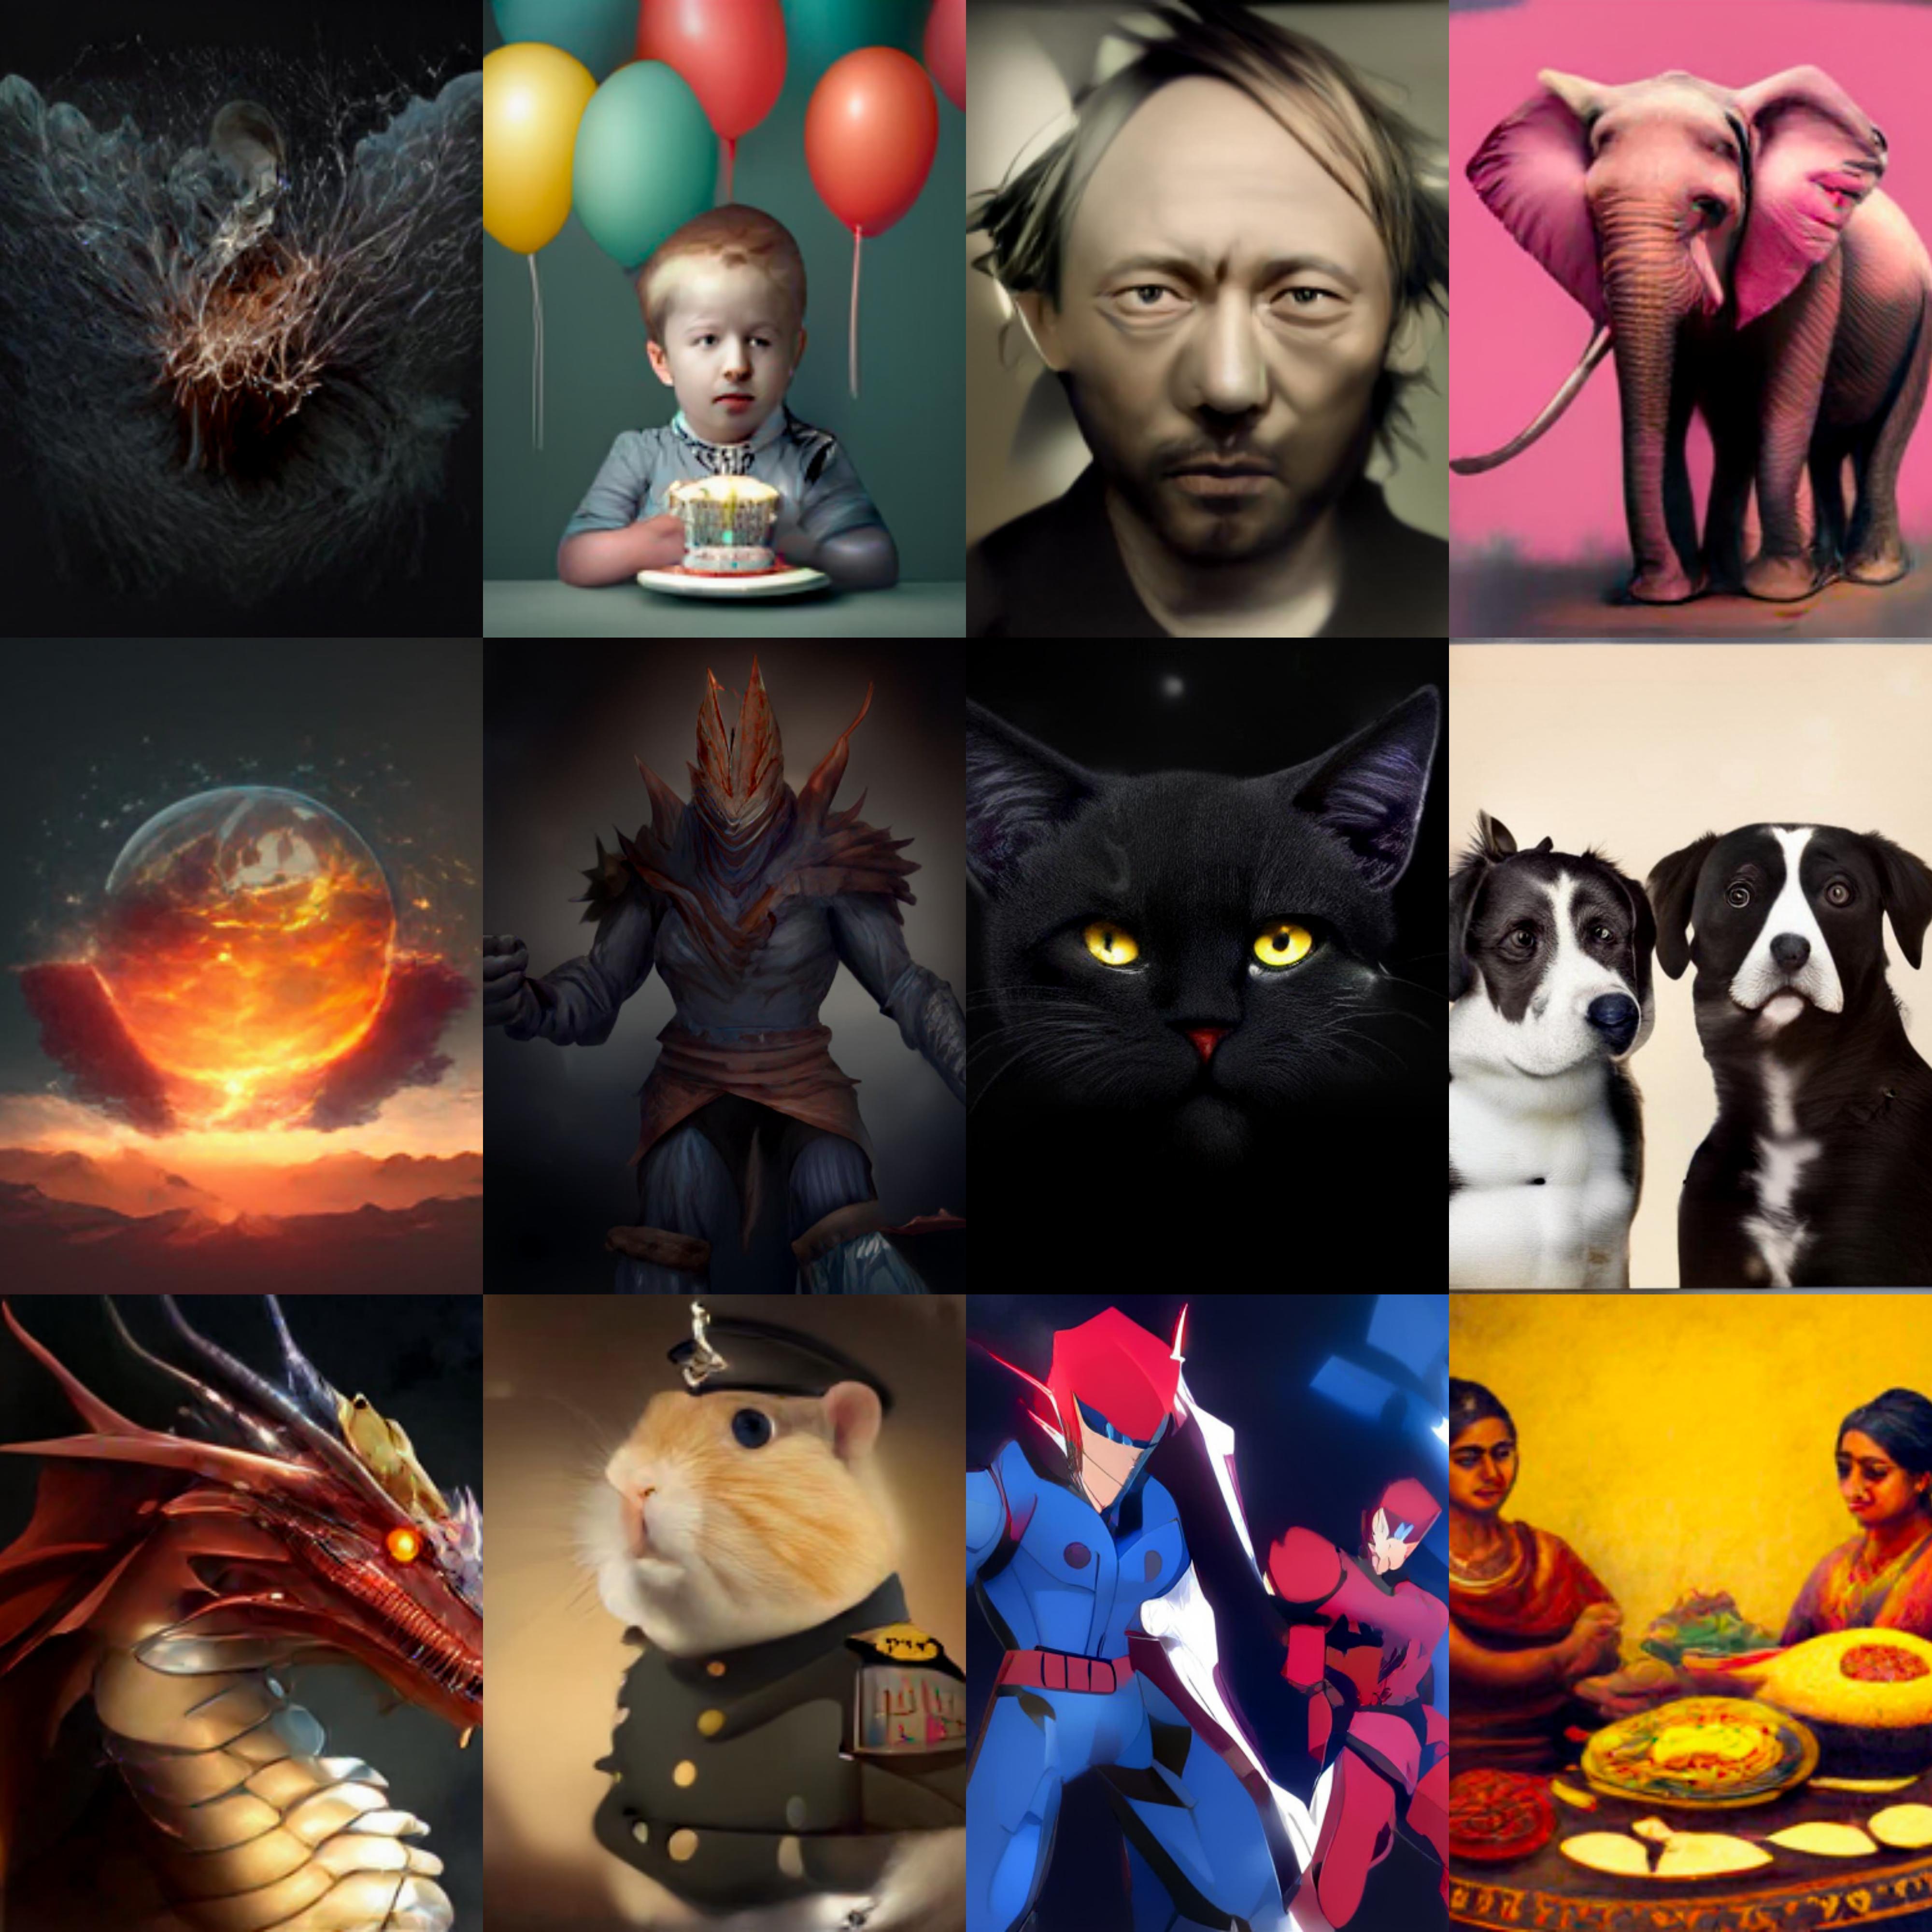
我们很高兴推出一个高效的非扩散文本到图像模型,名为 aMUSEd。之所以这样命名,是因为它是对 Google 的 MUSE 的开源复现。aMUSEd 的生成质量并非最佳,我们以宽松许可证发布这一研究预览版。
与常用的潜在扩散方法 (Rombach 等人,2022) 不同,aMUSEd 采用了掩码图像模型(MIM)方法。正如 Chang 等人(2023)所指出的,这不仅需要更少的推理步骤,还增强了模型的可解释性。
正如 MUSE 一样,aMUSEd 展现出使用单张图像进行风格迁移的卓越能力,这一特性由 Sohn 等人(2023)深入探索。这一方面可能为个性化和特定风格的图像生成开辟新途径。
在这篇博客文章中,我们将介绍 aMUSEd 的一些内部机制,展示如何将其用于不同任务(包括文本到图像),并展示如何对其进行微调。在此过程中,我们将提供与 aMUSEd 相关的所有重要资源,包括其训练代码。让我们开始吧 🚀
目录
我们为读者构建了一个演示,供大家体验 aMUSEd。你可以在这个 Space 中试用,或在下方嵌入的 playground 中体验:
它是如何工作的?
aMUSEd 基于掩码图像建模。这为社区提供了一个引人注目的用例,可以在图像生成的背景下探索已知在语言建模中有效的组件。
下图展示了 aMUSEd 工作原理的图示概览。
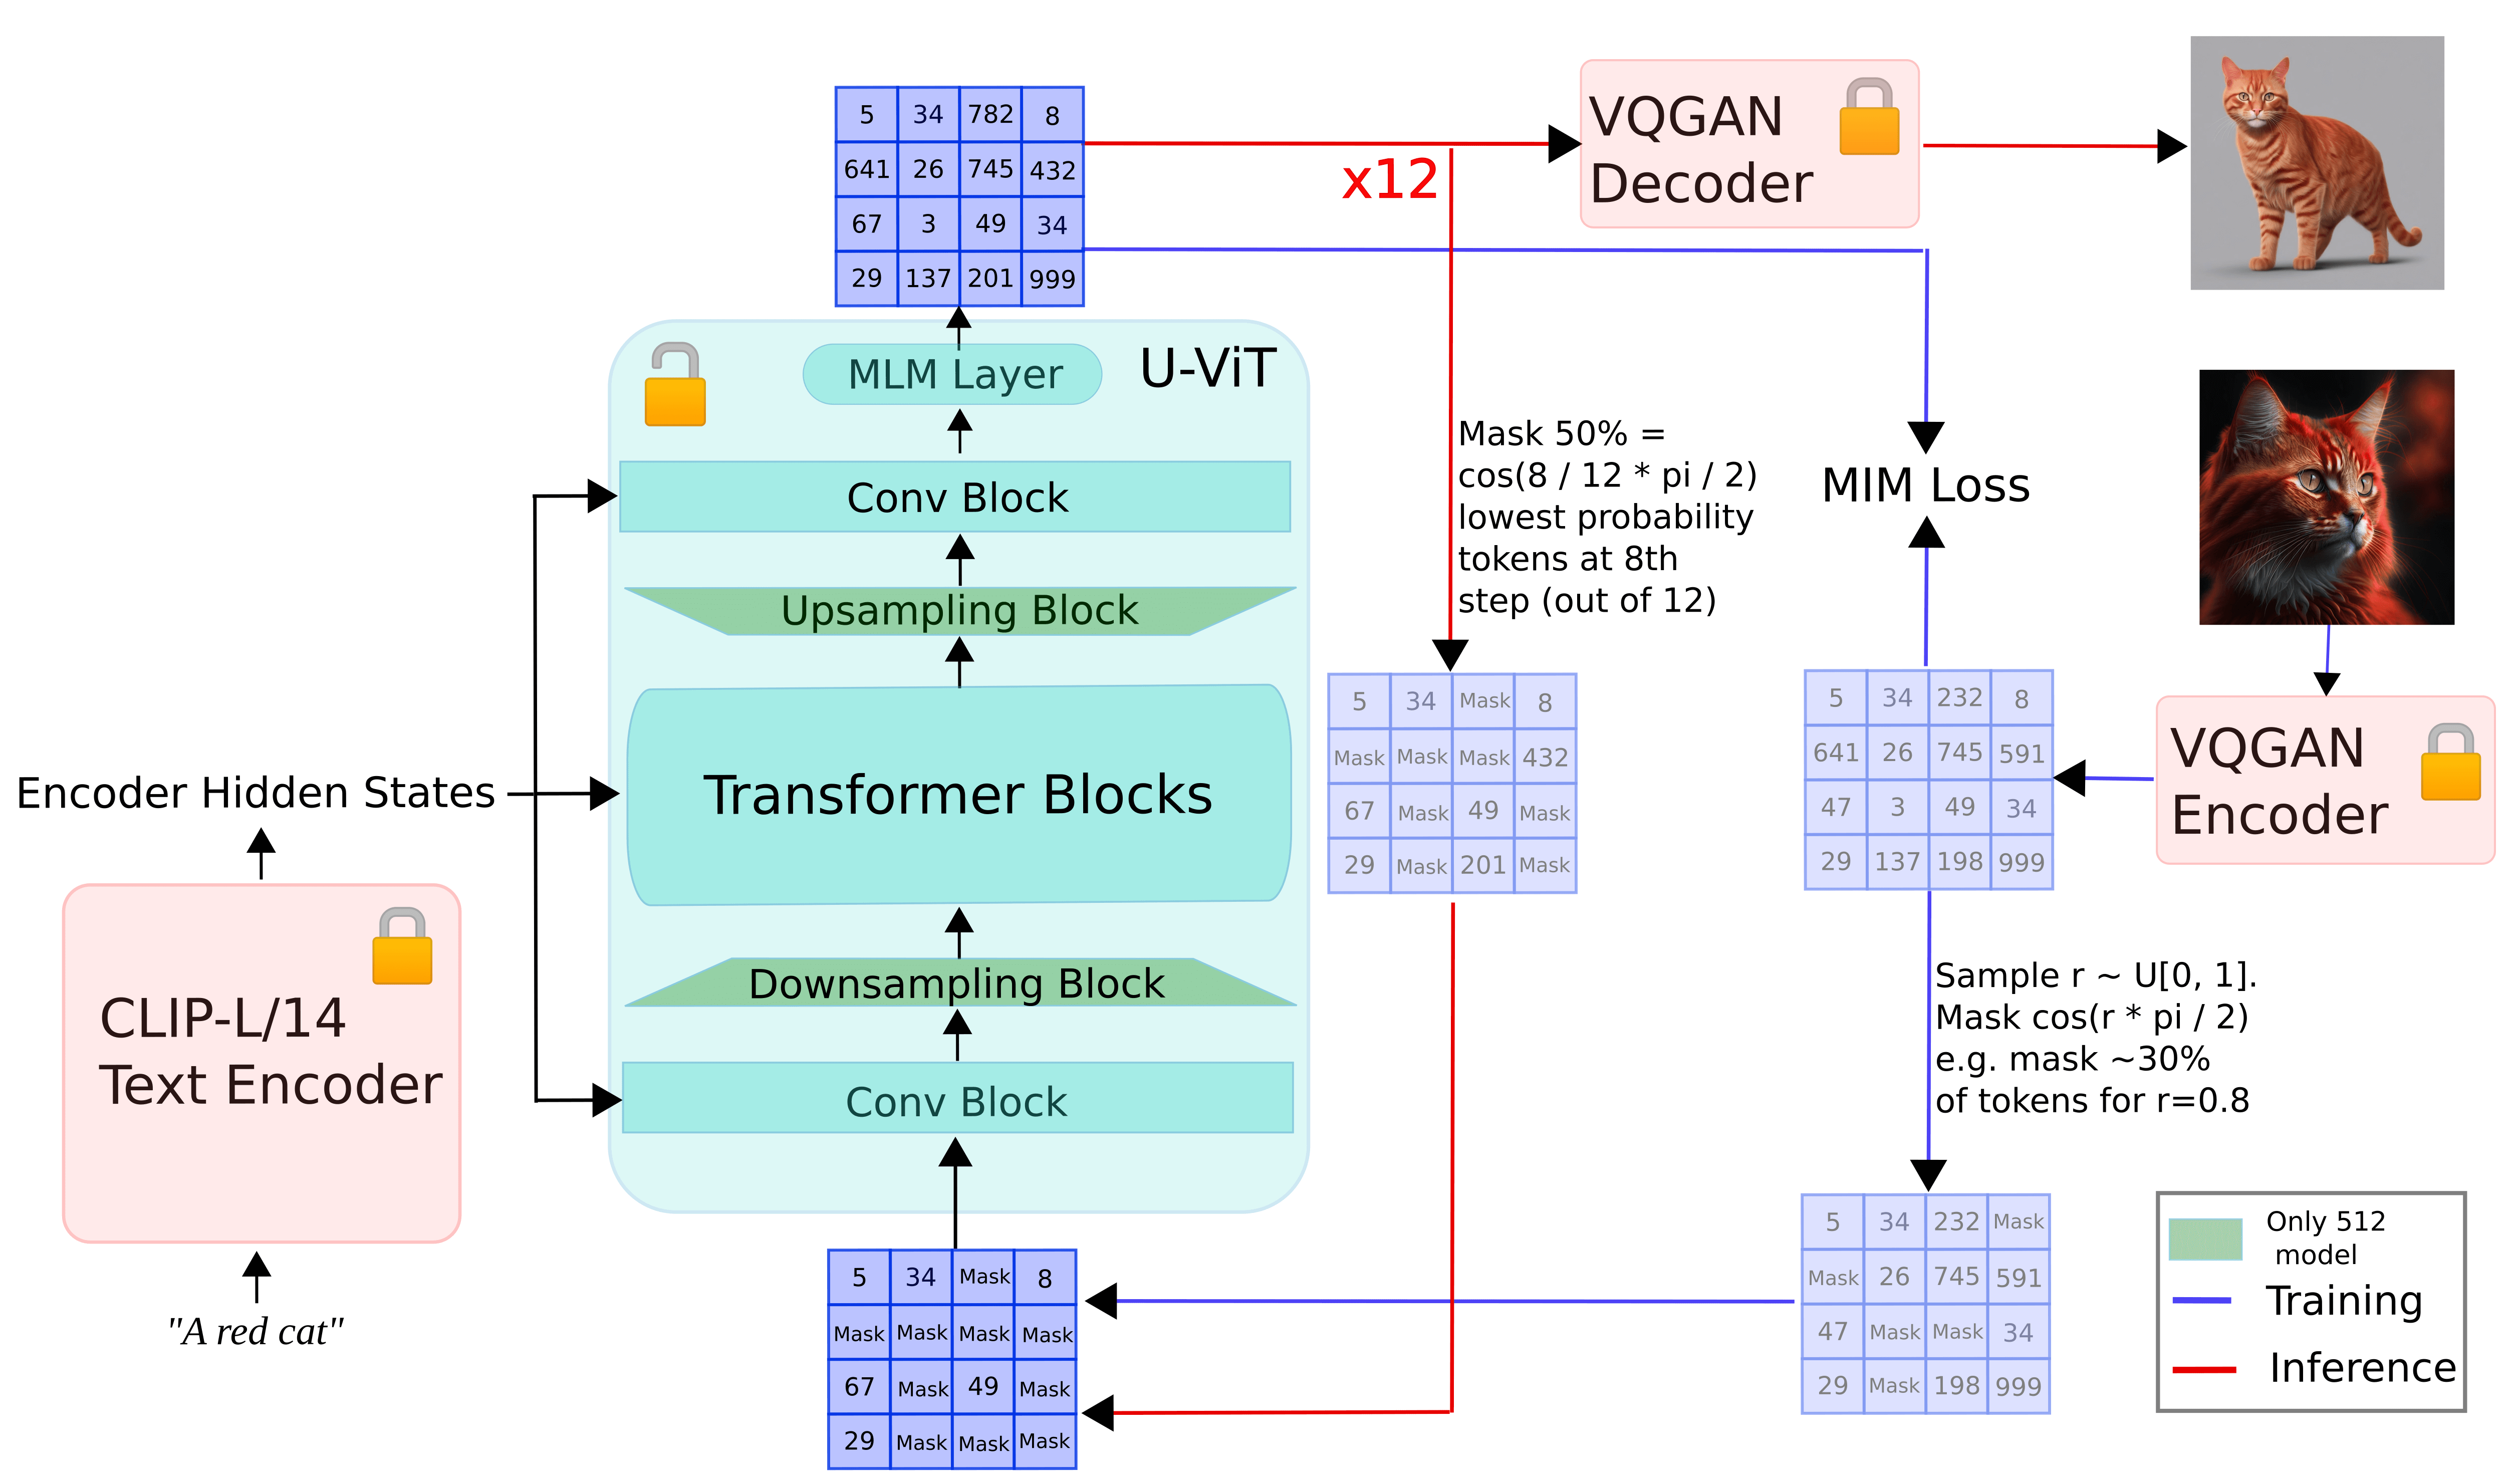
在训练期间:
- 输入图像使用 VQGAN 进行分词,以获得图像 token
- 然后根据余弦掩码调度对图像 token 进行掩码。
- 掩码后的 token(以使用 CLIP-L/14 文本编码器计算的提示嵌入为条件)被传递给 U-ViT 模型,该模型预测被掩码的图像块
在推理期间:
- 输入提示使用 CLIP-L/14 文本编码器进行嵌入。
- iterate till
Nsteps are reached:- 从随机掩码的 token 开始,将它们与提示嵌入一起传递给 U-ViT 模型
- 预测掩码 token,并根据
N和掩码调度仅保留一定比例的最有信心的预测。将剩余的进行掩码并传递给 U-ViT 模型
- 将最终输出传递给 VQGAN 解码器以获得最终图像
正如开头所提到的,aMUSEd 借鉴了 MUSE 的许多相似之处。然而,也有一些显著差异:
- aMUSEd 不采用两阶段方法来预测最终掩码的图像块。
- 不使用 T5 进行文本条件化,而是使用 CLIP L/14 来计算文本嵌入。
- 遵循 Stable Diffusion XL(SDXL),额外的条件化信息(如图像尺寸和裁剪)被传递给 U-ViT。这被称为“微条件化”。
要了解更多关于 aMUSEd 的信息,我们建议阅读技术报告此处。
在 🧨 diffusers 中使用 aMUSEd
aMUSEd 已完全集成到 🧨 diffusers 中。要使用它,我们首先需要安装这些库:
pip install -U diffusers accelerate transformers -q
让我们从文本到图像生成开始:
import torch
from diffusers import AmusedPipeline

pipe = AmusedPipeline.from_pretrained(
    "amused/amused-512", variant="fp16", torch_dtype=torch.float16
)
pipe = pipe.to("cuda")

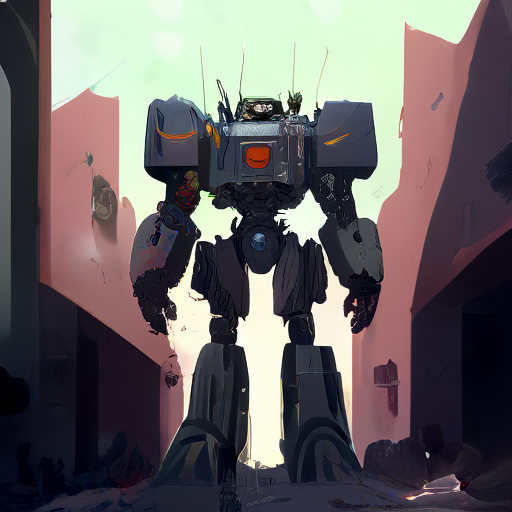
prompt = "A mecha robot in a favela in expressionist style"
negative_prompt = "low quality, ugly"

image = pipe(prompt, negative_prompt=negative_prompt, generator=torch.manual_seed(0)).images[0]
image
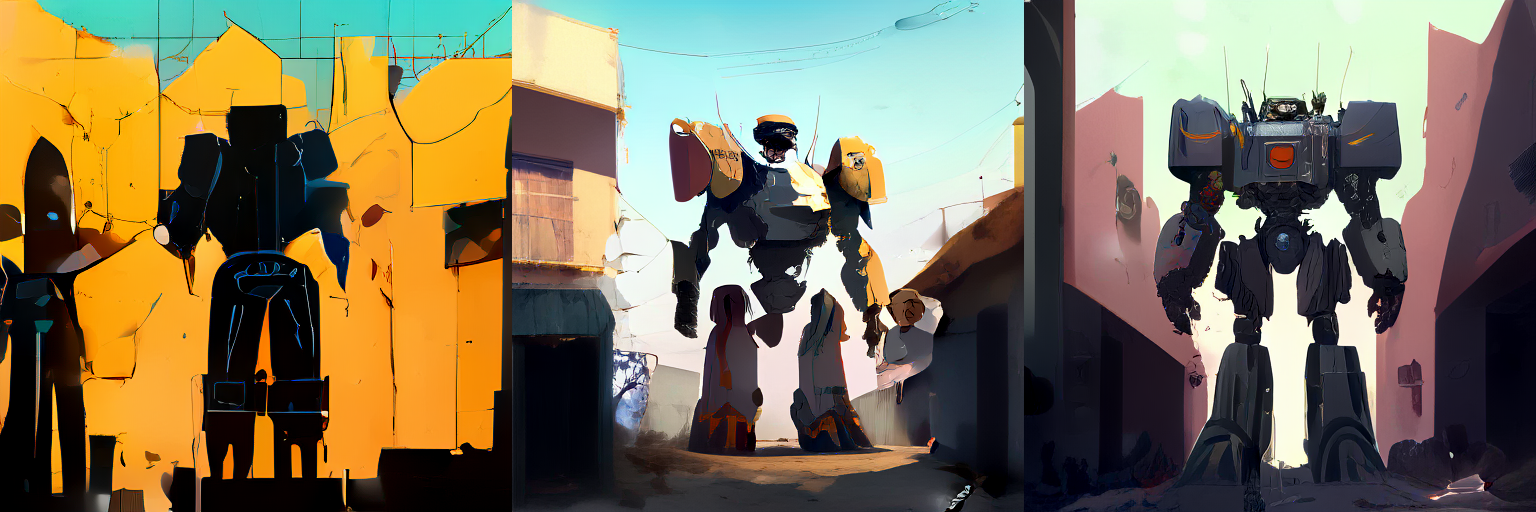
我们可以研究在固定种子下 num_inference_steps 如何影响图像质量:
from diffusers.utils import make_image_grid

images = []
for step in [5, 10, 15]:
    image = pipe(prompt, negative_prompt=negative_prompt, num_inference_steps=step, generator=torch.manual_seed(0)).images[0]
    images.append(image)

grid = make_image_grid(images, rows=1, cols=3)
grid
关键在于,由于其体积小巧(仅约 8 亿参数,包括文本编码器和 VQ-GAN),aMUSEd 速度非常快。下图对比研究了不同模型(包括 aMUSEd)的推理延迟:

作为其预训练目标的直接副产品,aMUSEd 能够零样本进行图像修复,这一点不同于 SDXL 等其他模型。
import torch
from diffusers import AmusedInpaintPipeline
from diffusers.utils import load_image
from PIL import Image

pipe = AmusedInpaintPipeline.from_pretrained(
    "amused/amused-512", variant="fp16", torch_dtype=torch.float16
)
pipe = pipe.to("cuda")

prompt = "a man with glasses"
input_image = (
    load_image(
        "https://huggingface.co/amused/amused-512/resolve/main/assets/inpainting_256_orig.png"
    )
    .resize((512, 512))
    .convert("RGB")
)
mask = (
    load_image(
        "https://huggingface.co/amused/amused-512/resolve/main/assets/inpainting_256_mask.png"
    )
    .resize((512, 512))
    .convert("L")
)

image = pipe(prompt, input_image, mask, generator=torch.manual_seed(3)).images[0]
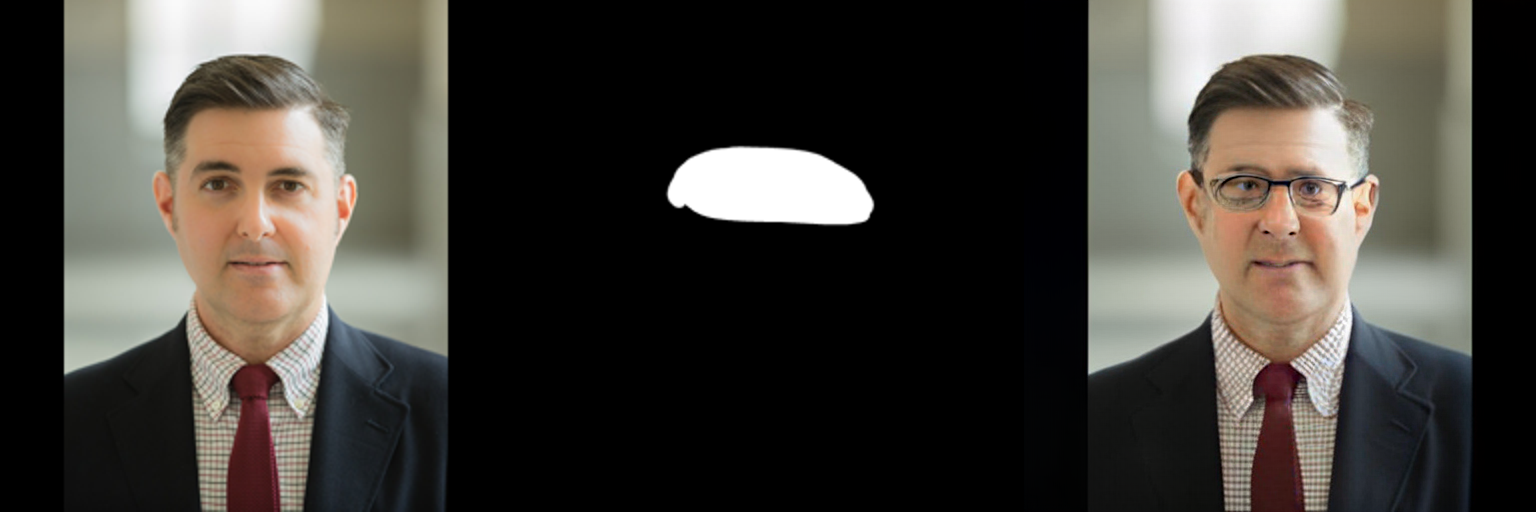
aMUSEd 是 diffusers 中的首个非扩散系统。其预测掩码块的迭代调度方法使其成为 diffusers 的理想候选。我们非常期待看到社区如何利用它。
我们鼓励您查阅技术报告,了解我们使用 aMUSEd 探索的所有任务。
微调 aMUSEd
我们提供了一个简单的 训练脚本,用于在自定义数据集上微调 aMUSEd。使用 8 位 Adam 优化器和 float16 精度,仅需不到 11GB 的 GPU 显存即可微调 aMUSEd。使用 LoRA,内存需求进一步降低至仅 7GB。

aMUSEd 采用 OpenRAIL 许可证,因此适合商业用途。有关微调的更多详细信息,请参阅此目录。
局限性
就图像质量而言,aMUSEd 并非最先进的图像生成模型。我们发布 aMUSEd 是为了鼓励社区探索像 MIM 这样的非扩散框架用于图像生成。我们认为 MIM 的潜力尚未被充分挖掘,鉴于其优势:
- 推理效率
- 体积更小,支持设备端应用
- 无需昂贵的微调即可进行任务迁移
- 语言建模领域成熟组件的优势
(请注意,MUSE 的原始工作是闭源的)
有关 aMUSEd 定量评估的详细描述,请参阅技术报告。
我们希望社区能发现这些资源有用,并有动力改进用于图像生成的 MIM 现状。
资源
论文:
- Muse: 通过掩码生成式 Transformer 进行文本到图像生成
- aMUSEd:一个开放的 MUSE 复现
- 探索使用统一文本到文本 Transformer 的迁移学习极限(T5)
- 从自然语言监督中学习可迁移的视觉模型(CLIP)
- SDXL:改进用于高分辨率图像合成的潜在扩散模型
- 简单扩散:面向高分辨率图像的端到端扩散(U-ViT)
- LoRA:大型语言模型的低秩适应
代码 + 其他:
致谢
Suraj 主导训练。William 主导数据并支持训练。Patrick von Platen 支持训练和数据,并提供了总体指导。Robin Rombach 进行了 VQGAN 训练,并提供了总体指导。Isamu Isozaki 参与了富有洞见的讨论并做出了代码贡献。
感谢 Patrick von Platen 和 Pedro Cuenca 对博客文章草稿的审阅。
来源:Hugging Face:Blog(RSS) · huggingface.co