Diffusers 团队与 T2I-Adapter 作者为 SDXL 推出 T2I-Adapter-SDXL 适配器
Efficient Controllable Generation for SDXL with T2I-Adapters
Hugging Face Diffusers 团队与 T2I-Adapter 作者合作,在 diffusers 中为 Stable Diffusion XL(SDXL)推出 T2I-Adapter-SDXL,并发布 sketch、canny、lineart、depth、openpose 五种条件的 checkpoint。
原文给出 T2I-Adapter-SDXL 与 ControlNet 的参数量和运行开销对比,以及训练设置和可用 checkpoint,便于按需选用。

T2I-Adapter 是一个高效的即插即用模型,它在冻结原始大型文本到图像模型的同时,为预训练的文本到图像模型提供额外引导。T2I-Adapter 将 T2I 模型中的内部知识与外部控制信号对齐。我们可以根据不同的条件训练各种适配器,实现丰富的控制和编辑效果。
作为同期工作,ControlNet 具有类似的功能并被广泛使用。然而,它的运行可能计算开销很大。这是因为在反向扩散过程的每个去噪步骤中,ControlNet 和 UNet 都需要运行。此外,ControlNet 强调复制 UNet 编码器作为控制模型的重要性,导致参数量更大。因此,生成过程受限于 ControlNet 的大小(越大,过程越慢)。
在这方面,T2I-Adapter 相比 ControlNet 具有竞争优势。T2I-Adapter 体积更小,并且与 ControlNet 不同,T2I-Adapter 在整个去噪过程中只需运行一次。
| 模型类型 | 模型参数 | 存储 (fp16) |
|---|---|---|
| ControlNet-SDXL | 1251 M | 2.5 GB |
| ControlLoRA(秩为 128) | 197.78 M(减少 84.19%) | 396 MB(减少 84.53%) |
| T2I-Adapter-SDXL | 79 M(减少 93.69%) | 158 MB(减少 94%) |
在过去几周里,Diffusers 团队与 T2I-Adapter 作者合作,在 diffusers 中为 Stable Diffusion XL (SDXL) 带来了对 T2I-Adapter 的支持。在这篇博文中,我们分享了从头开始在 SDXL 上训练 T2I-Adapter 的发现、一些引人注目的结果,当然还有各种条件(sketch、canny、lineart、depth 和 openpose)下的 T2I-Adapter 检查点!
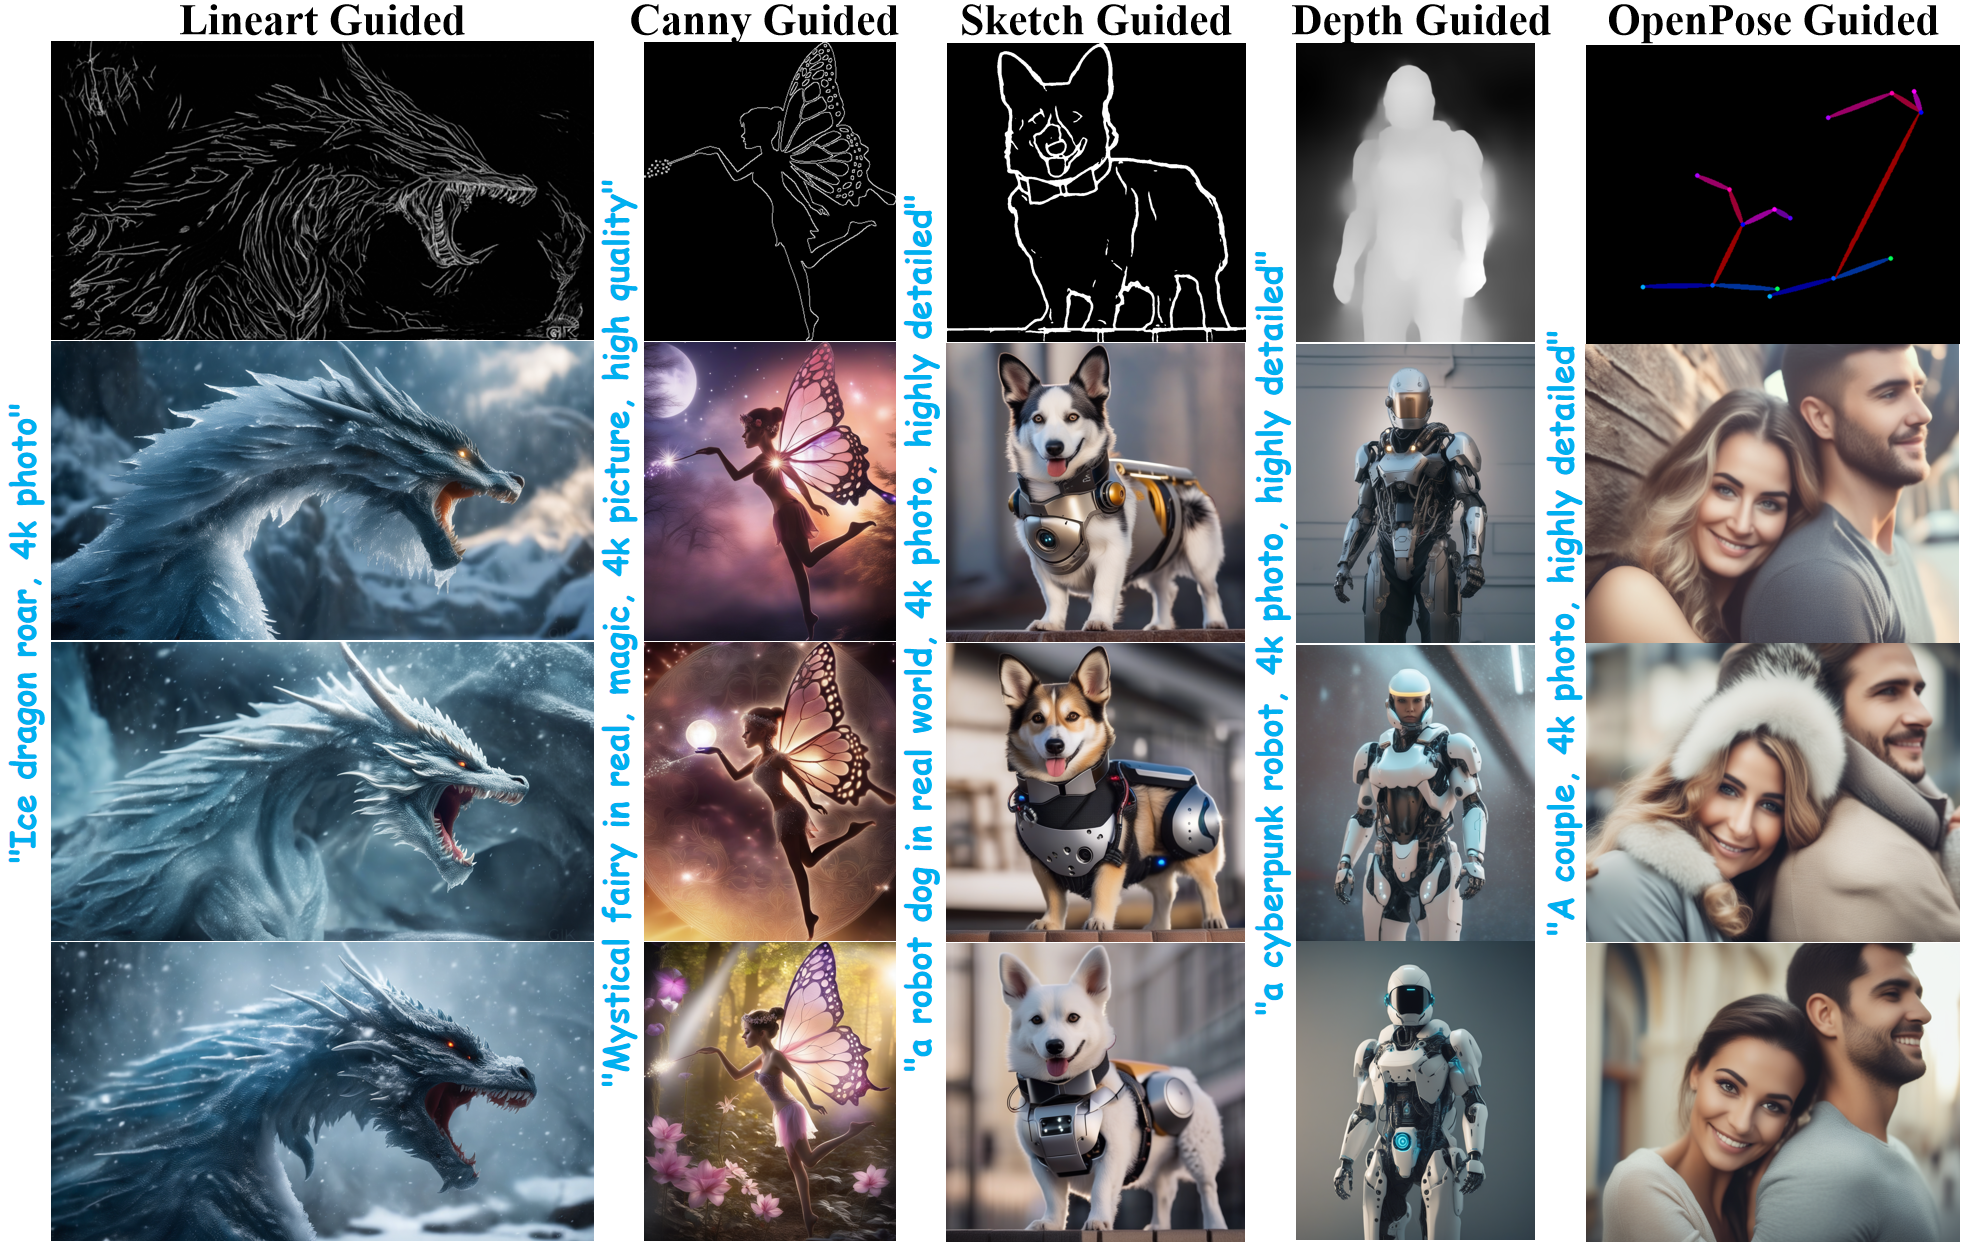
与之前版本的 T2I-Adapter(SD-1.4/1.5)相比,T2I-Adapter-SDXL 仍然使用原始配方,用 79M 的 Adapter 驱动 2.6B 的 SDXL!T2I-Adapter-SDXL 在保持强大控制能力的同时,继承了 SDXL 的高质量生成!
使用 diffusers 训练 T2I-Adapter-SDXL
我们的训练脚本基于 diffusers 提供的这个官方示例构建。
我们在本篇博文中提到的大多数 T2I-Adapter 模型都是在来自 LAION-Aesthetics V2 的 3M 高分辨率图文对上训练的,设置如下:
- 训练步数:20000-35000
- 批量大小:数据并行,单 GPU 批量大小为 16,总批量大小为 128。
- 学习率:恒定学习率 1e-5。
- 混合精度:fp16
我们鼓励社区使用我们的脚本训练自定义且强大的 T2I-Adapter,在速度、内存和质量之间取得有竞争力的权衡。
在 diffusers 中使用 T2I-Adapter-SDXL
这里,我们以 lineart 条件为例来演示 T2I-Adapter-SDXL 的用法。要开始使用,首先安装所需的依赖项:
pip install -U git+https://github.com/huggingface/diffusers.git
pip install -U controlnet_aux==0.0.7 # for conditioning models and detectors
pip install transformers accelerate
T2I-Adapter-SDXL 的生成过程主要包括以下两个步骤:
- 首先将条件图像准备为合适的控制图像格式。
- 将控制图像和提示词传递给
StableDiffusionXLAdapterPipeline。
让我们看一个使用 Lineart Adapter 的简单示例。我们首先初始化 SDXL 的 T2I-Adapter 管道和 lineart 检测器。
import torch
from controlnet_aux.lineart import LineartDetector
from diffusers import (AutoencoderKL, EulerAncestralDiscreteScheduler,
                       StableDiffusionXLAdapterPipeline, T2IAdapter)
from diffusers.utils import load_image, make_image_grid

# load adapter
adapter = T2IAdapter.from_pretrained(
    "TencentARC/t2i-adapter-lineart-sdxl-1.0", torch_dtype=torch.float16, varient="fp16"
).to("cuda")

# load pipeline
model_id = "stabilityai/stable-diffusion-xl-base-1.0"
euler_a = EulerAncestralDiscreteScheduler.from_pretrained(
    model_id, subfolder="scheduler"
)
vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix", torch_dtype=torch.float16
)
pipe = StableDiffusionXLAdapterPipeline.from_pretrained(
    model_id,
    vae=vae,
    adapter=adapter,
    scheduler=euler_a,
    torch_dtype=torch.float16,
    variant="fp16",
).to("cuda")

# load lineart detector
line_detector = LineartDetector.from_pretrained("lllyasviel/Annotators").to("cuda")
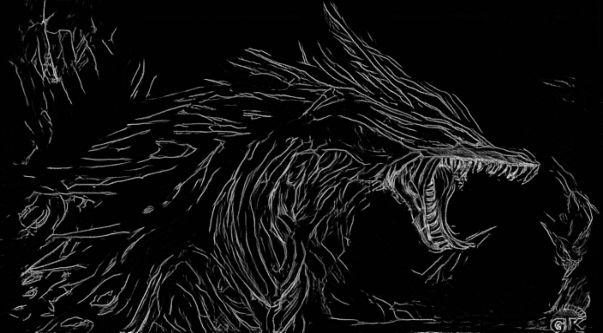
然后,加载一张图像以检测线稿:
url = "https://huggingface.co/Adapter/t2iadapter/resolve/main/figs_SDXLV1.0/org_lin.jpg"
image = load_image(url)
image = line_detector(image, detect_resolution=384, image_resolution=1024)
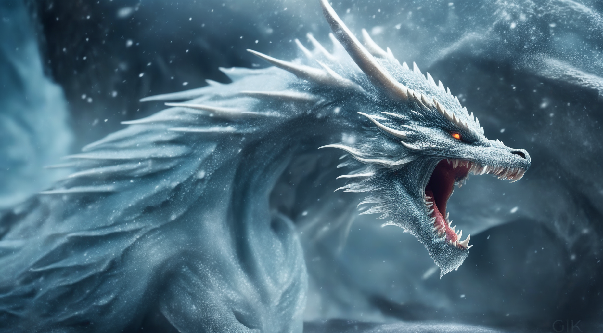
然后我们生成:
prompt = "Ice dragon roar, 4k photo"
negative_prompt = "anime, cartoon, graphic, text, painting, crayon, graphite, abstract, glitch, deformed, mutated, ugly, disfigured"
gen_images = pipe(
    prompt=prompt,
    negative_prompt=negative_prompt,
    image=image,
    num_inference_steps=30,
    adapter_conditioning_scale=0.8,
    guidance_scale=7.5,
).images[0]
gen_images.save("out_lin.png")
有两个重要参数需要理解,它们有助于你控制条件化的程度。
adapter_conditioning_scale该参数控制条件化对输入的影响程度。值越高意味着条件化效果越强,反之亦然。
adapter_conditioning_factor该参数控制应在多少个初始生成步骤中应用条件化。该值应设置在 0-1 之间(默认值为 1)。值为
adapter_conditioning_factor=1表示适配器应应用于所有时间步,而adapter_conditioning_factor=0.5表示它仅应用于前 50% 的步骤。
如需了解更多详情,欢迎查阅官方文档。
试试演示
你可以在这个 Space 中或下方嵌入的 playground 中轻松试用 T2I-Adapter-SDXL:
你还可以试试Doodly,它使用 sketch 模型构建,能将你的涂鸦变成逼真的图像(带有语言监督):
更多结果
下面,我们展示使用不同类型条件获得的结果。我们还补充了对应预训练检查点的链接。它们的模型卡片包含有关其训练方式的更多细节,以及示例用法。
线稿引导
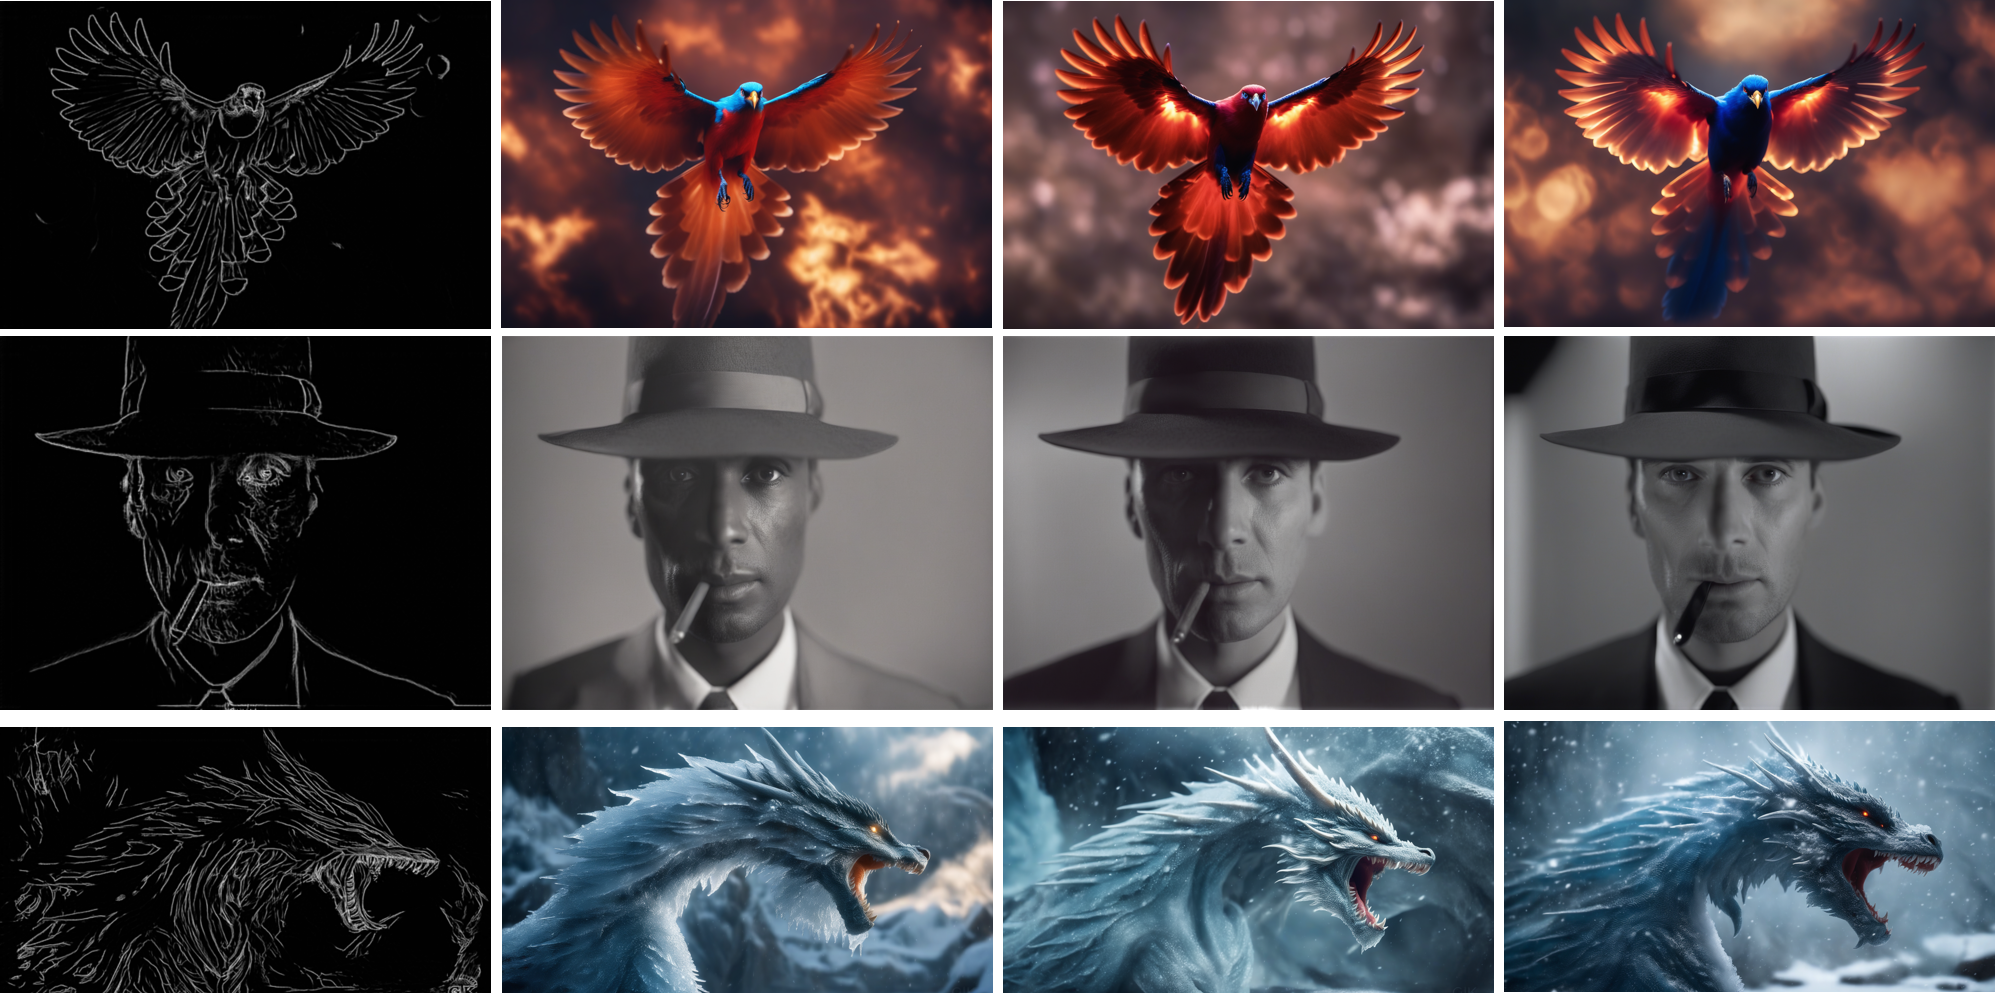 模型来自
TencentARC/t2i-adapter-lineart-sdxl-1.0
素描引导
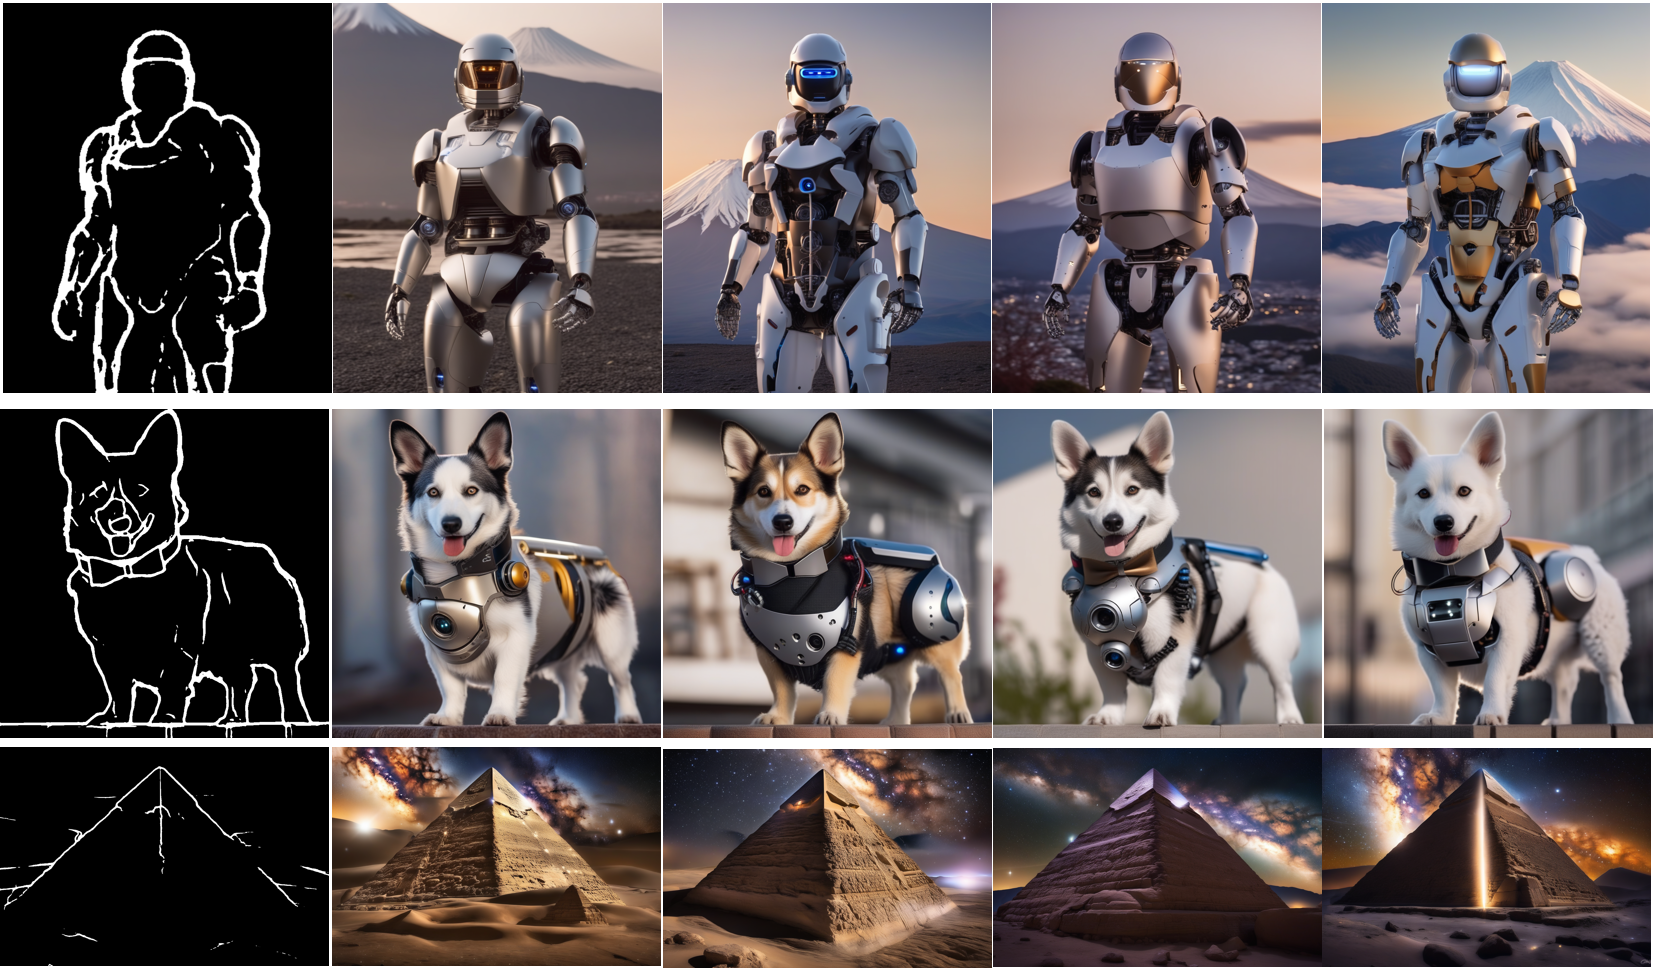 模型来自
TencentARC/t2i-adapter-sketch-sdxl-1.0
Canny 引导
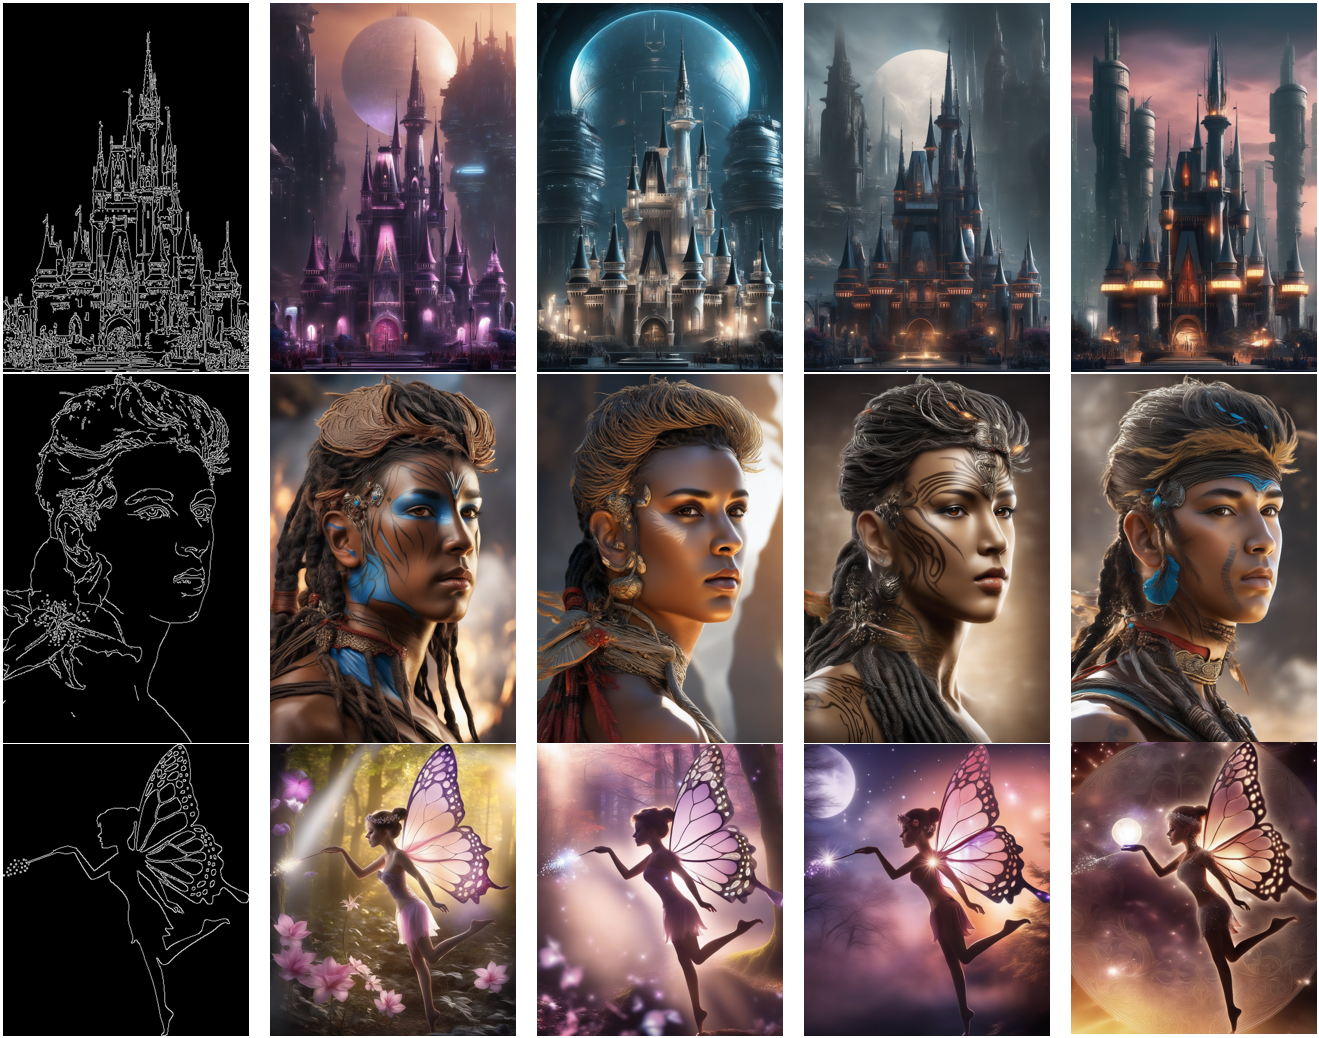 模型来自
TencentARC/t2i-adapter-canny-sdxl-1.0
深度引导
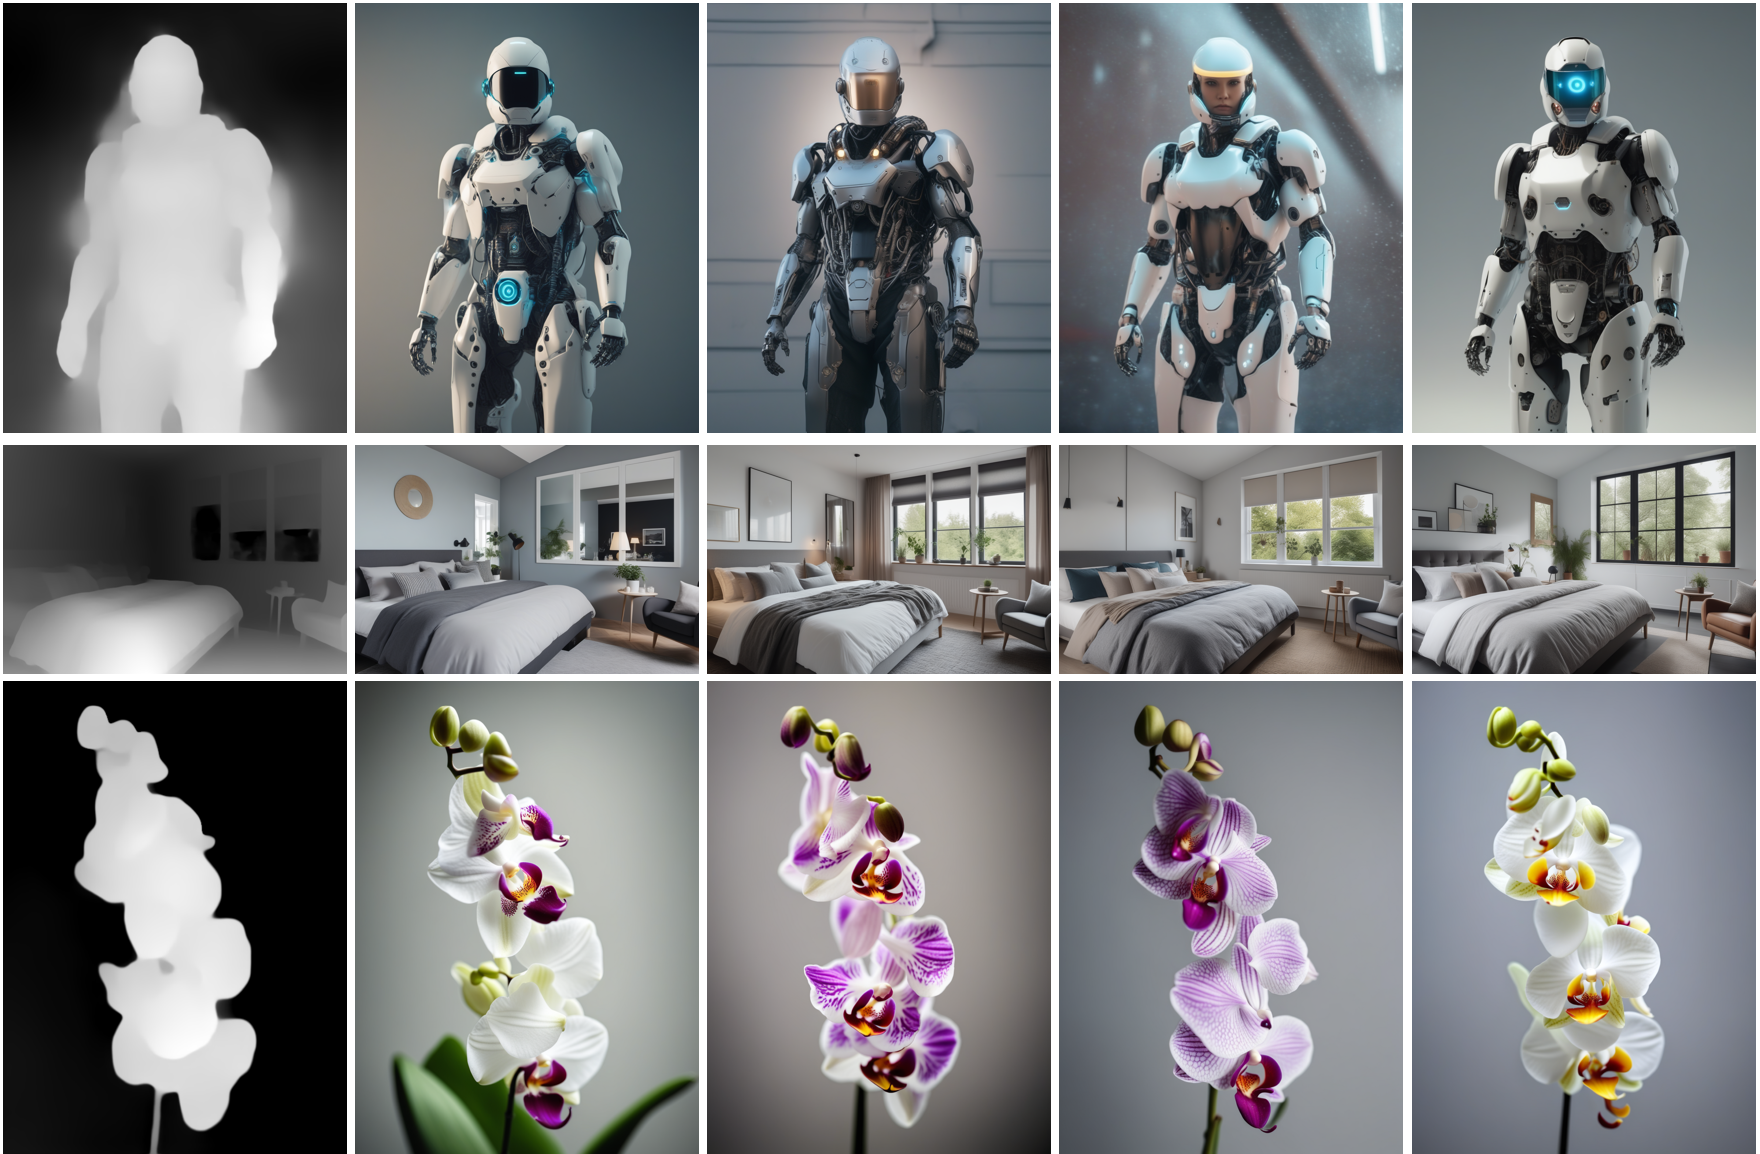 深度引导模型分别来自
TencentARC/t2i-adapter-depth-midas-sdxl-1.0 和 TencentARC/t2i-adapter-depth-zoe-sdxl-1.0
OpenPose 引导
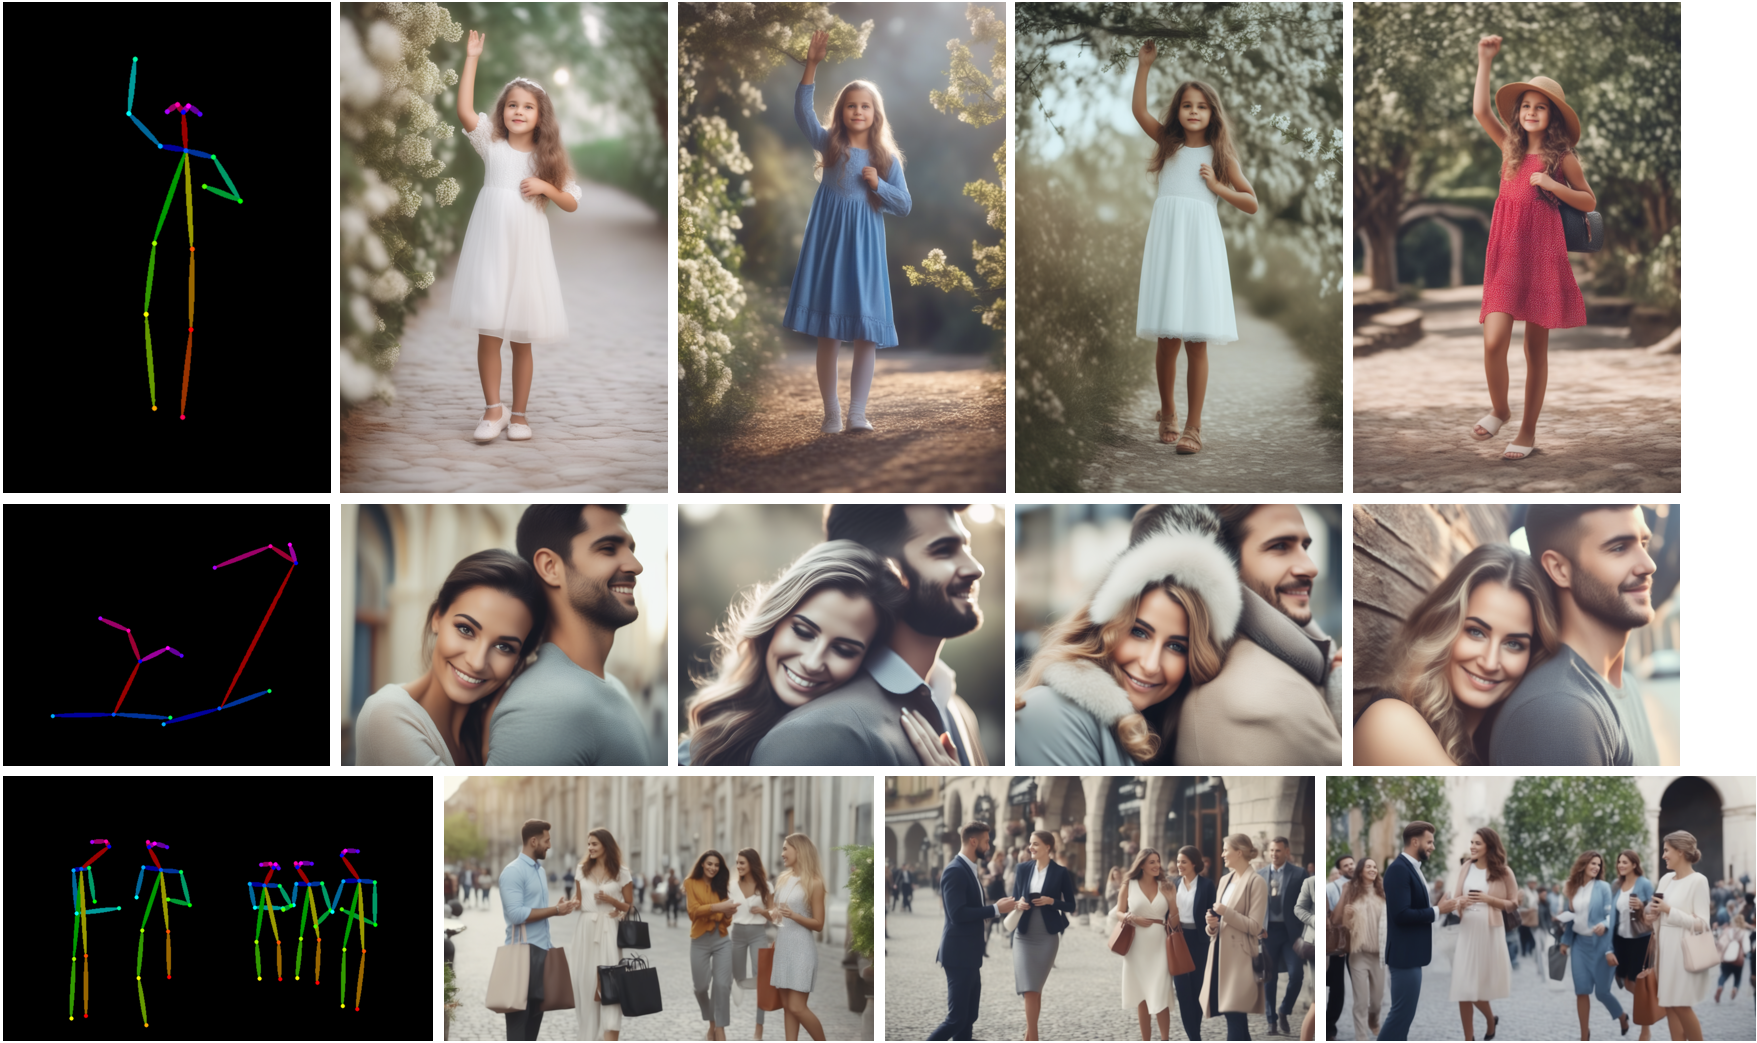 模型来自
TencentARC/t2i-adapter-openpose-sdxl-1.0
致谢:非常感谢 William Berman 帮助我们训练模型并分享他的见解。
来源:Hugging Face:Blog(RSS) · huggingface.co