Hugging Face 嵌入向量入门教程:用 Sentence Transformers 构建 FAQ 语义搜索
Getting Started With Embeddings
Hugging Face 发布嵌入向量入门教程,演示如何用 Inference API 和 sentence-transformers/all-MiniLM-L6-v2 模型将 13 条 Medicare FAQ 嵌入为 384 维向量,再通过 util.semantic_search 用余弦相似度找出与用户查询最相似的 5 条 FAQ。
教程用开源工具完整走通嵌入生成、托管和语义搜索流程,读者可以照着复现一个 FAQ 检索引擎。
查看本教程及 Notebook Companion:

理解嵌入
嵌入是信息(例如文本、文档、图像、音频等)的数值表示。该表示捕捉了被嵌入内容的语义含义,使其对许多行业应用都具有鲁棒性。
给定文本“投票的主要好处是什么?”,该句子的嵌入可以在向量空间中表示,例如用 384 个数字的列表(例如 [0.84, 0.42, ..., 0.02])。由于这个列表捕捉了含义,我们可以做令人兴奋的事情,比如计算不同嵌入之间的距离,以确定两个句子的含义匹配程度。
嵌入并不局限于文本!你还可以创建图像的嵌入(例如,384 个数字的列表),并将其与文本嵌入进行比较,以确定某个句子是否描述了该图像。这一概念是图像搜索、分类、描述等强大系统的基础!
嵌入是如何生成的?名为 Sentence Transformers 的开源库允许你免费从图像和文本创建最先进的嵌入。本博客展示了使用该库的一个示例。
嵌入有什么用?
“[...] 一旦你理解了这种机器学习多面手(嵌入),你就能构建从搜索引擎到推荐系统再到聊天机器人等等的一切。你不需要是具备机器学习专业知识的数据科学家就能使用它们,也不需要庞大的标注数据集。”——Dale Markowitz,Google Cloud。
一旦一条信息(一个句子、一份文档、一张图像)被嵌入,创造力就开始了;一些有趣的工业应用使用了嵌入。例如,Google 搜索使用嵌入来匹配文本到文本以及文本到图像;Snapchat 使用它们来“在正确的时间向正确的用户投放正确的广告”;Meta(Facebook)将它们用于其社交搜索。
在这些公司能够从嵌入中获得智能之前,它们必须先嵌入自己的信息片段。嵌入数据集使算法能够快速搜索、排序、分组等等。然而,这可能既昂贵又在技术上复杂。在这篇文章中,我们使用简单的开源工具来展示嵌入和分析数据集可以多么容易。
嵌入入门
我们将创建一个小型常见问题解答(FAQ)引擎:接收用户的查询并识别哪个 FAQ 最相似。我们将使用美国社会保障 Medicare 常见问题解答。
但首先,我们需要嵌入我们的数据集(其他文本会互换使用术语 encode 和 embed)。Hugging Face Inference API 允许我们通过一个快速的 POST 调用轻松嵌入数据集。
由于嵌入捕捉了问题的语义含义,因此可以比较不同的嵌入,看看它们有多不同或相似。得益于此,你可以获得与查询最相似的嵌入,这相当于找到最相似的 FAQ。查看我们的语义搜索教程,以更详细地了解这种机制的工作原理。
简而言之,我们将:
- 使用 Inference API 嵌入 Medicare 的 FAQ。
- 将嵌入后的问题上传到 Hub 以免费托管。
- 将客户的查询与嵌入数据集进行比较,以确定哪个是最相似的 FAQ。
1. 嵌入数据集
第一步是选择一个现有的预训练模型来创建嵌入。我们可以从 Sentence Transformers 库中选择一个模型。在这种情况下,让我们使用 "sentence-transformers/all-MiniLM-L6-v2",因为它是一个小而强大的模型。在未来的文章中,我们将研究其他模型及其权衡。
登录 Hub。你必须在你的 账户设置中创建一个写入令牌。我们将把写入令牌存储在 hf_token 中。
model_id = "sentence-transformers/all-MiniLM-L6-v2"
hf_token = "get your token in http://hf.co/settings/tokens"
要生成嵌入,你可以使用带有标头 {"Authorization": f"Bearer {hf_token}"} 的 https://api-inference.huggingface.co/pipeline/feature-extraction/{model_id} 端点。这里有一个函数,它接收一个包含文本的字典并返回一个包含嵌入的列表。
import requests

api_url = f"https://api-inference.huggingface.co/pipeline/feature-extraction/{model_id}"
headers = {"Authorization": f"Bearer {hf_token}"}
第一次生成嵌入时,API 可能需要一段时间(大约 20 秒)才能返回它们。我们使用 retry 装饰器(用 pip install retry 安装),这样如果第一次尝试时 output = query(dict(inputs = texts)) 不起作用,等待 10 秒并再试三次。这是因为在第一次请求时,模型需要在服务器上下载和安装,但后续调用要快得多。
def query(texts):
    response = requests.post(api_url, headers=headers, json={"inputs": texts, "options":{"wait_for_model":True}})
    return response.json()
当前的 API 不强制执行严格的速率限制。相反,Hugging Face 在我们所有可用资源之间均匀地平衡负载,并倾向于稳定的请求流。如果你需要嵌入多个文本或图像,Hugging Face 加速推理 API 将加速推理,并让你选择使用 CPU 或 GPU。
texts = ["How do I get a replacement Medicare card?",
        "What is the monthly premium for Medicare Part B?",
        "How do I terminate my Medicare Part B (medical insurance)?",
        "How do I sign up for Medicare?",
        "Can I sign up for Medicare Part B if I am working and have health insurance through an employer?",
        "How do I sign up for Medicare Part B if I already have Part A?",
        "What are Medicare late enrollment penalties?",
        "What is Medicare and who can get it?",
        "How can I get help with my Medicare Part A and Part B premiums?",
        "What are the different parts of Medicare?",
        "Will my Medicare premiums be higher because of my higher income?",
        "What is TRICARE ?",
        "Should I sign up for Medicare Part B if I have Veterans' Benefits?"]

output = query(texts)
作为响应,你会得到一个列表的列表。每个列表包含一个 FAQ 的嵌入。模型 "sentence-transformers/all-MiniLM-L6-v2" 将输入问题编码为 13 个大小为 384 的嵌入。让我们把这个列表转换为形状为 (13x384) 的 Pandas DataFrame。
import pandas as pd
embeddings = pd.DataFrame(output)
它看起来类似于这个矩阵:
[[-0.02388945  0.05525852 -0.01165488 ...  0.00577787  0.03409787  -0.0068891 ]
 [-0.0126876   0.04687412 -0.01050217 ... -0.02310316 -0.00278466   0.01047371]
 [ 0.00049438  0.11941205  0.00522949 ...  0.01687654 -0.02386115   0.00526433]
 ...
 [-0.03900796 -0.01060951 -0.00738271 ... -0.08390449  0.03768405   0.00231361]
 [-0.09598278 -0.06301168 -0.11690582 ...  0.00549841  0.1528919   0.02472013]
 [-0.01162949  0.05961934  0.01650903 ... -0.02821241 -0.00116556   0.0010672 ]]
2. 在 Hugging Face Hub 上免费托管嵌入
🤗 Datasets 是一个用于快速访问和共享数据集的库。让我们使用用户界面(UI)将嵌入数据集托管在 Hub 中。然后,任何人都可以用一行代码加载它。你也可以使用终端来共享数据集;请参阅文档了解步骤。在本条目的 notebook 伴侣中,你将能够使用终端来共享数据集。如果你想跳过这一部分,请查看包含嵌入 FAQ 的 ITESM/embedded_faqs_medicare 仓库。
首先,我们将嵌入从 Pandas DataFrame 导出为 CSV。你可以以任何你喜欢的方式保存数据集,例如 zip 或 pickle;你不需要使用 Pandas 或 CSV。由于我们的嵌入文件不大,我们可以将其存储在 CSV 中,这很容易被我们在下一节中使用的 datasets.load_dataset() 函数推断出来(参见 Datasets 文档),即我们不需要创建加载脚本。我们将以名称 embeddings.csv 保存嵌入。
embeddings.to_csv("embeddings.csv", index=False)
按照以下步骤在 Hub 中托管 embeddings.csv。
- 点击 Hub UI 右上角的你的用户。
- 使用“New dataset”创建一个数据集。
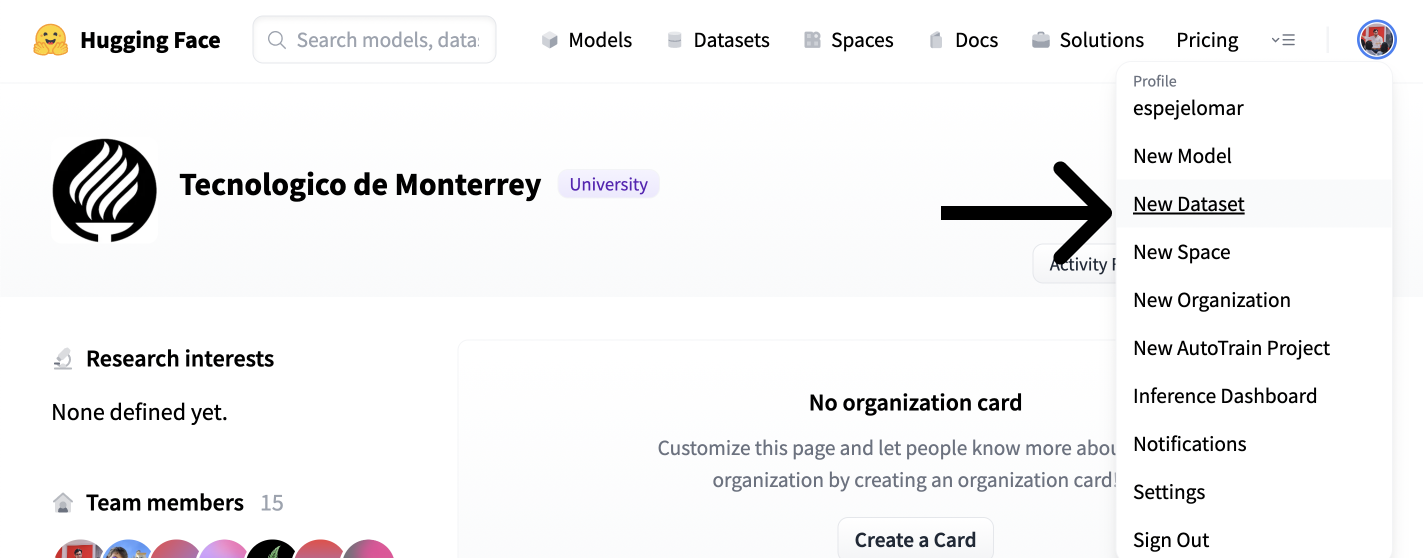
- 选择数据集的 Owner(组织或个人)、名称和许可证。选择你希望它是私有还是公开的。创建数据集。

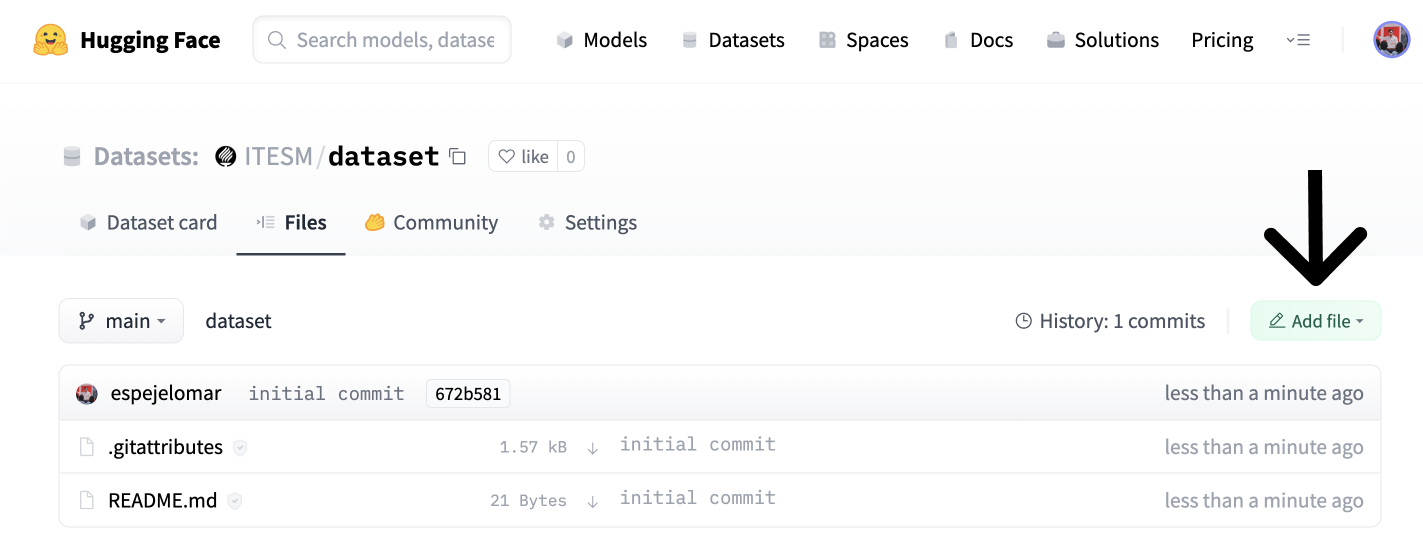
- 转到“Files”选项卡(下面的截图),然后点击“Add file”和“Upload file”。
- 最后,拖放或上传数据集,并提交更改。
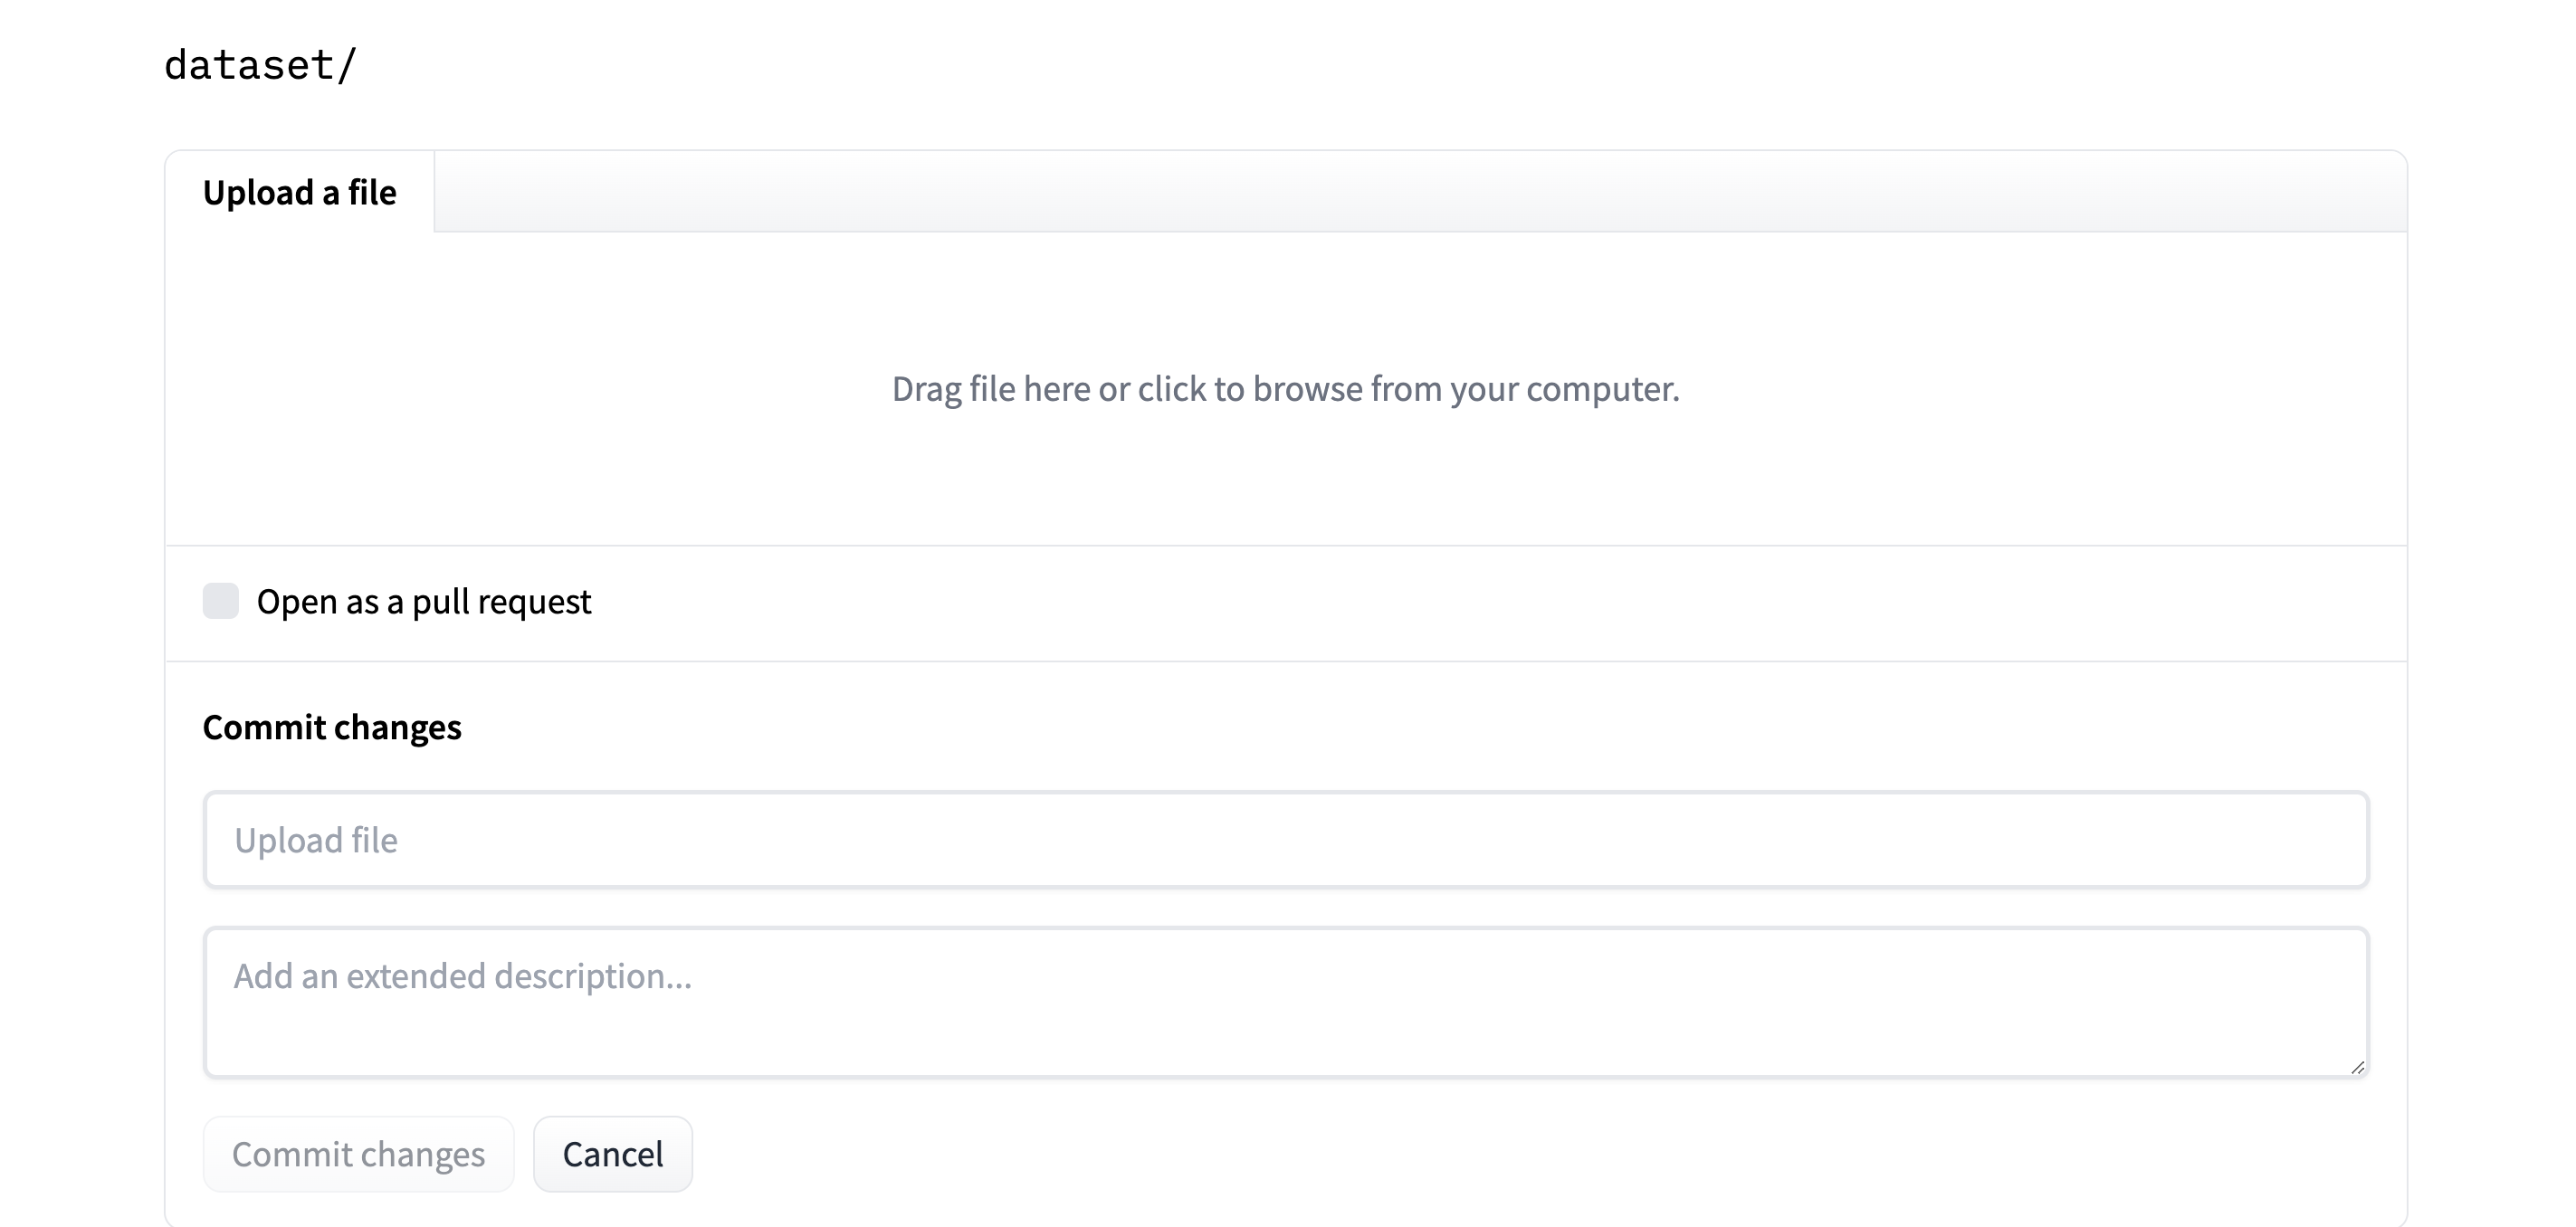
现在数据集免费托管在 Hub 上。你(或你想与之共享嵌入的任何人)可以快速加载它们。让我们看看如何操作。
3. 获取与查询最相似的常见问题解答
假设一位 Medicare 客户问:“Medicare 能如何帮助我?”我们将找出我们的哪些 FAQ 最能回答用户查询。我们会为查询创建一个嵌入,以表示其语义含义。然后将其与 FAQ 数据集中的每个嵌入进行比较,以确定在向量空间中哪个与查询最接近。
使用 pip install datasets 安装 🤗 Datasets 库。然后,从 Hub 加载嵌入数据集并将其转换为 PyTorch FloatTensor。请注意,这不是操作 Dataset 的唯一方式;例如,你可以使用 NumPy、Tensorflow 或 SciPy(请参阅文档)。如果你想用真实数据集练习,ITESM/embedded_faqs_medicare 仓库包含嵌入的 FAQ,或者你可以使用本博客的配套 notebook。
import torch
from datasets import load_dataset

faqs_embeddings = load_dataset('namespace/repo_name')
dataset_embeddings = torch.from_numpy(faqs_embeddings["train"].to_pandas().to_numpy()).to(torch.float)
我们使用之前定义的查询函数来嵌入客户的问题,并将其转换为 PyTorch FloatTensor,以便高效地对其进行操作。请注意,加载嵌入数据集后,我们可以使用 Dataset 的 add_faiss_index 和 search 方法,通过 faiss 库来识别与嵌入查询最接近的 FAQ。这里有一个关于替代方案的不错教程。
question = ["How can Medicare help me?"]
output = query(question)

query_embeddings = torch.FloatTensor(output)
你可以使用 Sentence Transformers 库中的 util.semantic_search 函数来确定哪些 FAQ 与用户查询最接近(最相似)。该函数默认使用余弦相似度来确定嵌入的接近程度。不过,你也可以使用其他衡量向量空间中两点之间距离的函数,例如点积。
使用 pip install -U sentence-transformers 安装 sentence-transformers,并搜索与查询最相似的五条 FAQ。
from sentence_transformers.util import semantic_search

hits = semantic_search(query_embeddings, dataset_embeddings, top_k=5)
util.semantic_search 会识别 13 条 FAQ 中每一条与客户查询的接近程度,并返回一个包含前 top_k 条 FAQ 的字典列表。hits 看起来像这样:
[{'corpus_id': 8, 'score': 0.75653076171875},
 {'corpus_id': 7, 'score': 0.7418993711471558},
 {'corpus_id': 3, 'score': 0.7252674102783203},
 {'corpus_id': 9, 'score': 0.6735571622848511},
 {'corpus_id': 10, 'score': 0.6505177617073059}]
corpus_id 中的值使我们能够索引我们在第一节中定义的 texts 列表,并获取最相似的五条 FAQ:
print([texts[hits[0][i]['corpus_id']] for i in range(len(hits[0]))])
以下是 5 条与客户查询最接近的 FAQ:
['How can I get help with my Medicare Part A and Part B premiums?',
 'What is Medicare and who can get it?',
 'How do I sign up for Medicare?',
 'What are the different parts of Medicare?',
 'Will my Medicare premiums be higher because of my higher income?']
这个列表代表了与客户查询最接近的 5 条 FAQ。很好!我们在这里使用 PyTorch 和 Sentence Transformers 作为主要的数值工具。不过,我们也可以使用 NumPy 和 SciPy 等工具自行定义余弦相似度和排序函数。
继续学习的额外资源
如果你想进一步了解 Sentence Transformers 库:
- Hub 组织,包含所有新模型以及如何下载模型的说明。
- Nils Reimers 的推文,将 Sentence Transformer 模型与 GPT-3 Embeddings 进行了比较。剧透预警:Sentence Transformers 非常棒!
- Sentence Transformers 文档,
- Nima 的帖子,关于近期研究。
训练与高级技术
一旦你熟悉了使用嵌入模型,你可能想训练或微调自己的模型,或探索相关技术:
- 使用 Sentence Transformers 训练和微调嵌入模型:使用当前训练 API 训练或微调 Sentence Transformer 模型。
- 使用 Sentence Transformers 训练和微调重排序模型:为检索-重排序流程的第二阶段训练 Cross Encoder(重排序器)模型。
- 使用 Sentence Transformers 训练和微调稀疏嵌入模型:训练 SPLADE 和其他稀疏嵌入模型。
- 使用 Sentence Transformers 的多模态嵌入与重排序模型:通过同一 API 使用文本、图像、音频和视频模型。
- 使用 Sentence Transformers 训练和微调多模态嵌入与重排序模型:训练或微调多模态模型,例如用于视觉文档检索。
- 🪆 Matryoshka 嵌入模型简介:可以截断为更小维度且质量损失极小的嵌入。
- 使用 Sentence Transformers 训练速度提升 400 倍的静态嵌入模型:无需注意力机制的 CPU 友好型嵌入模型。
- 用于显著更快、更便宜检索的二进制和标量嵌入量化:在训练后压缩嵌入以削减存储并加速搜索。
感谢阅读!
来源:Hugging Face:Blog(RSS) · huggingface.co