Hugging Face 发布 swift-transformers:在 Apple 设备上用 Core ML 运行 Llama 2 等大语言模型
Releasing Swift Transformers: Run On-Device LLMs in Apple Devices
Hugging Face 发布 swift-transformers Swift 包、swift-chat 演示应用、exporters 转换包和 transformers-to-coreml 无代码转换工具,帮助 Swift 开发者在 Apple 设备上运行 LLM。
原文给出 Swift 端侧跑 Llama 2 的完整工具链和 Core ML 转换经验,开发者可复用其转换路径与优化要点。
我非常尊重 iOS/Mac 开发者。我在 2007 年开始为 iPhone 编写应用,那时甚至还没有 API 或文档。新设备在约束空间上采用了一些我们不熟悉的决策,其性能、屏幕空间、UI 惯例、网络访问、持久化和延迟的组合与我们之前所习惯的不同。然而,这个社区很快就创造出了与新范式相得益彰的一流应用。
我相信机器学习是构建软件的一种新方式,我知道许多 Swift 开发者希望将 AI 功能融入他们的应用中。机器学习生态系统已经成熟了很多,有数千个模型可以解决各种各样的问题。此外,LLM 最近已成为几乎通用的工具——只要我们能将任务建模为处理文本或类文本数据,它们就能适应新的领域。我们正在见证计算历史上的一个决定性时刻,LLM 正走出研究实验室,成为人人可用的计算工具。
然而,在应用中使用像 Llama 这样的 LLM 模型涉及多项任务,许多人都是独自面对和解决这些问题的。我们一直在探索这个领域,并希望与社区继续合作。我们的目标是创建一套工具和构建模块,帮助开发者更快地构建。
今天,我们发布这份指南,带你逐步完成使用 Core ML 在 Mac 上运行 Llama 2 等模型所需的步骤。我们还发布了 alpha 库和工具,以支持开发者的这一旅程。我们呼吁所有对机器学习感兴趣的 Swift 开发者——是所有 Swift 开发者吗?——通过 PR、bug 报告或意见来共同改进。
开始吧!
今日发布
swift-transformers,一个开发中的 Swift 包,用于在 Swift 中实现类似 transformers 的 API,专注于文本生成。它是swift-coreml-transformers的演进,目标更广泛:Hub 集成、任意分词器支持和可插拔模型。swift-chat,一个演示如何使用该包的简单应用。exporters的更新版本,一个用于 transformers 模型的 Core ML 转换包。transformers-to-coreml的更新版本,一个基于exporters构建的无代码 Core ML 转换工具。- 一些已转换的模型,例如 Llama 2 7B 或 Falcon 7B,可直接用于这些文本生成工具。
任务概览
当我发布推文展示 Falcon 或 Llama 2 在我的 Mac 上运行时,许多其他开发者问我如何将这些模型转换为 Core ML,因为他们也想在自己的应用中使用它们。转换是关键的一步,但这只是拼图的第一块。我编写这些应用的真正原因是面对任何其他开发者都会遇到的同样问题,并找出我们可以提供帮助的领域。我们将在本文的剩余部分介绍其中一些任务,说明我们在哪些方面有工具可以提供帮助(以及哪些方面没有)。
- 转换为 Core ML。我们将以 Llama 2 作为实际示例。
- 优化技术,让你的模型(和应用)运行快速并尽可能少消耗内存。这是一个贯穿整个项目的领域,没有可以套用的万能解决方案。
swift-transformers, our new library to help with some common tasks.- 分词器。分词是将文本输入转换为模型实际处理的一组数字(以及从生成的预测结果转换回文本)的方式。这远比听起来要复杂得多,因为有许多不同的选项和策略。
- 模型和 Hub 封装。如果我们想要支持 Hub 上种类繁多的模型,就不能硬编码模型设置。我们创建了一个简单的
LanguageModel抽象以及各种工具,用于从 Hub 下载模型和分词器配置文件。 - 生成算法。语言模型经过训练,可以预测一段文本之后可能出现的下一个 token 的概率分布。我们需要多次调用模型来生成文本输出,并在每一步选择一个 token。决定下一步应该选择哪个 token 有很多种方法。
- 支持的模型。并非所有模型系列都(尚)被支持。
swift-chat。这是一个小型应用,简单地展示了如何在项目中使用swift-transformers。- 缺失部分 / 后续计划。一些重要但尚未可用的内容,作为未来工作的方向。
- 资源。所有项目和工具的链接。
转换为 Core ML
Core ML 是 Apple 的原生机器学习框架,也是它所使用的文件格式的名称。将模型(例如)从 PyTorch 转换为 Core ML 后,你就可以在 Swift 应用中使用它。Core ML 框架会自动选择最佳硬件来运行你的模型:CPU、GPU,或称为神经引擎的专用张量单元。根据系统的特性和模型细节,也可以组合使用其中几种计算单元。
为了了解实际转换模型的过程,我们来看看转换最近发布的 Llama 2 模型。这个过程有时可能很复杂,但我们提供了一些工具来帮忙。这些工具并不总是有效,因为新模型不断涌现,我们需要进行调整和修改。
我们推荐的方法是:
- 使用
transformers-to-coreml转换 Space:
这是一个构建在 exporters(见下文)之上的自动化工具,它要么适用于你的模型,要么不适用。它不需要编写代码:输入 Hub 模型标识符,选择你计划使用该模型的任务,然后点击应用。如果转换成功,你可以将转换后的 Core ML 权重推送到 Hub,就完成了!
你可以访问该 Space,或直接在此处使用:
- 使用
exporters,这是一个构建在 Apple 的coremltools(见下文)之上的 Python 转换包。
这个库为你提供了更多配置转换任务的选项。此外,它还允许你创建自己的转换配置类,你可以用它来获得额外的控制或解决转换问题。
- 使用
coremltools,Apple 的转换包。
这是最底层的方法,因此提供了最大的控制权。对于某些模型(尤其是新模型),它仍然可能失败,但你始终可以选择深入源代码,尝试找出原因。
关于 Llama 2 的好消息是,我们已经完成了前期工作,转换过程可以使用这些方法中的任何一种。坏消息是,它在发布时转换失败了,我们不得不做一些修复来支持它。我们在附录中简要回顾了发生的事情,这样你可以了解在出错时该怎么做。
重要的经验教训
我遵循了一些近期模型(Llama 2、Falcon、StarCoder)的转换过程,并将我学到的东西应用到了exporters和transformers-to-coreml Space 上。以下是一些要点总结:
- 如果你必须使用
coremltools,请使用最新版本:7.0b1。尽管从技术上讲它还是 beta 版,但我已经用了好几周,它真的很好:稳定、包含大量修复、支持 PyTorch 2,并且有高级量化工具等新功能。 exporters在转换文本生成任务时不再对输出应用 softmax。我们意识到这对某些生成算法是必要的。exporters现在默认对文本模型使用固定序列长度。Core ML 有一种指定“灵活形状”的方式,这样你的输入序列可以具有 1 到比如 4096 个 token 之间的任意长度。我们发现灵活输入只能在 CPU 上运行,而不能在 GPU 或神经引擎上运行。更多调查即将进行!
我们会继续向我们的工具中添加最佳实践,这样你就不必再次发现同样的问题。
优化
如果模型不能在你的目标硬件上快速运行并合理利用系统资源,那么转换模型就没有意义。本文提到的模型对于本地使用来说相当大,我们有意识地使用它们来拓展当前技术可能性的极限,并了解瓶颈在哪里。
我们已经确定了一些关键优化领域。它们对我们来说是一个非常重要的主题,也是当前和未来工作的主题。其中一些包括:
- 缓存先前生成过程中的注意力键和值,就像 transformers 模型在 PyTorch 实现中所做的那样。注意力分数的计算需要在到目前为止生成的整个序列上运行,但所有过去的键值对已经在之前的运行中计算过了。我们目前没有为 Core ML 模型使用任何缓存机制,但计划这样做!
- 使用离散形状而不是小的固定序列长度。不使用灵活形状的主要原因是它们与 GPU 或神经引擎不兼容。次要原因是,由于如上所述缺少缓存,生成会随着序列长度的增长而变慢。使用一组离散的固定形状,再加上缓存键值对,应该可以实现更大的上下文大小和更自然的聊天体验。
- 量化技术。我们已经在 Stable Diffusion 模型的背景下探索过它们,并对它们将带来的选项感到非常兴奋。例如,6 位调色板化可以减小模型大小,并且资源利用效率高。混合位量化是一种新技术,可以实现(平均)4 位量化,同时对模型质量影响很小。我们也计划为语言模型开展这些主题的工作!
对于生产应用,考虑使用较小的模型进行迭代,尤其是在开发期间,然后应用优化技术来选择你的用例所能承受的最小模型。
swift-transformers
swift-transformers 是一个正在开发中的 Swift 包,旨在为 Swift 开发者提供类似 transformers 的 API。让我们看看它有什么,还缺少什么。
分词器
分词解决了两个互补的任务:将文本输入适配为模型使用的张量格式,并将模型的结果转换回文本。这个过程很微妙,例如:
- 我们使用单词、字符、字符组还是字节?
- 我们应该如何处理小写与大写字母?我们是否应该处理这种差异?
- 我们应该删除重复字符(例如空格)吗,还是它们很重要?
- 我们如何处理不在模型词汇表中的单词?
有一些通用的分词算法,以及许多不同的归一化和预处理步骤,这些对于有效使用模型至关重要。transformers 库决定将所有那些操作抽象在同一个库中(tokenizers),并将这些决策表示为存储在 Hub 中与模型一起的配置文件。例如,这是 Llama 2 分词器配置的摘录,描述了仅归一化步骤:
  "normalizer": {
    "type": "Sequence",
    "normalizers": [
      {
        "type": "Prepend",
        "prepend": "▁"
      },
      {
        "type": "Replace",
        "pattern": {
          "String": " "
        },
        "content": "▁"
      }
    ]
  },
它的意思是:归一化是按顺序应用的一系列操作。首先,我们对输入字符串Prepend字符_。然后我们将所有空格替换为_。有大量的潜在操作,它们可以应用于正则表达式匹配,并且必须按非常特定的顺序执行。tokenizers库中的代码为 Hub 中的所有模型处理所有这些细节。
相比之下,在其他领域(例如 Swift 应用)中使用语言模型的项目,通常将这些决策硬编码为应用源代码的一部分。这对于几个模型来说没问题,但之后很难用不同的模型替换,而且容易出错。
我们在swift-transformers中所做的是在 Swift 中复制这些抽象,这样我们编写一次,每个人都可以在他们的应用中使用它们。我们才刚刚开始,所以覆盖范围仍然很小。欢迎在仓库中提出问题或贡献你自己的代码!
具体来说,我们目前支持 BPE(字节对编码)分词器,这是当今使用的三大主要家族之一。GPT 模型、Falcon 和 Llama 都使用这种方法。对 Unigram 和 WordPiece 分词器的支持将在稍后推出。我们还没有移植所有可能的归一化器、预分词器和后处理器——只是我们在转换 Llama 2、Falcon 和 GPT 模型时遇到的那些。
这是在 Swift 中使用Tokenizers模块的方法:
import Tokenizers

func testTokenizer() async throws {
    let tokenizer = try await AutoTokenizer.from(pretrained: "pcuenq/Llama-2-7b-chat-coreml")
    let inputIds = tokenizer("Today she took a train to the West")
    assert(inputIds == [1, 20628, 1183, 3614, 263, 7945, 304, 278, 3122])
}
然而,你通常不需要自己分词输入文本——Generation代码会处理它。
模型和 Hub 包装器
如上所述,transformers大量使用存储在 Hub 中的配置文件。我们准备了一个简单的Hub模块来从 Hub 下载配置文件,用于实例化分词器并检索有关模型的元数据。
关于模型,我们创建了一个简单的LanguageModel类型作为 Core ML 模型的包装器,专注于文本生成任务。使用协议,我们可以用相同的 API 查询任何模型。
为了检索你所使用模型的适当元数据,swift-transformers依赖于一些自定义元数据字段,这些字段必须在转换时添加到 Core ML 文件中。swift-transformers将使用此信息从 Hub 下载所有必要的配置文件。这些是我们使用的字段,如 Xcode 的模型预览中所示:

exporters 和 transformers-to-coreml 会自动为你添加这些字段。如果你手动使用 coremltools,请务必自行添加它们。
生成算法
语言模型经过训练,可以预测输入序列之后可能出现的下一个 token 的概率分布。为了组成一个回复,我们需要多次调用模型,直到它产生一个特殊的终止 token,或者达到我们期望的长度。有许多方法可以决定下一个最佳 token 是什么。我们目前支持其中两种:
- 贪心解码。这是显而易见的算法:选择概率最高的 token,将其追加到序列中,然后重复。对于相同的输入序列,这总是会产生相同的结果。
- top-k 采样。选择
top-k(其中k是一个参数)个最可能的 token,然后使用诸如temperature之类的参数从中随机采样,这会增加多样性,但代价是可能使模型跑题并失去对内容的把握。
诸如“核采样”之类的其他方法将在稍后推出。我们推荐这篇博客文章(最近更新过),它出色地概述了各种生成方法及其工作原理。诸如辅助生成之类的复杂方法对于优化也非常有用!
支持的模型
到目前为止,我们已经用一些模型测试了 swift-transformers,以验证主要的设计决策。我们期待尝试更多模型!
- Llama 2。
- Falcon。
- StarCoder 模型,基于 GPT 架构的一个变体。
- GPT 系列,包括 GPT2、distilgpt、GPT-NeoX、GPT-J。
swift-chat
swift-chat 是一个基于 swift-transformers 构建的简单演示应用。它的主要目的是展示如何在你的代码中使用 swift-transformers,但它也可以用作模型测试工具。
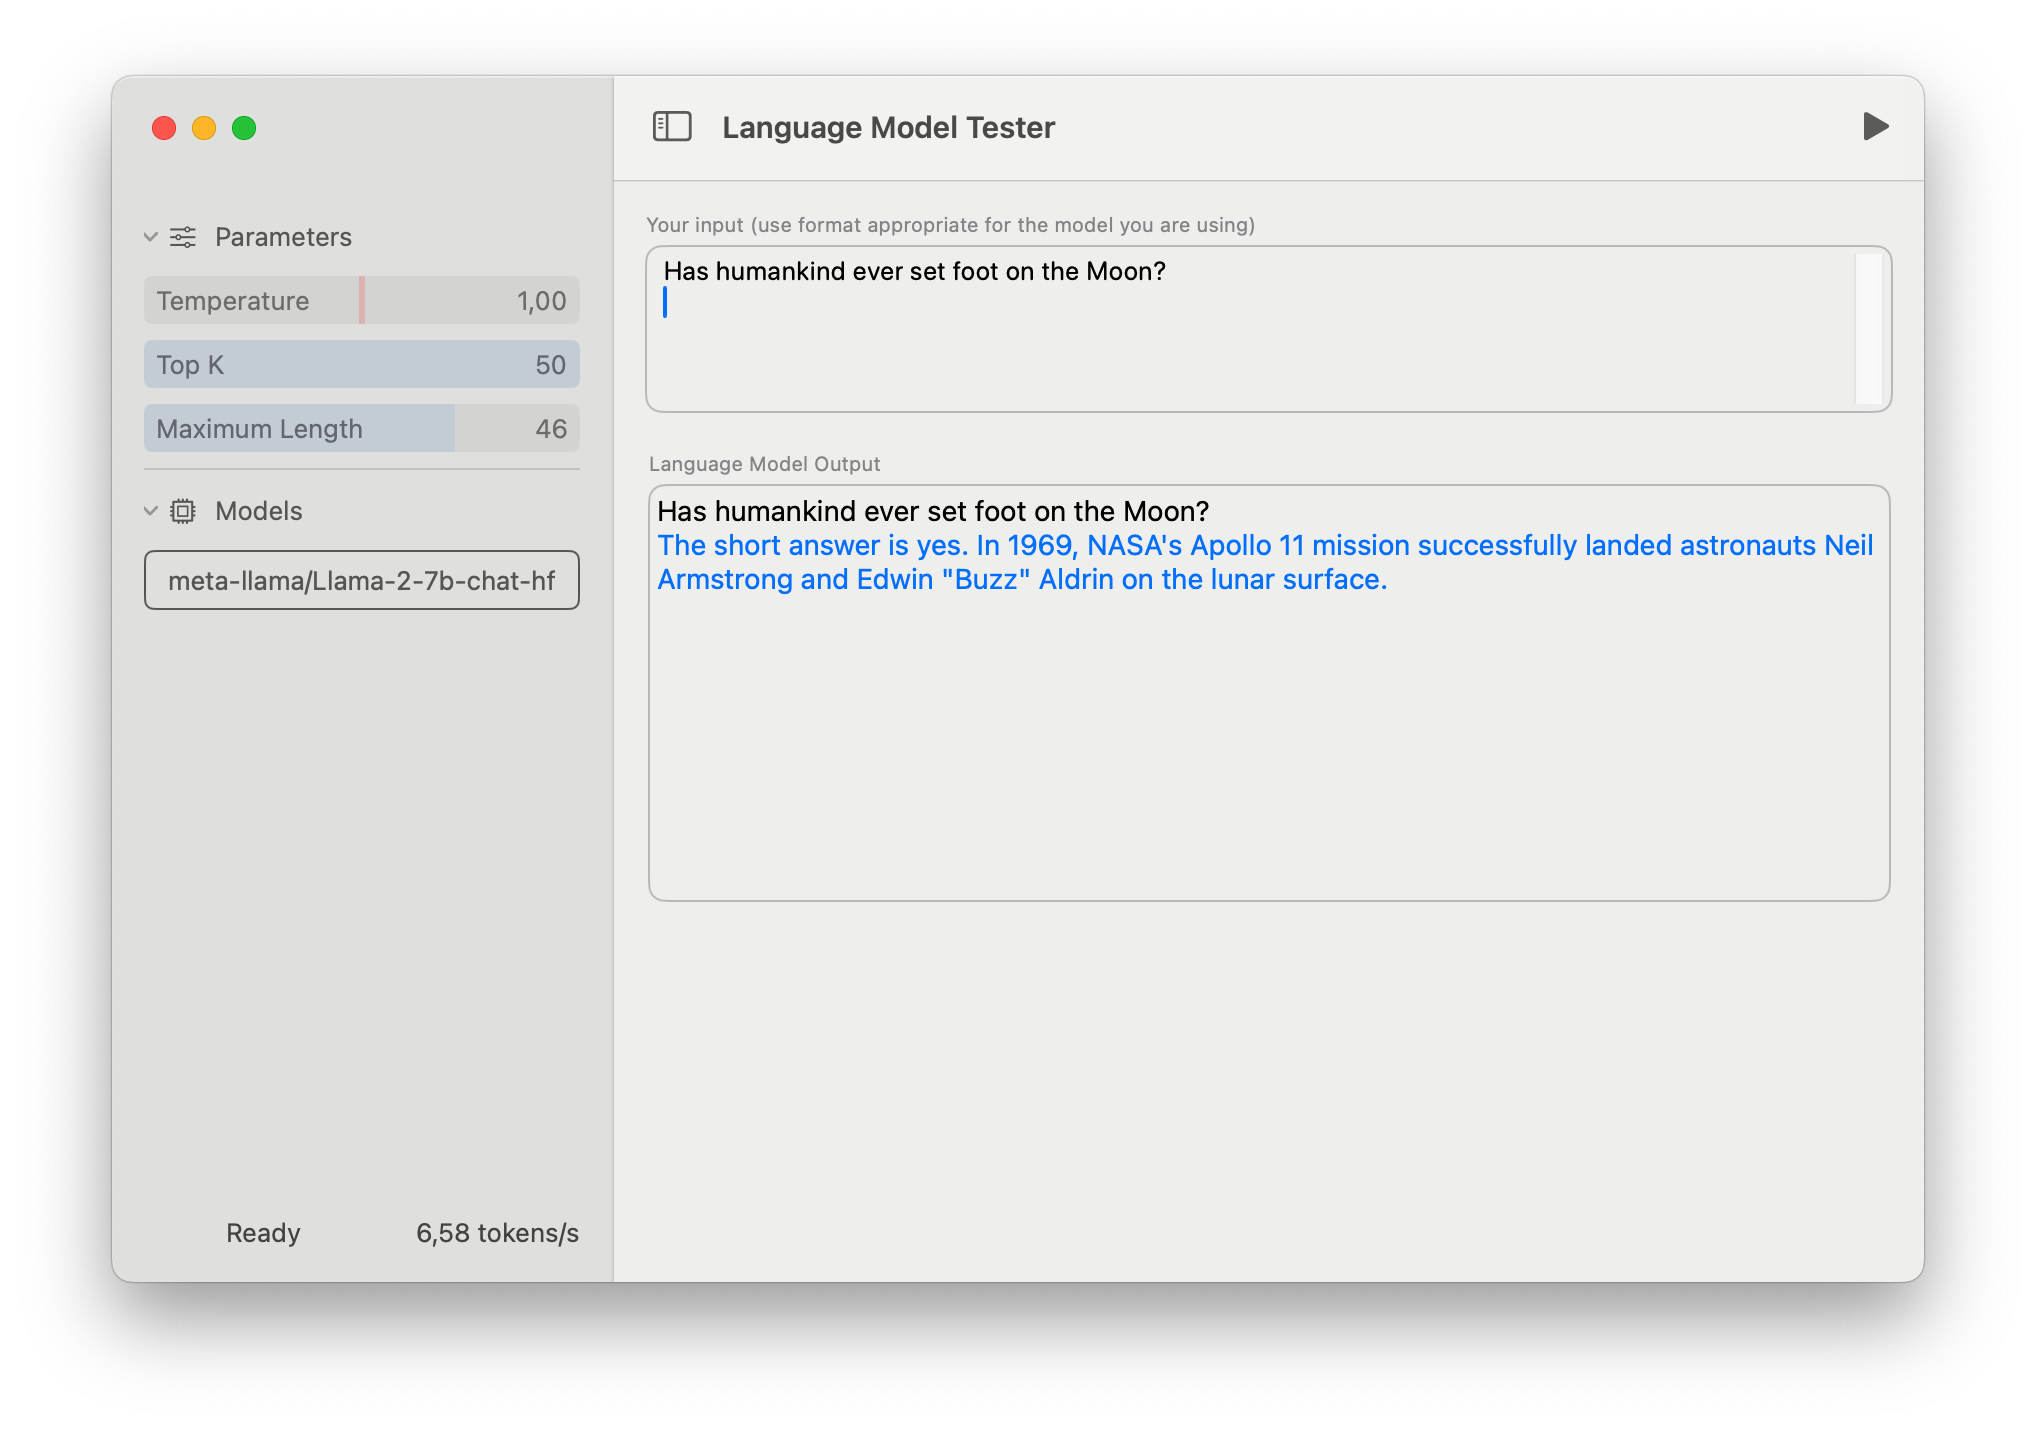
要使用它,请从 Hub 下载一个 Core ML 模型或创建你自己的模型,然后从 UI 中选择它。所有相关的模型配置文件都将从 Hub 下载,并使用元数据信息来识别这是什么模型类型。
第一次加载新模型时,准备它需要一些时间。在此阶段,CoreML 框架将编译模型,并根据你的机器规格和模型结构决定在哪些计算设备上运行它。此信息会被缓存,并在以后的运行中重复使用。
该应用刻意保持简单,以使其易读且简洁。它还缺少一些功能,主要是因为当前模型上下文大小的限制。例如,它没有任何用于“系统提示”的机制,而系统提示对于指定语言模型的行为乃至其个性很有用。
缺失部分 / 下一步计划
如前所述,我们才刚刚开始!我们接下来的优先事项包括:
- 编码器-解码器模型,例如 T5 和 Flan。
- 更多分词器:支持 Unigram 和 WordPiece。
- 更多生成算法。
- 支持键值缓存以进行优化。
- 使用离散序列形状进行转换。与键值缓存一起,这将允许更大的上下文。
让我们知道你认为我们接下来应该做什么,或者前往仓库查看适合新手的议题来一试身手!
结论
我们推出了一套工具,帮助 Swift 开发者将语言模型融入他们的应用中。我迫不及待想看到你们用它们创造出什么,也期待在社区的帮助下改进它们!欢迎随时联系我们 :)
附录:用硬办法转换 Llama 2
除非你遇到过 Core ML 转换问题并且准备好迎战 :),否则你可以放心忽略这一节。
根据我的经验,PyTorch 模型无法使用 coremltools 转换为 Core ML 通常有两个常见原因:
- 不支持的 PyTorch 算子或算子变体
PyTorch 有大量算子,它们都必须映射到一种中间表示(MIL,即模型中间语言),然后再转换为原生 Core ML 指令。PyTorch 的算子集合并非静态不变,因此新的算子也必须添加到 coremltools 中。此外,有些算子非常复杂,可以作用于其参数的各种奇特组合。最近新增的一个非常复杂的算子例子是 PyTorch 2 中引入的缩放点积注意力。一个部分支持的算子例子是 einsum:并非所有可能的方程都会被转换为 MIL。
- 边界情况和类型不匹配
即使对于受支持的 PyTorch 算子,也很难确保转换过程能在所有不同输入类型的所有可能输入上正常工作。请记住,单个 PyTorch 算子可能有多个后端实现,对应不同的设备(cpu、CUDA)、输入类型(整数、浮点数)或精度(float16、float32)。所有组合的乘积大得惊人,有时模型使用 PyTorch 代码的方式会触发一条可能从未被考虑或测试过的转换路径。
这就是我第一次尝试使用 coremltools 转换 Llama 2 时遇到的情况:
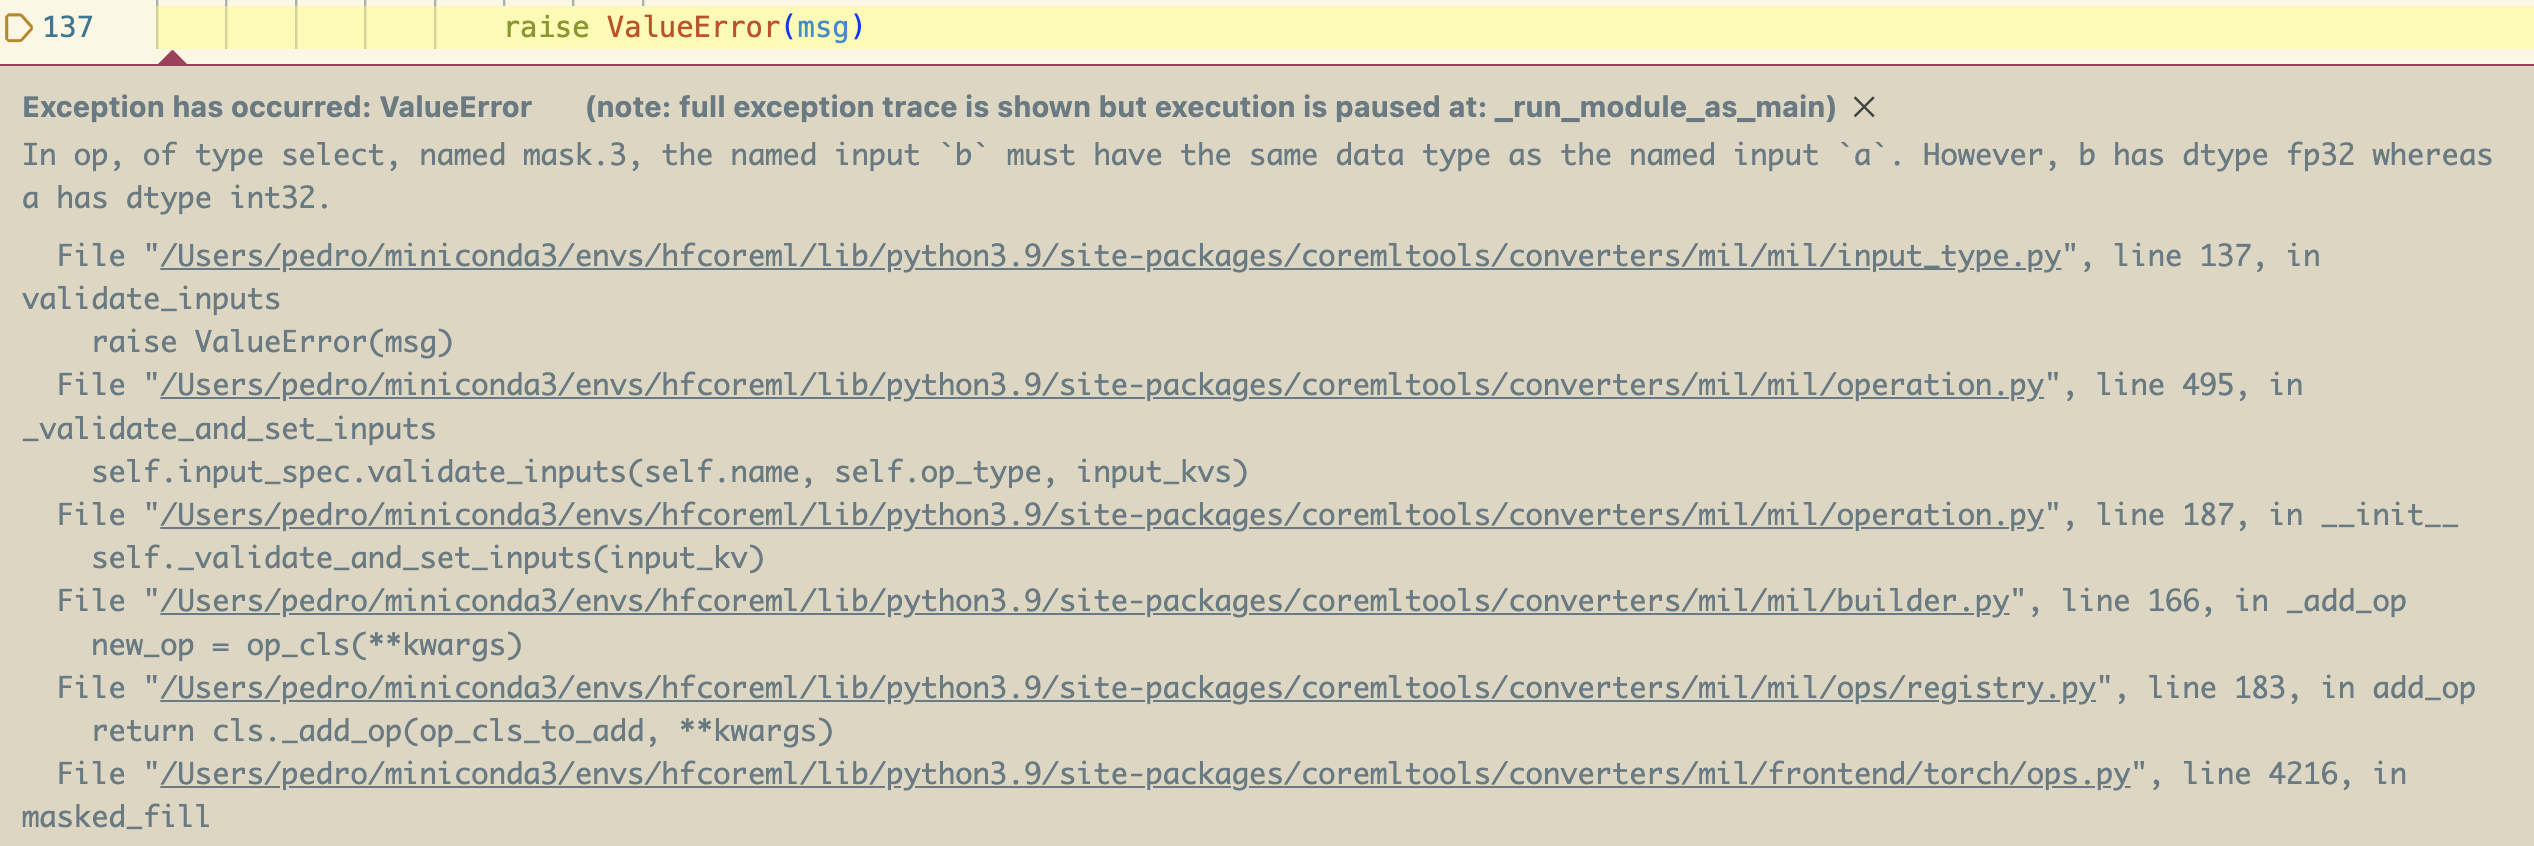
通过比较不同版本的 transformers,我可以看到问题是在这行代码被引入时开始出现的。它是最近一次 transformers 重构的一部分,目的是更好地处理所有使用因果掩码的模型中的因果掩码,所以这对其他模型来说也会是个大问题,而不仅仅是 Llama。
错误截图告诉我们的是,在尝试填充掩码张量时出现了类型不匹配。它来自这一行中的 0:它被解释为 int,但要填充的张量包含 floats,而使用不同的类型被转换过程拒绝了。在这个特定情况下,我为 coremltools 想出了一个补丁,但幸运的是这很少有必要。在很多情况下,你可以修补自己的代码(在 transformers 的本地副本中加一个 0.0 就能奏效),或者创建一个“特殊算子”来处理这种例外情况。我们的 exporters 库对自定义特殊算子有非常好的支持。关于缺失的 einsum 方程,请参见这个例子;关于让 StarCoder 模型在新版本 coremltools 发布之前能够工作的变通方法,请参见这个例子。
幸运的是,coremltools 对新算子的覆盖很好,而且团队反应非常快。
资源
swift-transformers。swift-chat。exporters。transformers-to-coreml。- Some Core ML models for text generation:
来源:Hugging Face:Blog(RSS) · huggingface.co