Hugging Face 如何让 LoRA 推理提速 300%
Goodbye cold boot - how we made LoRA Inference 300% faster
Hugging Face 在 Hub Inference API 中实现 LoRA 动态加载与卸载,保持 Stable Diffusion 等基座模型常驻,按请求切换 LoRA 适配器,将预热时间从 25s 降到 3s,用户请求响应时间从 35s 降到 13s。
作者亲述 Hub 推理优化的具体做法和实测数字,读者可以借鉴这套动态加载思路用于自己的部署。
简而言之:我们根据用户请求切换 Stable Diffusion LoRA 适配器,同时保持基础模型处于热状态,从而实现跨多个用户的快速 LoRA 推理。你可以通过浏览我们的 LoRA 目录 并使用推理小部件来体验这一点。

在这篇博客中,我们将详细探讨我们是如何实现这一点的。
我们成功大幅加速了 Hub 中基于公开 Diffusion 模型的公开 LoRA 的推理速度。这使我们能够节省计算资源,并提供更快、更好的用户体验。
要对给定模型执行推理,需要两个步骤:
- 预热阶段——包括下载模型和设置服务(25秒)。
- 然后是推理任务本身(10秒)。
通过改进,我们成功将预热时间从 25 秒缩短至 3 秒。现在,我们能够以不到 5 块 A10G GPU 为数百个不同的 LoRA 提供推理服务,同时用户请求的响应时间从 35 秒降至 13 秒。
让我们进一步探讨如何利用 Diffusers 库中最近开发的一些功能,以动态方式通过单一服务为众多不同的 LoRA 提供服务。
LoRA
LoRA 是一种微调技术,属于“参数高效”(PEFT)方法家族,这类方法试图减少微调过程中受影响的可训练参数数量。它提高了微调速度,同时减小了微调检查点的大小。
我们不是通过对模型所有权重进行微小修改来微调模型,而是冻结大部分层,仅训练注意力块中的少数特定层。此外,我们通过将两个较小矩阵的乘积加到原始权重上,避免改动这些层的参数。这些小矩阵的权重在微调过程中被更新,然后保存到磁盘。这意味着模型的所有原始参数都得以保留,我们可以使用适配方法在其上加载 LoRA 权重。
LoRA 名称(低秩适应)来源于我们提到的小矩阵。有关该方法的更多信息,请参阅这篇文章或原始论文。

上图显示了两个较小的橙色矩阵,它们作为 LoRA 适配器的一部分被保存。之后我们可以加载 LoRA 适配器并将其与蓝色基础模型合并,得到黄色的微调模型。至关重要的是,卸载适配器也是可行的,因此我们可以在任何时候恢复到原始基础模型。
换句话说,LoRA 适配器就像基础模型的附加组件,可以按需添加和移除。由于 A 和 B 的秩较小,与模型大小相比它非常轻量。因此,加载速度远快于加载整个基础模型。
例如,如果你查看Stable Diffusion XL Base 1.0 模型仓库,它被广泛用作许多 LoRA 适配器的基础模型,你可以看到其大小约为 7 GB。然而,像这个这样的典型 LoRA 适配器仅占用 24 MB 的空间!
Hub 上的蓝色基础模型远少于黄色模型。如果我们能快速地从蓝色模型切换到黄色模型,反之亦然,那么我们就找到了一种方法,仅用少数几个不同的蓝色部署来服务众多不同的黄色模型。
关于 LoRA 的详细介绍,请参阅以下博客文章:使用 LoRA 进行高效的 Stable Diffusion 微调,或直接参阅原始论文。
优势
Hub 上大约有 2500 个不同的公开 LoRA。其中绝大多数(约 92%)是基于 Stable Diffusion XL Base 1.0 模型的 LoRA。
在此次共享化之前,这意味着需要为所有这些模型部署专用服务(例如上图中所有黄色的合并矩阵);至少需要发布并预留一块新的 GPU。启动服务并使其准备好为特定模型处理请求大约需要 25 秒,此外还有推理时间(在 A10G 上以 25 个推理步数进行 1024x1024 的 SDXL 推理扩散大约需要 10 秒)。如果某个适配器只是偶尔被请求,其服务会被停止,以释放被其他服务抢占的资源。
如果你请求的是一个不太流行的 LoRA,即使它像目前 Hub 上绝大多数适配器一样基于 SDXL 模型,也需要 35 秒 来预热并在首次请求时获得响应(后续请求则只需推理时间,例如 10 秒)。
现在:请求时间已从 35 秒降至 13 秒,因为适配器只会使用少数几个不同的“蓝色”基础模型(例如 Diffusion 只有 2 个重要的基础模型)。即使你的适配器不太流行,它的“蓝色”服务也很可能已经预热完毕。换句话说,即使你不经常请求你的模型,也很有可能避免 25 秒的预热时间。蓝色模型已经下载并准备就绪,我们只需卸载之前的适配器并加载新的适配器,如下文所示,这需要 3 秒。
总体而言,服务所有不同模型所需的 GPU 更少了,尽管我们已经有办法在部署之间共享 GPU 以最大化其计算利用率。在 2 分钟 的时间范围内,大约有 10 个不同的 LoRA 权重被请求。我们不是启动 10 个部署并让它们保持预热,而是仅用 1 到 2 块 GPU 来服务所有这些请求(如果有请求突发则更多)。
实现
我们在 Inference API 中实现了 LoRA 共享化。当对我们的平台上可用的模型执行请求时,我们首先判断这是否是一个 LoRA。然后我们识别该 LoRA 的基础模型,并将请求路由到一个能够为该模型处理请求的公共后端集群。推理请求通过保持基础模型预热并动态加载/卸载 LoRA 来得到处理。这样,我们最终可以复用相同的计算资源来同时服务许多不同的模型。
LoRA 结构
在 Hub 中,LoRA 可以通过两个属性来识别:
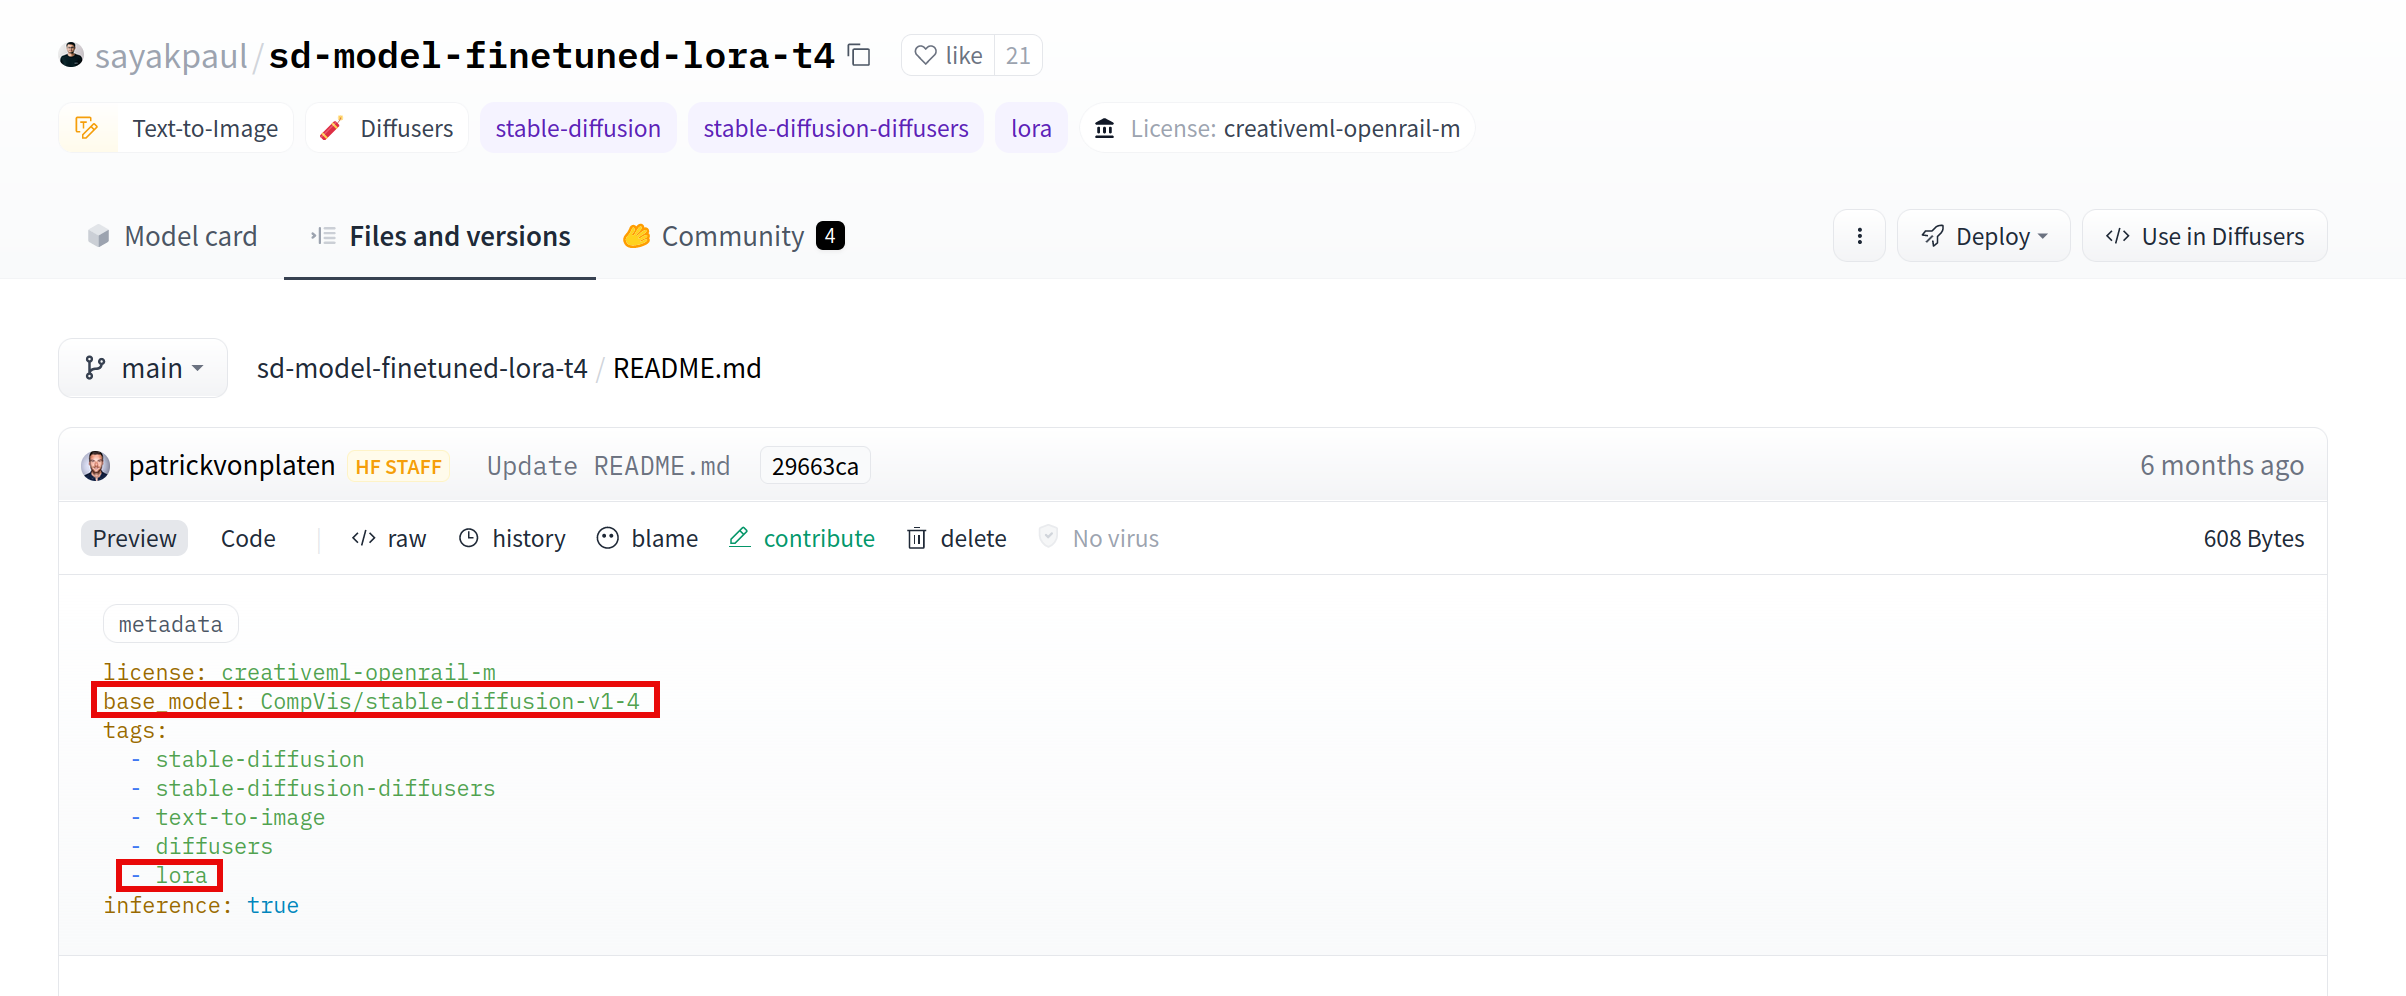
一个 LoRA 会有一个 base_model 属性。这仅仅是该 LoRA 所针对的模型,在执行推理时应将其应用于该模型。
由于 LoRA 并不是唯一具有此类属性的模型(任何重复的模型都会有一个),因此 LoRA 还需要一个 lora 标签才能被正确识别。
为 Diffusers 🧨 加载/卸载 LoRA
请注意,使用 peft 库有一种更无缝的方式来实现本节所展示的相同功能。请参阅文档了解更多详情。其原理与下文相同(从上方示意图中的蓝色框到黄色框,或反向操作)
Diffusers 库中使用 4 个函数来加载和卸载不同的 LoRA 权重:
load_lora_weights 和 fuse_lora 用于加载权重并与主层合并。请注意,在执行推理之前将权重与主模型合并可以将推理时间减少 30%。
unload_lora_weights 和 unfuse_lora 用于卸载。
下面我们提供一个示例,展示如何利用 Diffusers 库在基础模型之上快速加载多个 LoRA 权重:
import torch


from diffusers import (
    AutoencoderKL,
    DiffusionPipeline,
)

import time

base = "stabilityai/stable-diffusion-xl-base-1.0"

adapter1 = 'nerijs/pixel-art-xl'
weightname1 = 'pixel-art-xl.safetensors'

adapter2 = 'minimaxir/sdxl-wrong-lora'
weightname2 = None

inputs = "elephant"
kwargs = {}

if torch.cuda.is_available():
    kwargs["torch_dtype"] = torch.float16

start = time.time()

# Load VAE compatible with fp16 created by madebyollin
vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix",
    torch_dtype=torch.float16,
)
kwargs["vae"] = vae
kwargs["variant"] = "fp16"

model = DiffusionPipeline.from_pretrained(
    base, **kwargs
)

if torch.cuda.is_available():
    model.to("cuda")

elapsed = time.time() - start

print(f"Base model loaded, elapsed {elapsed:.2f} seconds")


def inference(adapter, weightname):
    start = time.time()
    model.load_lora_weights(adapter, weight_name=weightname)
    # Fusing lora weights with the main layers improves inference time by 30 % !
    model.fuse_lora()
    elapsed = time.time() - start

    print(f"LoRA adapter loaded and fused to main model, elapsed {elapsed:.2f} seconds")

    start = time.time()
    data = model(inputs, num_inference_steps=25).images[0]
    elapsed = time.time() - start
    print(f"Inference time, elapsed {elapsed:.2f} seconds")

    start = time.time()
    model.unfuse_lora()
    model.unload_lora_weights()
    elapsed = time.time() - start
    print(f"LoRA adapter unfused/unloaded from base model, elapsed {elapsed:.2f} seconds")


inference(adapter1, weightname1)
inference(adapter2, weightname2)
正在加载图表
以下所有数字均以秒为单位:
| GPU | T4 | A10G |
|---|---|---|
| 基础模型加载 - 未缓存 | 20 | 20 |
| 基础模型加载 - 已缓存 | 5.95 | 4.09 |
| 适配器 1 加载 | 3.07 | 3.46 |
| 适配器 1 卸载 | 0.52 | 0.28 |
| 适配器 2 加载 | 1.44 | 2.71 |
| 适配器 2 卸载 | 0.19 | 0.13 |
| 推理时间 | 20.7 | 8.5 |
每次推理额外增加 2 到 4 秒,我们就可以服务许多不同的 LoRA。然而,在 A10G GPU 上,推理时间大幅减少,而适配器加载时间变化不大,因此 LoRA 的加载/卸载相对更加昂贵。
服务请求
为了服务推理请求,我们使用这个开源社区镜像
你可以在 TextToImagePipeline 类中找到前面描述的机制。
当请求一个 LoRA 时,我们会查看当前已加载的那个,仅在需要时进行更换,然后照常执行推理。这样,我们就能够为基础模型和许多不同的适配器服务请求。
下面是一个示例,展示如何测试和请求此镜像:
$ git clone https://github.com/huggingface/api-inference-community.git

$ cd api-inference-community/docker_images/diffusers

$ docker build -t test:1.0 -f Dockerfile .

$ cat > /tmp/env_file <<'EOF'
MODEL_ID=stabilityai/stable-diffusion-xl-base-1.0
TASK=text-to-image
HF_XET_HIGH_PERFORMANCE=1
EOF

$ docker run --gpus all --rm --name test1 --env-file /tmp/env_file_minimal -p 8888:80 -it test:1.0
然后在另一个终端中向基础模型和/或 HF Hub 上的各种 LoRA 适配器发起请求。
# Request the base model
$ curl 0:8888 -d '{"inputs": "elephant", "parameters": {"num_inference_steps": 20}}' > /tmp/base.jpg

# Request one adapter
$ curl -H 'lora: minimaxir/sdxl-wrong-lora' 0:8888 -d '{"inputs": "elephant", "parameters": {"num_inference_steps": 20}}' > /tmp/adapter1.jpg

# Request another one
$ curl -H 'lora: nerijs/pixel-art-xl' 0:8888 -d '{"inputs": "elephant", "parameters": {"num_inference_steps": 20}}' > /tmp/adapter2.jpg
那批处理呢?
最近发表了一篇非常有趣的论文,描述了如何通过对 LoRA 模型执行批处理推理来提高吞吐量。简而言之,所有推理请求会被收集到一个批次中,与公共基础模型相关的计算会一次性完成,然后计算剩余的适配器特定乘积。我们没有实现这种技术(接近于 text-generation-inference 对 LLM 采用的方法)。相反,我们坚持使用单个顺序推理请求。原因是我们观察到批处理对 diffusers 并不有趣:吞吐量不会随批次大小显著增加。在我们执行的简单图像生成基准测试中,批次大小为 8 时吞吐量仅增加了 25%,代价是延迟增加了 6 倍!相比之下,批处理对 LLM 来说有趣得多,因为你可以获得 8 倍的顺序吞吐量,而延迟仅增加 10%。这就是我们没有为 diffusers 实现批处理的原因。
结论:时间!
使用动态 LoRA 加载,我们能够节省计算资源并改善 Hub Inference API 中的用户体验。尽管卸载先前加载的适配器并加载我们感兴趣的适配器这一过程会增加额外时间,但服务进程通常已经启动并运行,这使得整体推理时间响应大大缩短。
请注意,要让 LoRA 在 Hub 上受益于这一推理优化,它必须同时是公开的、非门控的,并且基于一个非门控的公开模型。如果你将同样的方法应用到你的部署中,请务必告诉我们!
来源:Hugging Face:Blog(RSS) · huggingface.co