Apple 与 Hugging Face 发布 Stable Diffusion XL 的 Core ML 版本及混合位宽压缩方法
Stable Diffusion XL on Mac with Advanced Core ML Quantization
Apple 与 Hugging Face 将 Stable Diffusion XL 移植到 Core ML,并发布混合位宽调色板压缩方法,UNet 从 4.8 GB 压缩到 1.4 GB(71% 缩减),平均等效 4.5 bits 每参数。
Apple 与 Hugging Face 联合给出混合位宽调色板压缩方法,UNet 从 4.8 GB 降到 1.4 GB,方法可迁移到其他模型。
Stable Diffusion XL 昨天发布了,非常棒。它可以生成大尺寸(1024x1024)的高质量图像;通过一些新技巧,对提示词的遵循度得到了提升;得益于噪声调度器的最新研究,它可以轻松生成非常暗或非常亮的图像;而且它是开源的!
缺点是模型大得多,因此在消费级硬件上运行更慢、更困难。使用 Hugging Face diffusers 库的最新版本,你可以在 16 GB GPU 显存的 CUDA 硬件上运行 Stable Diffusion XL,从而可以在 Colab 的免费套餐上使用它。
过去几个月表明,人们显然非常有兴趣在本地运行机器学习模型,原因多种多样,包括隐私、便利、更轻松的实验或不受限的使用。我们一直在 Apple 和 Hugging Face 努力探索这一领域。我们展示了如何在 Apple Silicon 上运行 Stable Diffusion,或者如何利用 Core ML 的最新进展,通过 6 位调色板化来改进大小和性能。
对于 Stable Diffusion XL,我们做了几件事:
- 将基础模型移植到 Core ML,以便你可以在原生 Swift 应用中使用它。
- 更新了 Apple 的转换和推理仓库,以便你可以自行转换模型,包括你感兴趣的任何微调模型。
- 更新了 Hugging Face 的演示应用,以展示如何使用从 Hub 下载的新 Core ML Stable Diffusion XL 模型。
- 探索了混合位调色板化,这是一种先进的压缩技术,可在实现显著尺寸缩减的同时,最大限度地减少并控制质量损失。你也可以将同样的技术应用于你自己的模型!
一切都是开源的,今天即可使用,让我们开始吧。
目录
从 Hugging Face Hub 使用 SD XL 模型
作为本次发布的一部分,我们在 Core ML 中发布了两个不同版本的 Stable Diffusion XL。
apple/coreml-stable-diffusion-xl-base是一个完整的流水线,没有任何量化。apple/coreml-stable-diffusion-mixed-bit-palettization包含(除其他产物外)一个完整的流水线,其中 UNet 已被替换为混合位调色板化配方,实现了相当于每个参数 4.5 位的压缩。大小从 4.8 GB 降至 1.4 GB,减少了 71%,我们认为质量仍然很棒。
这两种模型都可以使用 Apple 的 Swift 命令行推理应用或 Hugging Face 的 演示应用进行测试。以下是后者使用新的 Stable Diffusion XL 流水线的示例:
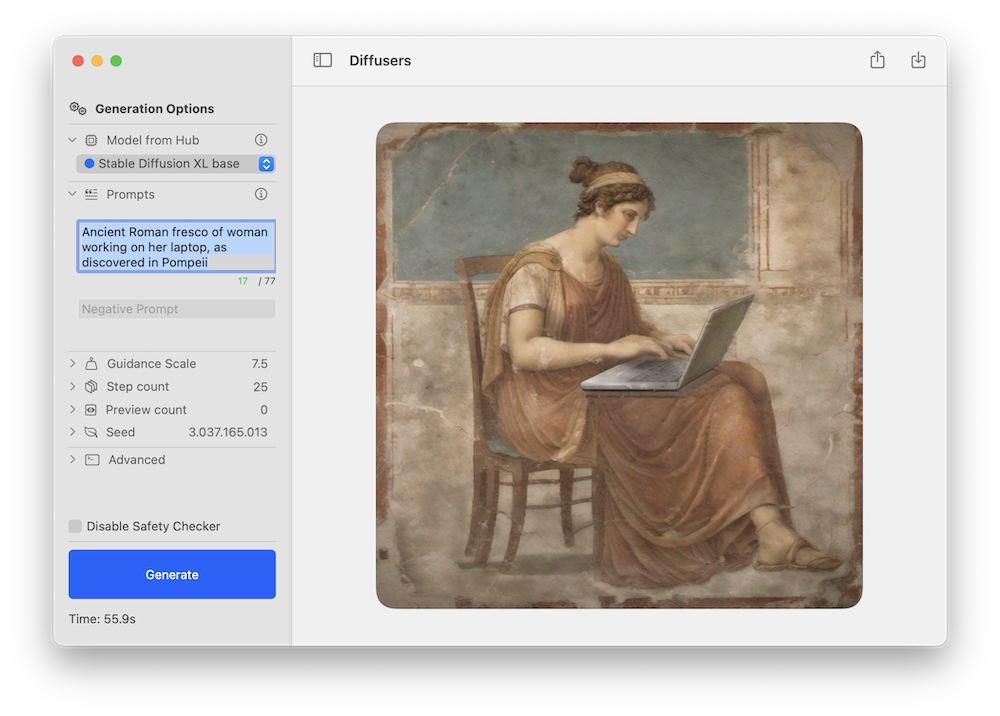
与之前的 Stable Diffusion 版本一样,我们预计社区会针对不同领域推出新颖的微调版本,其中许多将被转换为 Core ML。你可以关注 Hub 中的这个筛选器来探索!
Stable Diffusion XL 可在运行 macOS 14 公开测试版的 Apple Silicon Mac 上运行。它目前使用 ORIGINAL 注意力实现,适用于 CPU + GPU 计算单元。请注意,精炼阶段尚未移植。
作为参考,这些是我们在不同设备上实现的性能数据:
| 设备 | --compute-unit |
--attention-implementation |
端到端延迟(秒) | 扩散速度(迭代/秒) |
|---|---|---|---|---|
| MacBook Pro (M1 Max) | CPU_AND_GPU |
ORIGINAL |
46 | 0.46 |
| MacBook Pro (M2 Max) | CPU_AND_GPU |
ORIGINAL |
37 | 0.57 |
| Mac Studio (M1 Ultra) | CPU_AND_GPU |
ORIGINAL |
25 | 0.89 |
| Mac Studio (M2 Ultra) | CPU_AND_GPU |
ORIGINAL |
20 | 1.11 |
什么是混合位调色板化?
上个月我们讨论了 6 位调色板化,这是一种训练后量化方法,可将 16 位权重转换为每个参数仅 6 位。这实现了模型大小的重要缩减,但更进一步则很棘手,因为随着位数减少,模型质量受到的影响会越来越大。
进一步减小模型大小的一种选择是使用训练时量化,即在微调模型的同时学习量化表。这种方法效果很好,但你需要为每个想要转换的模型运行一个微调阶段。
我们探索了另一种替代方案:混合位调色板化。我们不是对每个参数使用 6 位,而是检查模型并决定每一层使用多少量化位。我们根据每一层对整体质量下降的贡献程度来做出决定,我们通过在 float16 模式下,针对一组少量输入,比较量化模型与原始模型之间的 PSNR 来衡量。我们逐层探索了几种位深:1(!)、2、4 和 8。如果某一层在使用比如 2 位时质量显著下降,我们就改用 4,依此类推。如果某些层对保持质量至关重要,则可能保留为 16 位模式。
使用这种方法,我们可以实现有效的量化,例如平均 2.8 位,并且我们会测量所尝试的每种组合对质量下降的影响。这使我们能够更好地了解针对目标质量和大小预算应使用的最佳量化方案。
为了说明该方法,让我们考虑以下从我们某次分析运行中得到的量化“配方”(稍后我们会解释它们是如何生成的):
{
  "model_version": "stabilityai/stable-diffusion-xl-base-1.0",
  "baselines": {
    "original": 82.2,
    "linear_8bit": 66.025,
    "recipe_6.55_bit_mixedpalette": 79.9,
    "recipe_4.50_bit_mixedpalette": 75.8,
    "recipe_3.41_bit_mixedpalette": 71.7,
  },
}
这告诉我们,原始模型质量以 float16 下的 PSNR 衡量约为 82 dB。执行朴素的 8 位线性量化会将其降至 66 dB。但随后我们有一个配方,平均每个参数压缩到 6.55 位,同时将 PSNR 保持在 80 dB。第二个和第三个配方进一步减小了模型大小,同时仍保持高于 8 位线性量化的 PSNR。
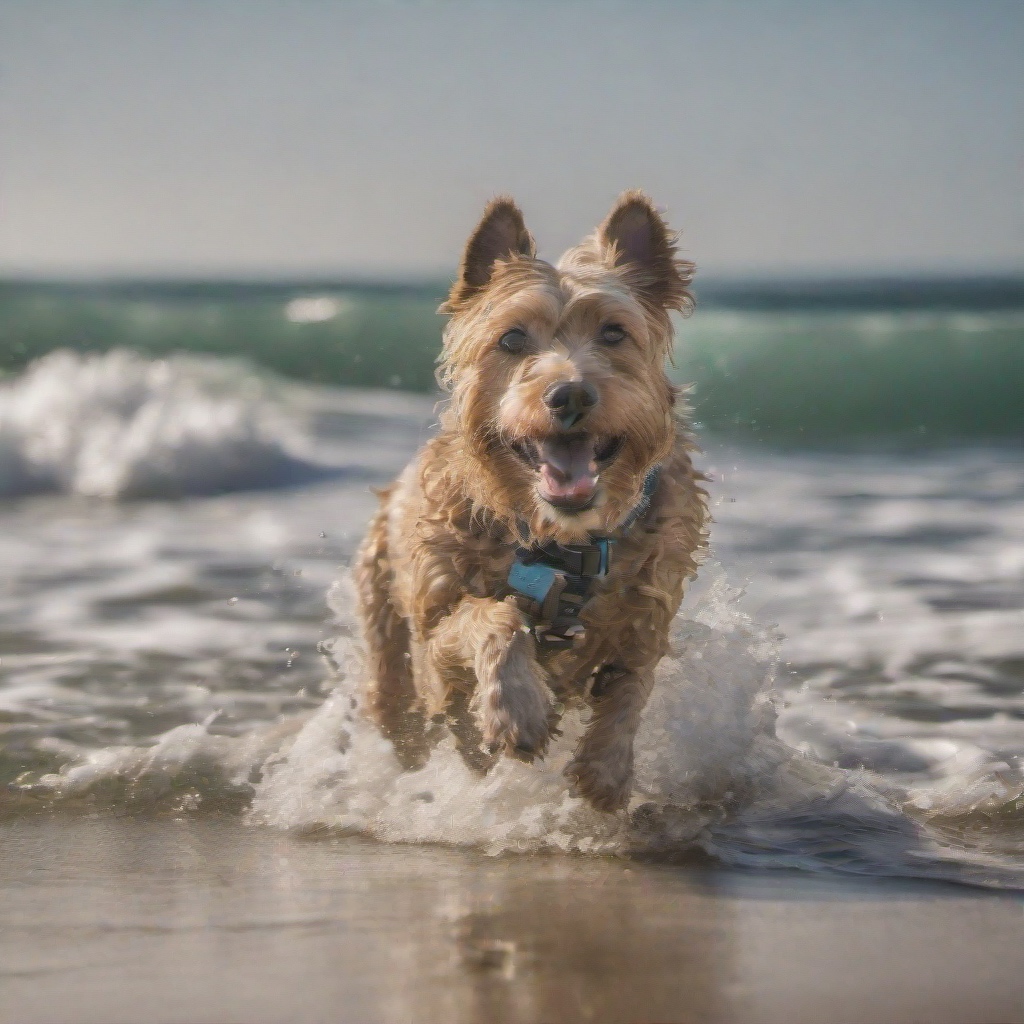
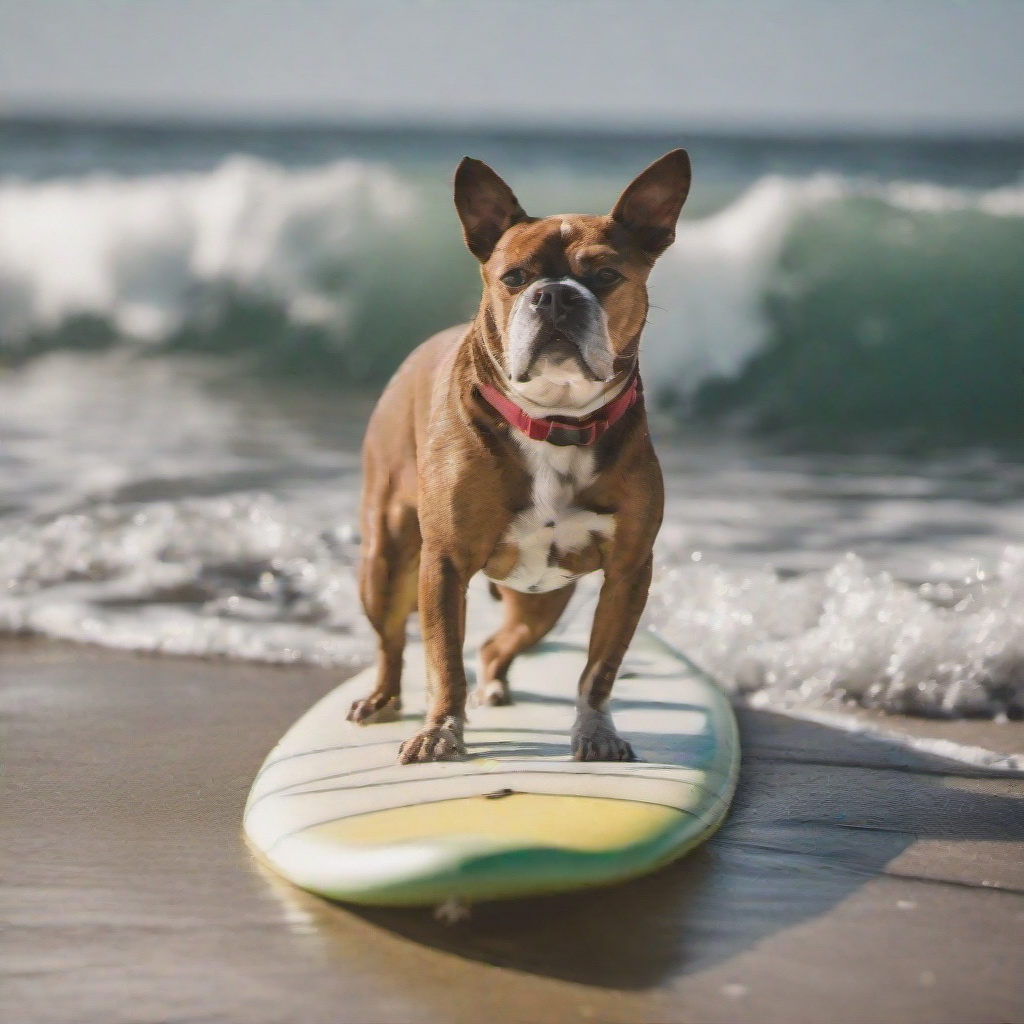
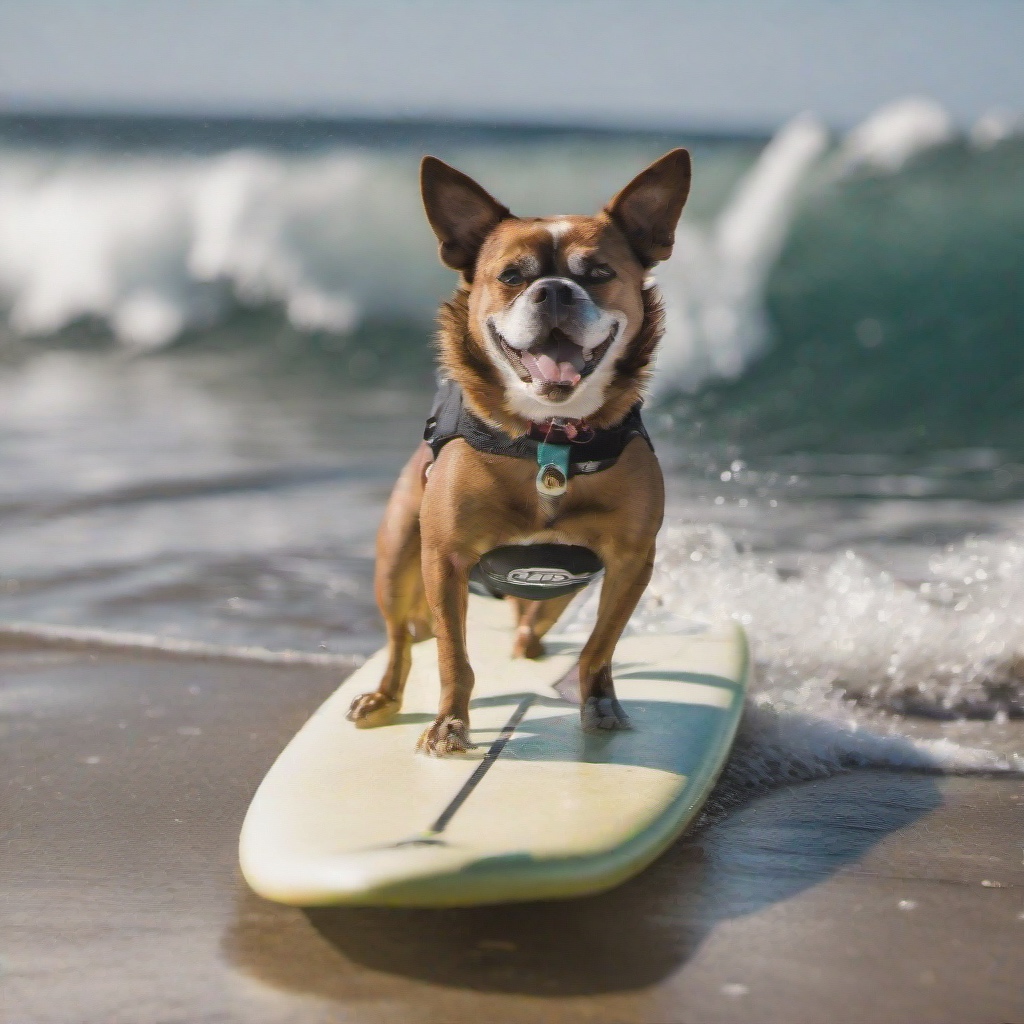
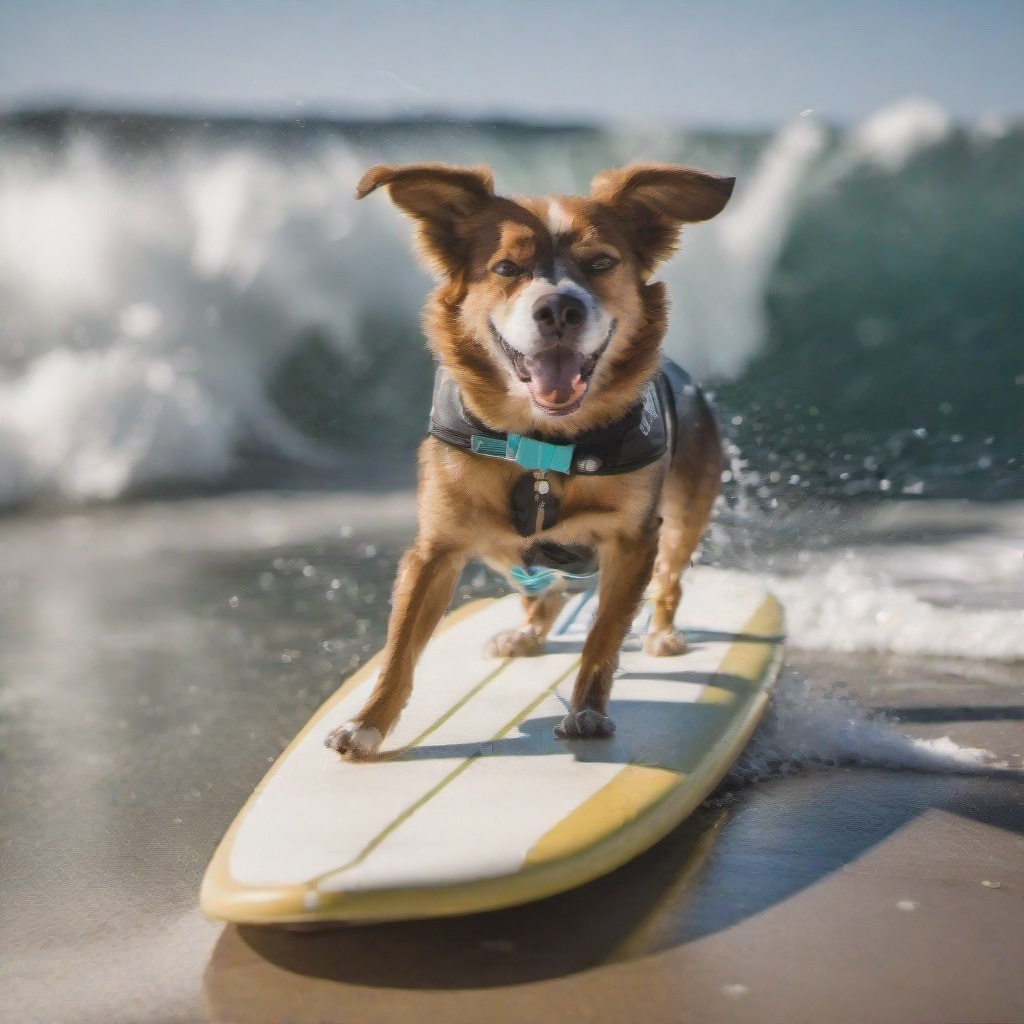
作为视觉示例,这些是在提示 a high quality photo of a surfing dog 上使用相同种子运行三个配方中的每一个所得到的结果:
| 3.41 位 | 4.50 位 | 6.55 位 | 16 位(原始) |
|---|---|---|---|
 |
 |
 |
 |
一些初步结论:
- 在我们看来,所有图像在真实感方面都具有良好的质量。6.55 和 4.50 版本在这方面接近 16 位版本。
- 相同的种子会产生等效的构图,但不会保留相同的细节。例如,狗的品种可能会不同。
- 随着压缩的增加,对提示的遵循程度可能会下降。在此示例中,激进的 3.41 版本丢失了冲浪板。PSNR 只比较整体像素差异,而不关心图像中的主体。你需要检查结果并根据你的用例进行评估。
这项技术非常适合 Stable Diffusion XL,因为即使参数数量相对于上一版本增加了两倍,我们也能保持大致相同的 UNet 大小。但它并非仅限于此!你可以将该方法应用于任何 Stable Diffusion Core ML 模型。
混合位配方是如何创建的?
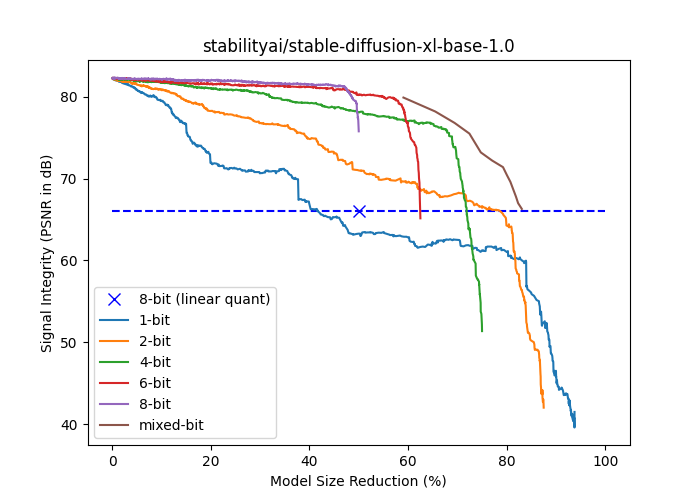
下图展示了 stabilityai/stable-diffusion-xl-base-1.0 的信号强度(PSNR,单位 dB)与模型大小缩减(占 float16 大小的百分比)之间的关系。{1,2,4,6,8} 位曲线是通过使用固定位数的调色板逐步对更多层进行调色板化生成的。各层按其单独对端到端信号强度的影响升序排列,因此累积压缩的影响被尽可能延迟。混合位曲线基于以下策略:一旦某层对端到端信号完整性的单独影响降至阈值以下,就回退到更高的位数。请注意,除 1 位外,所有基于调色板化的曲线在相同模型大小下均优于线性 8 位量化。
混合位调色板化分两个阶段运行:分析和应用。
分析阶段的目标是找到混合位曲线(图中位于所有其他曲线之上的棕色曲线)上的点,以便我们选择所需的质量与大小权衡。如前一节所述,我们遍历各层,选择能产生高于给定 PSNR 阈值结果的最低位深。我们对不同阈值重复该过程,以获得不同的量化策略。因此,该过程的结果是一组量化配方,其中每个配方只是一个 JSON 字典,详细说明模型中每一层要使用的位数。参数较少的层被忽略并保持为 float16 以简化处理。
应用阶段只是遍历配方,并按照 JSON 结构中指定的位数应用调色板化。
分析是一个耗时的过程,需要 GPU(mps 或 cuda),因为我们必须多次运行推理。一旦完成,配方应用可以在几分钟内完成。
我们为每个阶段都提供了脚本:
转换微调模型
如果你之前已将 Stable Diffusion 模型转换为 Core ML,那么使用 命令行转换器处理 XL 的过程非常相似。有一个新标志用于指示模型是否属于 XL 系列,如果是,则必须使用 --attention-implementation ORIGINAL。
有关该过程的介绍,请查看 仓库中的说明或我们之前的博客文章之一,并确保使用上述标志。
运行混合位调色板化
将 Stable Diffusion 或 Stable Diffusion XL 模型转换为 Core ML 后,你可以选择使用上述脚本应用混合位调色板化。
由于分析过程较慢,我们为最流行的模型准备了配方:
你可以在本地下载并应用它们进行实验。
此外,我们还将 Stable Diffusion XL 分析中最好的三个配方应用于 Core ML 版本的 UNet,并发布在此处。欢迎试用它们,看看效果如何!
最后,如引言所述,我们创建了一个完整的 Stable Diffusion XL Core ML 流水线,它使用 4.5-bit 配方。
已发布资源
apple/ml-stable-diffusion,由 Apple 提供。用于 Swift(和 Python)的转换与推理库。huggingface/swift-coreml-diffusers。Hugging Face 演示应用,构建于 Apple 的软件包之上。- Stable Diffusion XL 1.0 base(Core ML 版本)。模型已准备好使用上述仓库和其他第三方应用运行。
- Stable Diffusion XL 1.0 base,采用混合位调色板化(Core ML)。与上述模型相同,UNet 经过量化,有效调色板化平均为 4.5 位。
- 额外的混合位调色板化 UNet。
- 混合位调色板化配方,为流行模型预先计算并可直接使用。
mixed_bit_compression_pre_analysis.py。用于运行混合位分析和配方生成的脚本。mixed_bit_compression_apply.py。用于应用分析阶段计算出的配方的脚本。
来源:Hugging Face:Blog(RSS) · huggingface.co