🤗 Transformers 推出约束束搜索(Constrained Beam Search)功能
Guiding Text Generation with Constrained Beam Search in 🤗 Transformers
Hugging Face 在 Transformers 中推出约束束搜索功能,通过 model.generate() 的 force_words_ids 参数让用户强制生成结果包含指定词语或短语。
作者以翻译和 GPT-2 示例演示 force_words_ids 用法,并解释 banks 轮询机制如何在满足约束与生成通顺文本间取得平衡。

简介
本博客文章假设读者熟悉使用不同变体的束搜索进行文本生成的方法,如博客文章:“如何生成文本:使用不同的解码方法进行语言生成与Transformers”中所述。
与普通束搜索不同,受约束的束搜索允许我们对文本生成的输出施加控制。这很有用,因为我们有时确切知道输出中想要什么。例如,在神经机器翻译任务中,我们可能通过字典查找知道最终翻译中必须包含哪些词。有时,对于语言模型来说几乎同样可能的生成输出,由于特定上下文,对最终用户来说可能并不同样可取。这两种情况都可以通过允许用户告诉模型最终输出中必须包含哪些词来解决。
为什么困难
然而,这实际上是一个非常不平凡的问题。这是因为该任务要求我们在生成过程中的某个时刻,在最终输出的某个位置强制生成某些子序列。
假设我们想要生成一个句子S,它必须包含短语p1={t1,t2} p_1=\{ t_1, t_2 \} ,其中标记t1,t2 t_1, t_2 按顺序出现。让我们定义期望的句子S S 为:
Sexpected={s1,s2,...,sk,t1,t2,sk+1,...,sn} S_{expected} = \{ s_1, s_2, ..., s_k, t_1, t_2, s_{k+1}, ..., s_n \}
问题在于束搜索是逐个标记生成序列的。虽然不完全准确,但可以将束搜索视为函数B(s0:i)=si+1 B(\mathbf{s}_{0:i}) = s_{i+1} ,它查看从0 0 到i i 当前生成的标记序列,然后预测i+1 i+1 处的下一个标记。但这个函数如何在任意步骤i<k i < k 知道这些标记必须在未来某个步骤k k 生成?或者当它处于步骤i=k i=k 时,它如何确定这是强制这些标记的最佳位置,而不是未来某个步骤i>k i>k ?
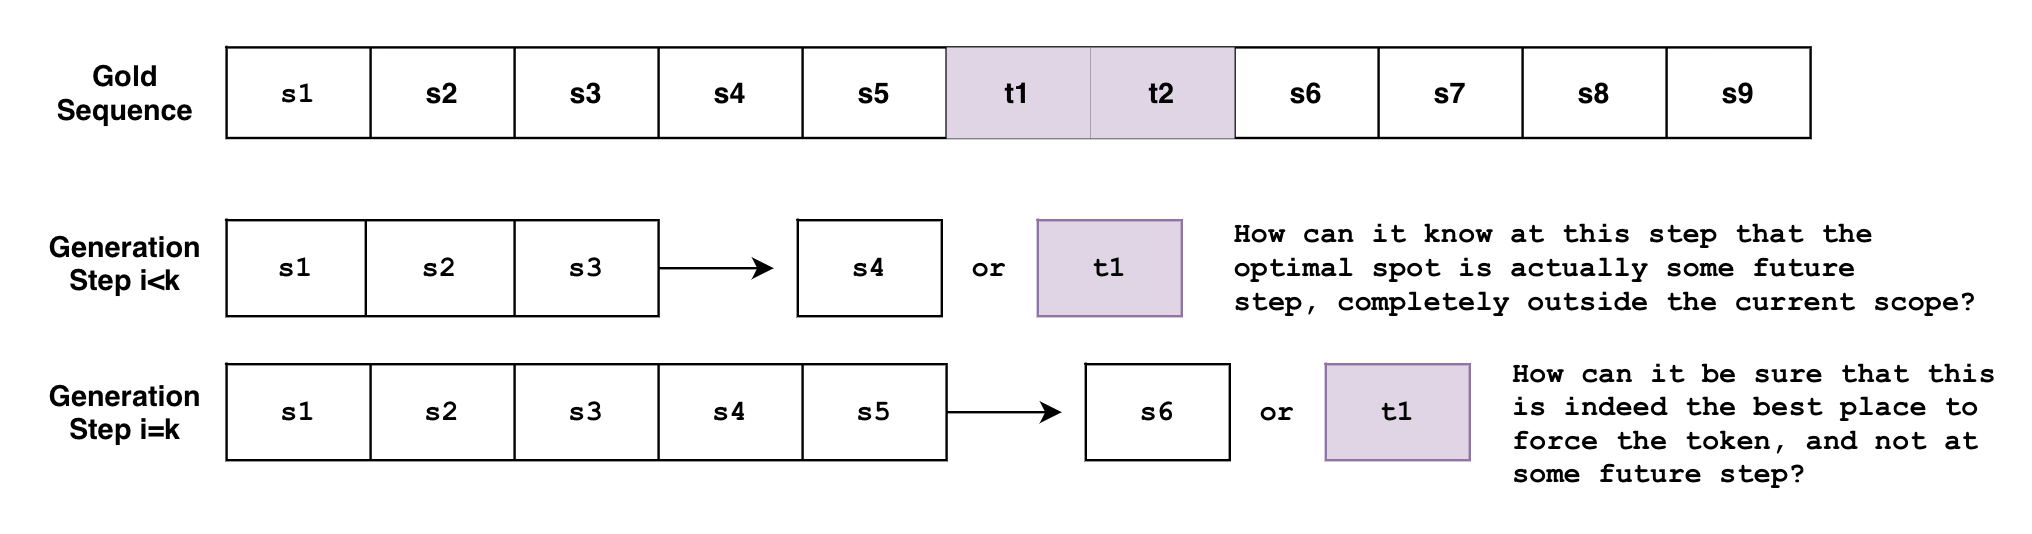
如果你有多个具有不同要求的约束呢?如果你想强制短语p1={t1,t2} p_1=\{t_1, t_2\} 以及短语p2={t3,t4,t5,t6} p_2=\{ t_3, t_4, t_5, t_6\} 呢?如果你想让模型在两个短语之间选择呢?如果我们想强制短语p1 p_1 ,并且只强制短语列表{p21,p22,p23} \{p_{21}, p_{22}, p_{23}\} 中的一个短语呢?
上述例子实际上是非常合理的用例,如下所示,新的受约束束搜索功能支持所有这些用例!
本文将快速介绍新的受约束束搜索功能能为你做什么,然后深入探讨其内部工作原理。
示例1:强制一个词
假设我们试图将"How old are you?"翻译成德语。
"Wie alt bist du?" 是在非正式场合会说的话,而 "Wie alt sind Sie?" 是在正式场合会说的话。
根据上下文,我们可能想要一种正式形式而非另一种,但我们如何告诉模型这一点呢?
传统束搜索
以下是我们如何在传统束搜索设置中进行文本翻译的方法。
!pip install -q git+https://github.com/huggingface/transformers.git
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM

tokenizer = AutoTokenizer.from_pretrained("t5-base")
model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")

encoder_input_str = "translate English to German: How old are you?"

input_ids = tokenizer(encoder_input_str, return_tensors="pt").input_ids

outputs = model.generate(
    input_ids,
    num_beams=10,
    num_return_sequences=1,
    no_repeat_ngram_size=1,
    remove_invalid_values=True,
)

print("Output:\n" + 100 * '-')
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Output:
----------------------------------------------------------------------------------------------------
Wie alt bist du?
使用约束束搜索
但如果我们知道我们想要一个正式的输出而不是非正式的呢?如果我们从先验知识中知道生成必须包含什么,并且我们可以将其注入到生成中呢?
以下是现在通过 model.generate() 的 force_words_ids 关键字参数可以实现的功能:
tokenizer = AutoTokenizer.from_pretrained("t5-base")
model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")

encoder_input_str = "translate English to German: How old are you?"

force_words = ["Sie"]

input_ids = tokenizer(encoder_input_str, return_tensors="pt").input_ids
force_words_ids = tokenizer(force_words, add_special_tokens=False).input_ids

outputs = model.generate(
    input_ids,
    force_words_ids=force_words_ids,
    num_beams=5,
    num_return_sequences=1,
    no_repeat_ngram_size=1,
    remove_invalid_values=True,
)


print("Output:\n" + 100 * '-')
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Output:
----------------------------------------------------------------------------------------------------
Wie alt sind Sie?
如你所见,我们能够利用关于期望输出的先验知识来引导生成。以前我们不得不生成一堆可能的输出,然后筛选出符合我们要求的那些。现在我们可以在生成阶段就做到这一点。
示例 2:析取约束
我们在上面提到了一个用例,即我们知道希望最终输出中包含哪些词。一个例子可能是在神经机器翻译过程中使用词典查找。
但如果我们不知道要使用哪些词形,而希望像 ["raining", "rained", "rains", ...] 这样的输出同样可能呢?更一般地说,总有一些情况我们不想要逐字逐句的精确词语,也可能对其他相关的可能性持开放态度。
允许这种行为的约束是析取约束,它允许用户输入一个单词列表,其目的是引导生成,使得最终输出必须包含该单词列表中的至少一个。
以下是一个混合使用上述两种约束类型的示例:
from transformers import GPT2LMHeadModel, GPT2Tokenizer

model = GPT2LMHeadModel.from_pretrained("gpt2")
tokenizer = GPT2Tokenizer.from_pretrained("gpt2")

force_word = "scared"
force_flexible = ["scream", "screams", "screaming", "screamed"]

force_words_ids = [
    tokenizer([force_word], add_prefix_space=True, add_special_tokens=False).input_ids,
    tokenizer(force_flexible, add_prefix_space=True, add_special_tokens=False).input_ids,
]

starting_text = ["The soldiers", "The child"]

input_ids = tokenizer(starting_text, return_tensors="pt").input_ids

outputs = model.generate(
    input_ids,
    force_words_ids=force_words_ids,
    num_beams=10,
    num_return_sequences=1,
    no_repeat_ngram_size=1,
    remove_invalid_values=True,
)


print("Output:\n" + 100 * '-')
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
print(tokenizer.decode(outputs[1], skip_special_tokens=True))
Setting `pad_token_id` to `eos_token_id`:50256 for open-end generation.


Output:
----------------------------------------------------------------------------------------------------
The soldiers, who were all scared and screaming at each other as they tried to get out of the
The child was taken to a local hospital where she screamed and scared for her life, police said.
如你所见,第一个输出使用了 "screaming",第二个输出使用了 "screamed",两者都逐字使用了 "scared"。可供选择的列表 ["screaming", "screamed", ...] 不必是词形;这可以满足任何我们需要从单词列表中只选一个的用例。
传统束搜索
以下是传统束搜索的一个示例,取自之前的博客文章:
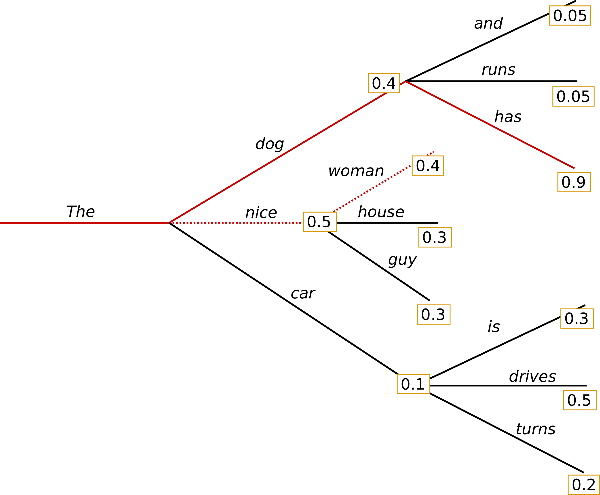
与贪婪搜索不同,束搜索通过保留更长的假设列表来工作。在上图中,我们在生成的每个可能步骤显示了三个下一个可能的词元。
以下是针对上述示例中束搜索第一步的另一种查看方式,在 num_beams=3 的情况下:
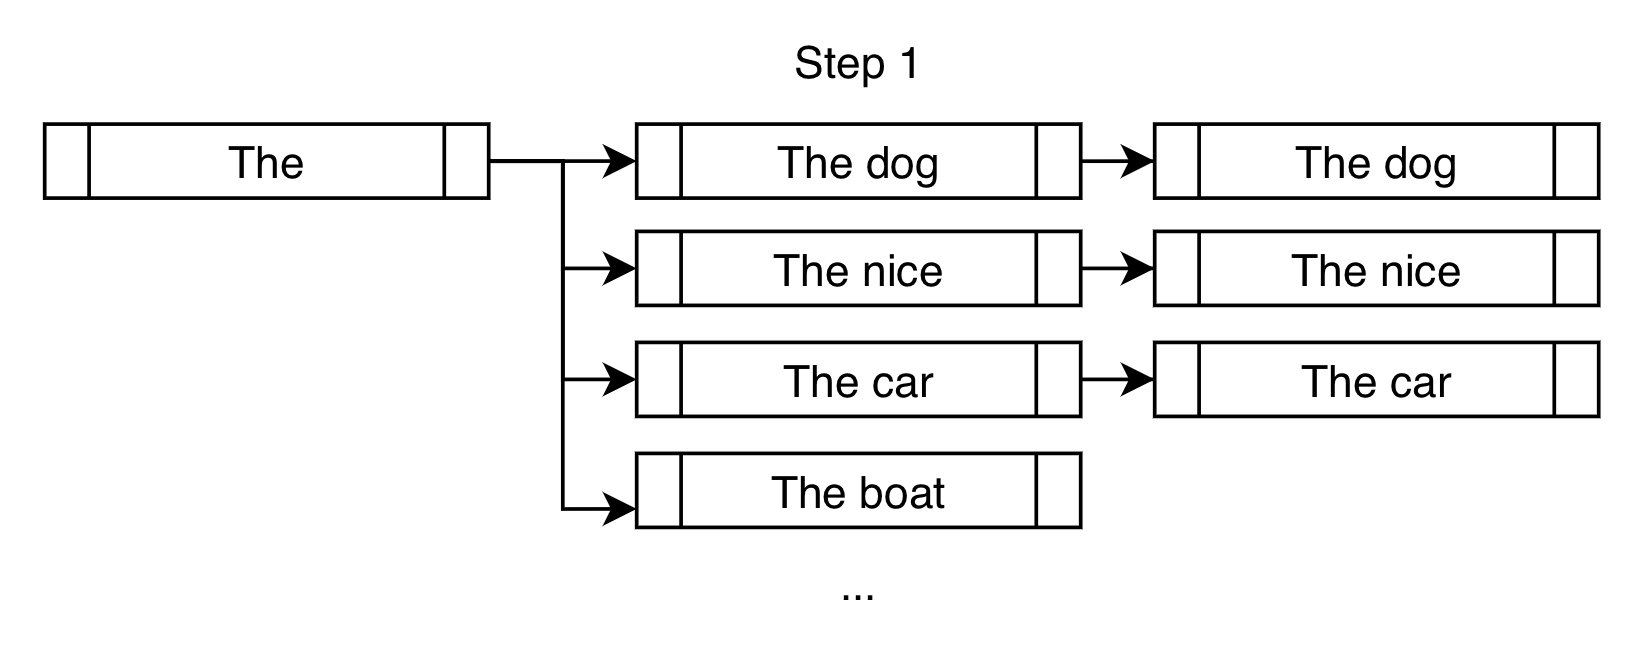
束搜索不是像贪婪搜索那样只选择 "The dog",而是允许进一步考虑 "The nice" 和 "The car"。
在下一步中,我们考虑上一步创建的三个分支各自的下一个可能词元。
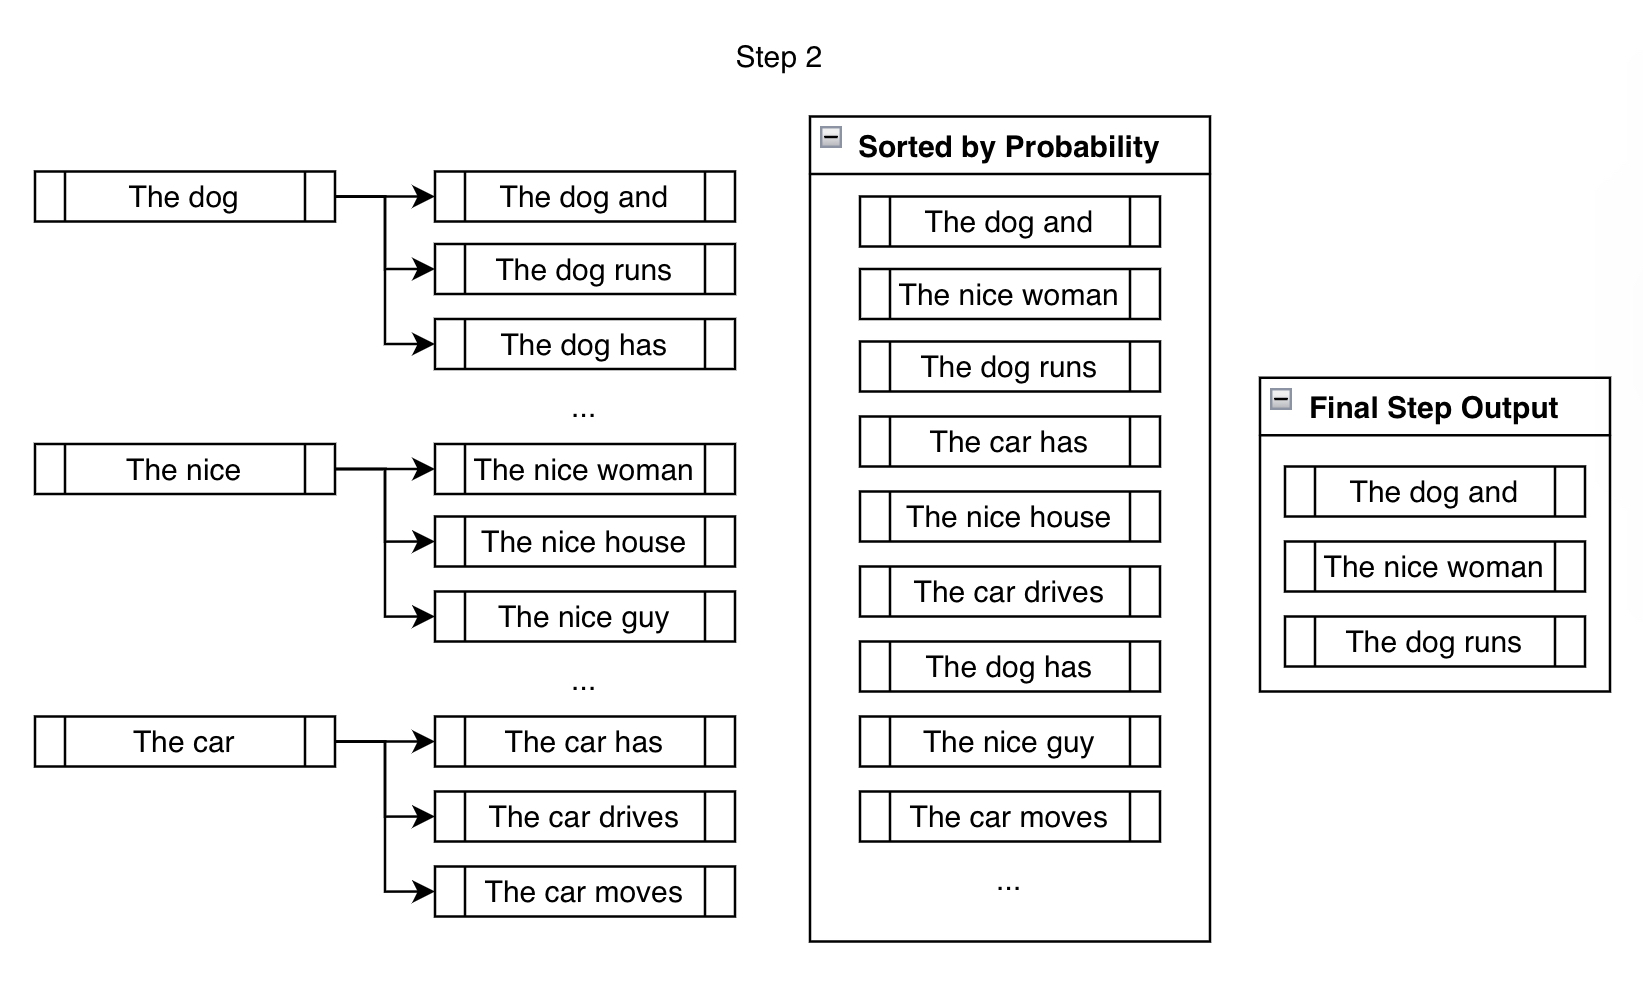
尽管我们最终考虑的输出远多于 num_beams 个,但我们在该步骤结束时将它们缩减到 num_beams 个。我们不能只是不断分支,否则对于 n n 步,我们需要跟踪的 beams 数量将是 beamsn \text{beams}^{n} ,这会非常迅速地变得非常大(10 10 步后的 10 10 个束是 10,000,000,000 10,000,000,000 个束!)。
在接下来的生成过程中,我们重复上述步骤,直到满足结束条件,例如生成 <eos> token 或达到 max_length。分支、排序、缩减,然后重复。
约束束搜索
约束束搜索试图通过在生成的每一步注入所需的 token 来满足约束。
假设我们试图在生成的输出中强制出现短语 "is fast"。
在传统的束搜索设置中,我们在每个分支找到概率最高的 k 个下一个 token,并将它们追加以供考虑。在约束设置中,我们做同样的事情,但还会追加那些将使我们更接近满足约束的 token。下面是一个演示:
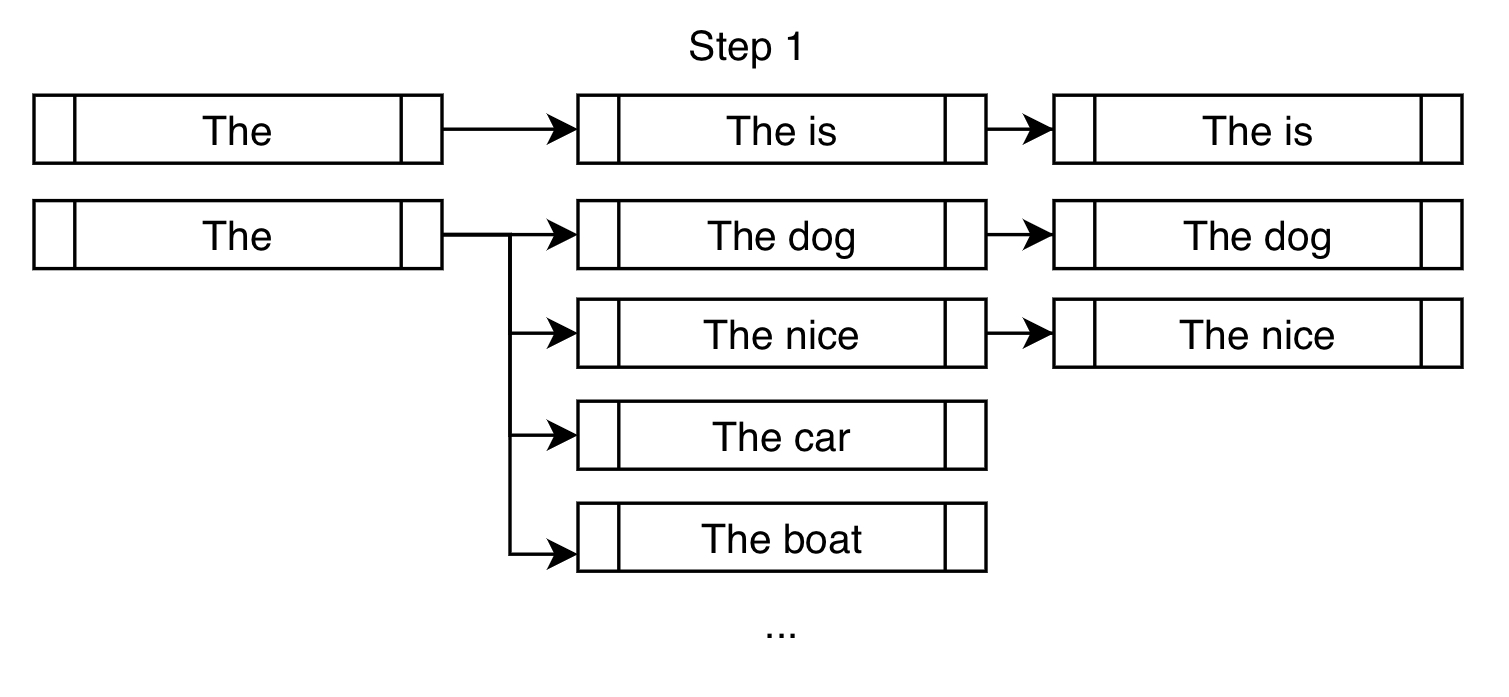
除了像 "dog" 和 "nice" 这样通常高概率的下一个 token 之外,我们强制加入 token "is",以便更接近满足 "is fast" 的约束。
对于下一步,下面分支出的候选大多与传统束搜索相同。但就像上面的例子一样,约束束搜索通过在每个新分支强制约束,在现有候选的基础上进行添加:
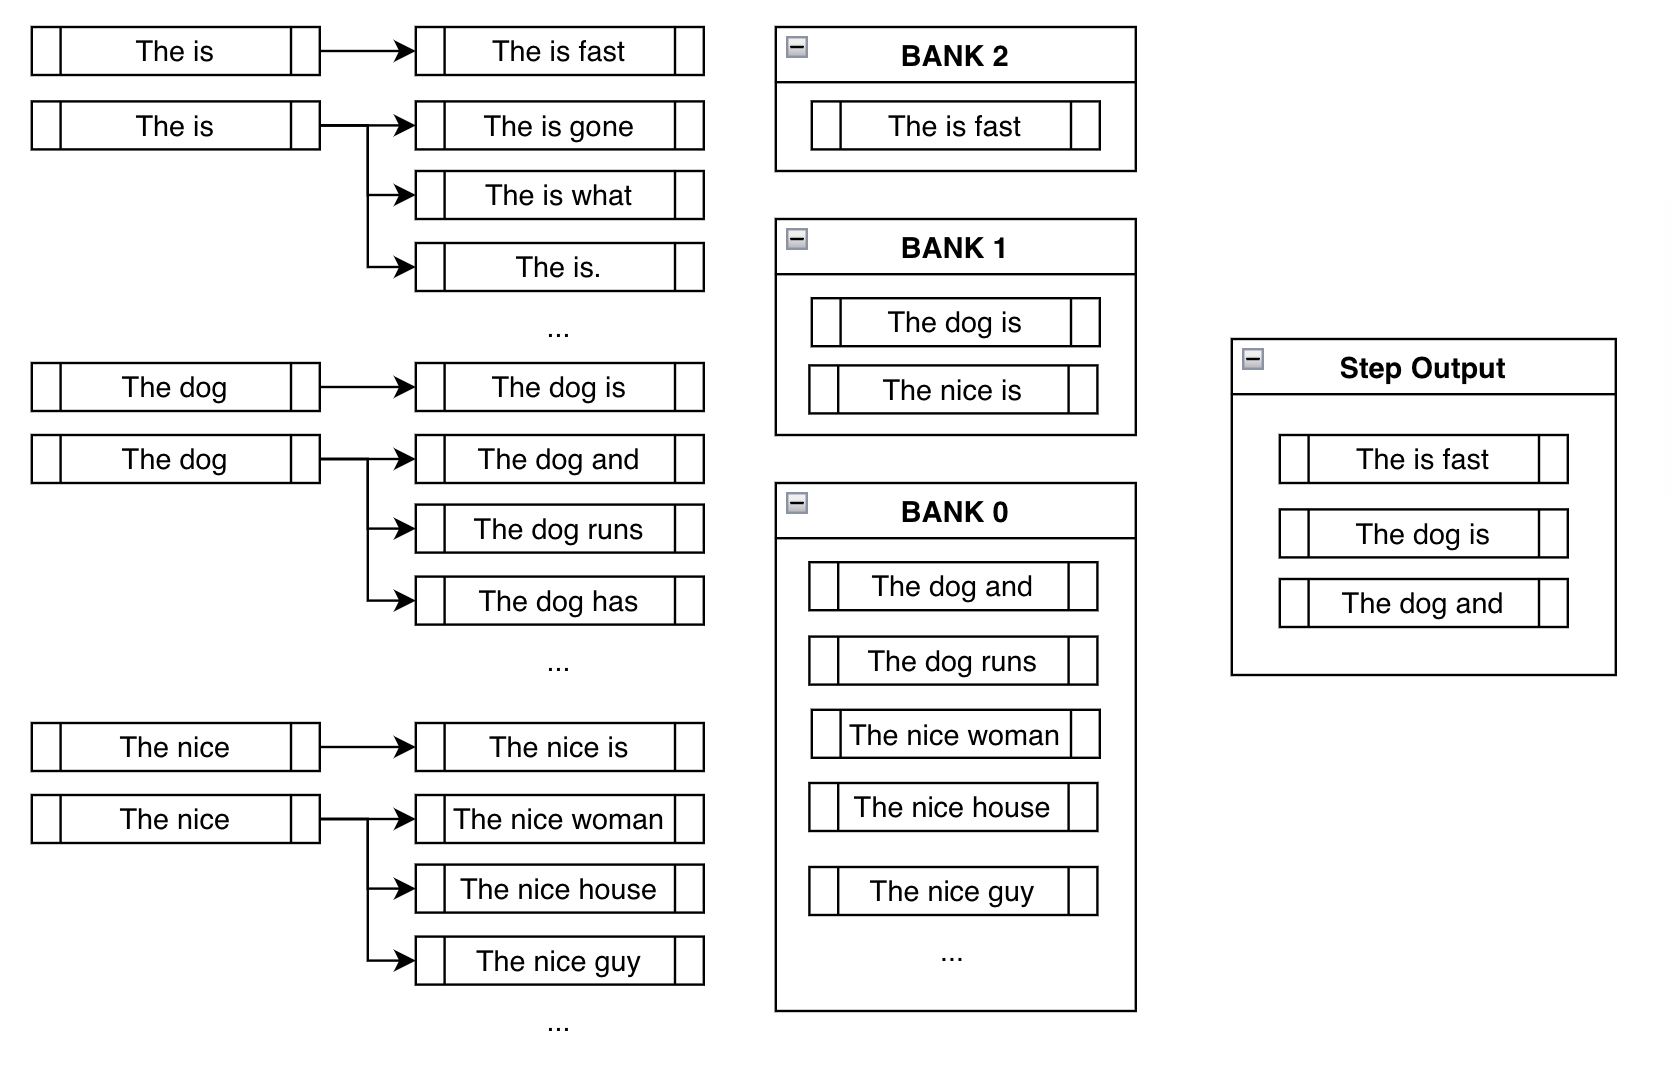
Banks
在我们讨论下一步之前,我们需要思考在上一步中可以看到的由此产生的不良行为。
天真地强制在输出中出现所需短语 "is fast" 的问题在于,大多数时候,你会得到像上面 "The is fast" 这样毫无意义的输出。这实际上正是这个问题难以解决的原因。关于解决这个问题复杂性的更深入讨论,可以在 huggingface/transformers 中提出的原始功能请求 issue 中找到。
Banks 通过在满足约束和生成合理输出之间创建平衡来解决这个问题。
Bank n n 指的是在满足约束方面已取得 n n 步进展的束的列表。在将所有可能的束分类到各自的 bank 后,我们进行轮询选择。以上面的例子来说,我们会从 Bank 2 中选择最可能的输出,然后从 Bank 1 中选择最可能的,从 Bank 0 中选择一个,从 Bank 2 中选择第二可能的,从 Bank 1 中选择第二可能的,依此类推。由于我们使用 num_beams=3,我们只需执行上述过程三次,最终得到 ["The is fast", "The dog is", "The dog and"]。
这样,即使我们强制模型考虑我们手动追加所需 token 的分支,我们仍然跟踪其他可能更合理的、高概率的序列。即使 "The is fast" 完全满足我们的约束,它也不是一个非常合理的短语。幸运的是,我们在未来的步骤中还有 "The dog is" 和 "The dog and" 可以使用,这有望在之后产生更合理的输出。
这种行为在上例的第三步中得到了演示:
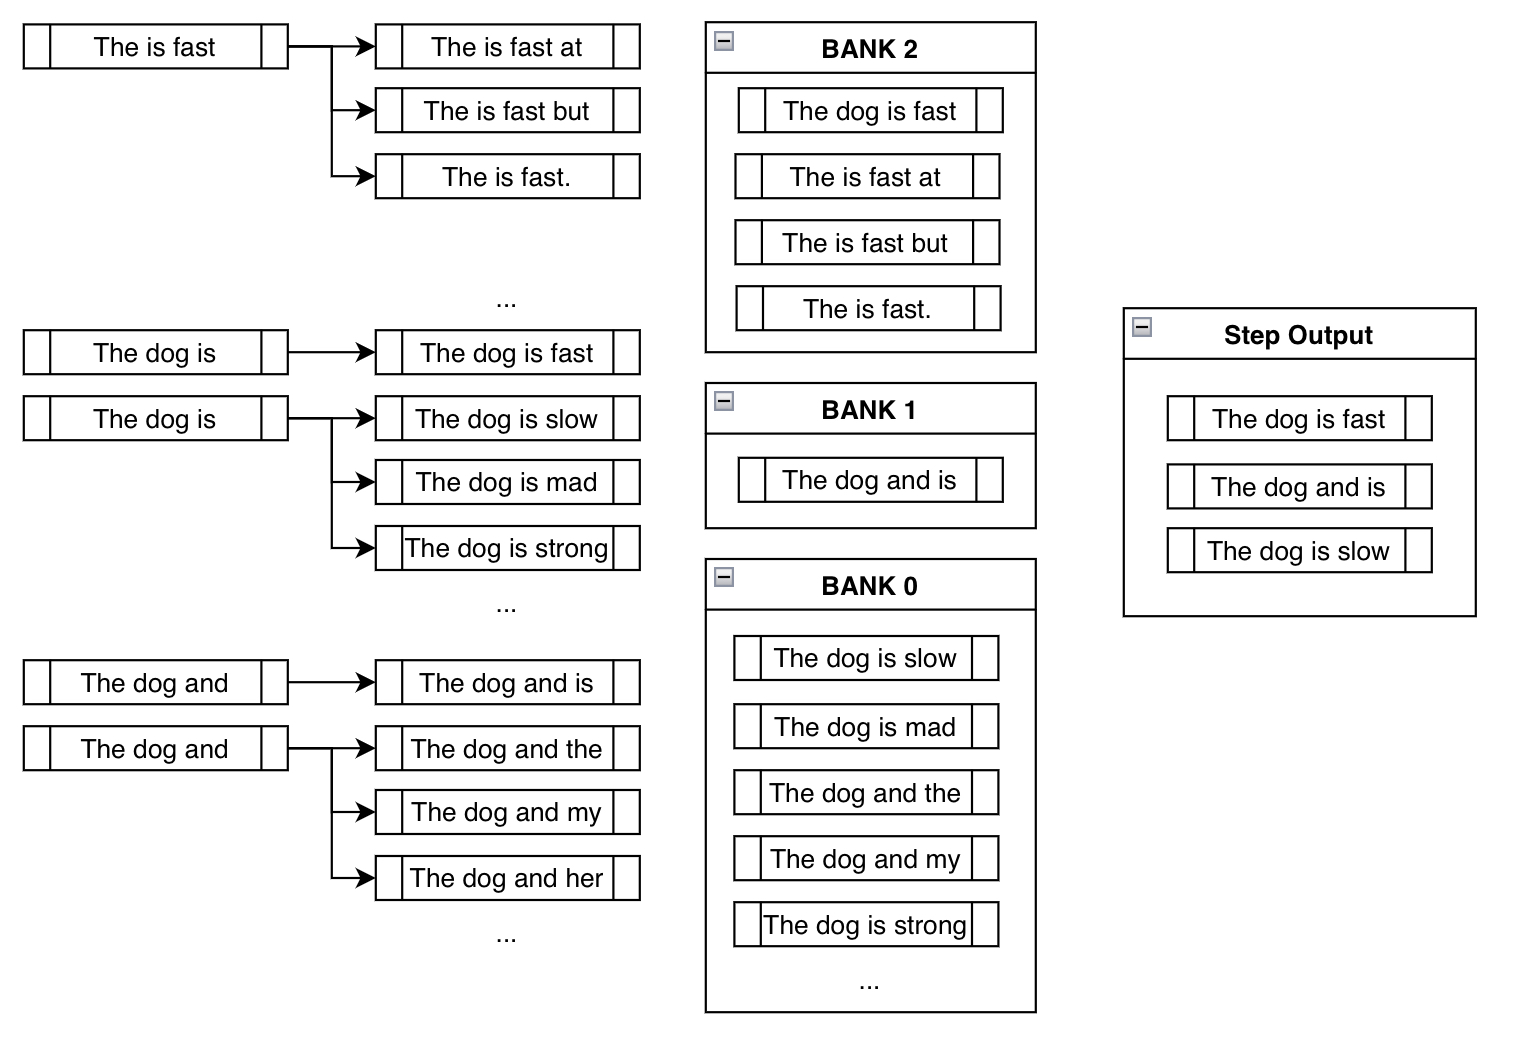
注意 "The is fast" 不需要任何手动追加约束 token,因为它已经满足了(即已经包含短语 "is fast")。另外,注意像 "The dog is slow" 或 "The dog is mad" 这样的束实际上在 Bank 0 中,因为尽管它包含 token "is",它必须从头重新开始才能生成 "is fast"。通过在 "is" 之后追加像 "slow" 这样的内容,它实际上重置了其进展。
最后注意我们如何最终得到一个包含我们约束短语的合理输出:"The dog is fast"!
起初我们很担心,因为盲目追加所需 token 会导致像 "The is fast" 这样毫无意义的短语。然而,通过从库中进行轮询选择,我们实际上最终去掉了无意义的输出,转而偏好更合理的输出。
关于 Constraint 类和自定义约束的更多内容
该解释的主要要点可以总结如下。在每一步,我们都不断促使模型考虑满足我们约束的 token,同时跟踪那些不满足约束的束,直到最终得到包含我们所需短语且概率相当高的序列。
因此,设计此实现的一种有原则的方法是将每个约束表示为一个 Constraint 对象,其目的是跟踪自身进度并告诉束搜索接下来生成哪些 token。尽管我们为 model.generate() 提供了关键字参数 force_words_ids,但后端实际发生的情况如下:
from transformers import AutoTokenizer, AutoModelForSeq2SeqLM, PhrasalConstraint

tokenizer = AutoTokenizer.from_pretrained("t5-base")
model = AutoModelForSeq2SeqLM.from_pretrained("t5-base")

encoder_input_str = "translate English to German: How old are you?"

constraints = [
    PhrasalConstraint(
        tokenizer("Sie", add_special_tokens=False).input_ids
    )
]

input_ids = tokenizer(encoder_input_str, return_tensors="pt").input_ids


outputs = model.generate(
    input_ids,
    constraints=constraints,
    num_beams=10,
    num_return_sequences=1,
    no_repeat_ngram_size=1,
    remove_invalid_values=True,
)


print("Output:\n" + 100 * '-')
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Output:
----------------------------------------------------------------------------------------------------
Wie alt sind Sie?
你可以自己定义一个并输入到 constraints 关键字参数中,以设计你独特的约束。你只需创建一个 Constraint 抽象接口类的子类并遵循其要求即可。你可以在这里找到 Constraint 定义中的更多信息。
一些独特的想法(尚未实现;也许你可以试一试!)包括像 OrderedConstraints、TemplateConstraints 这样的约束,它们可能会在后续加入。目前,生成是通过在输出中的任意位置包含这些序列来实现的。例如,之前的一个例子中,一个序列包含 scared -> screaming,另一个包含 screamed -> scared。OrderedConstraints 可以让用户指定这些约束被满足的顺序。
TemplateConstraints 可以让该功能有更小众的用途,其目标可以是这样的:
starting_text = "The woman"
template = ["the", "", "School of", "", "in"]

possible_outputs == [
   "The woman attended the Ross School of Business in Michigan.",
   "The woman was the administrator for the Harvard School of Business in MA."
]
或者:
starting_text = "The woman"
template = ["the", "", "", "University", "", "in"]

possible_outputs == [
   "The woman attended the Carnegie Mellon University in Pittsburgh.",
]
impossible_outputs == [
  "The woman attended the Harvard University in MA."
]
或者,如果用户不关心两个词之间可以有多少个 token,那么可以直接使用 OrderedConstraint。
结论
约束束搜索为我们提供了一种灵活的方式,将外部知识和要求注入文本生成中。以前,没有简单的方法告诉模型:1. 包含一个序列列表,其中 2. 有些是可选的,有些不是,使得 3. 它们在序列中的某个位置以各自合理的位置生成。现在,我们可以通过混合不同子类的 Constraint 对象来完全控制我们的生成!
这个新功能主要基于以下论文:
- Guided Open Vocabulary Image Captioning with Constrained Beam Search
- Fast Lexically Constrained Decoding with Dynamic Beam Allocation for Neural Machine Translation
- Improved Lexically Constrained Decoding for Translation and Monolingual Rewriting
- Guided Generation of Cause and Effect
像上面这些一样,许多新的研究论文正在探索使用外部知识(例如,KGs、KBs)来引导大型深度学习模型输出的方法。希望这个约束束搜索功能能成为实现这一目的的另一种有效方式。
感谢所有为这个功能贡献提供指导的人:Patrick von Platen 从最初的 issue 到最终的 PR 一直参与其中,以及 Narsil Patry,为代码提供了详细的反馈。
本文缩略图使用的图标署名:Shorthand icons created by Freepik - Flaticon
来源:Hugging Face:Blog(RSS) · huggingface.co