Hugging Face 发布开源库 Optimum,面向 Transformer 大规模生产优化
Introducing Optimum: The Optimization Toolkit for Transformers at Scale
Hugging Face 发布开源库 Optimum,目标是让 Transformer 模型在特定硬件上高效训练和推理,并与硬件伙伴合作提供优化工具。首个合作案例是 Intel Neural Compressor,支持后训练量化、量化感知训练和动态量化,文中演示了如何用 Optimum 对 Intel Xeon CPU 上的模型做动态量化。
原文给出 Optimum 的定位、与 Intel Neural Compressor 的量化示例和后续硬件合作计划,读者可评估其对生产部署的用处。
这篇博文是 Hugging Face 迈向普及最先进的机器学习生产性能之旅的第一步。为了实现这一目标,我们将与硬件合作伙伴携手合作,就像我们与下方的 Intel 一样。加入我们的旅程,关注 Optimum,我们的新开源库!
为什么选择 🤗 Optimum?
🤯 扩展 Transformers 很难
Tesla、Google、Microsoft 和 Facebook 有什么共同点? 嗯,有很多,但其中之一是它们每天都要运行数十亿次 Transformer 模型预测。 Transformer 用于 AutoPilot 驾驶你的 Tesla(你真幸运!), 用于 Gmail 补全你的句子, 用于 Facebook 实时翻译你的帖子, 用于 Bing 回答你的自然语言查询。
Transformers 为机器学习模型的准确性带来了跨越式的提升,征服了 NLP,现在正扩展到其他模态,从语音和视觉开始。 但将这些庞大的模型投入生产,并让它们大规模快速运行,对任何机器学习工程团队来说都是一个巨大的挑战。
如果你没有像上述公司那样雇佣数百名高技能机器学习工程师呢? 通过 Optimum,我们的新开源库,我们旨在构建 Transformers 生产性能的权威工具包, 并实现最大效率,以便在特定硬件上训练和运行模型。
🏭 Optimum 让 Transformers 发挥作用
为了获得最佳的模型训练和推理性能,模型加速技术需要与目标硬件特别兼容。 每个硬件平台都提供特定的软件工具、 特性和参数,这些可能对性能产生巨大影响。 同样,为了利用稀疏性和量化等高级模型加速技术,优化内核需要与硅片上的算子兼容, 并且特定于从模型架构派生的神经网络图。 深入研究这个三维兼容性矩阵以及如何使用模型加速库是一项艰巨的工作, 很少有机器学习工程师有这方面的经验。
Optimum 旨在让这项工作变得简单,提供针对高效 AI 硬件的性能优化工具, 与我们的硬件合作伙伴合作构建,并将机器学习工程师变成 ML 优化巫师。
通过 Transformers 库,我们让研究人员和工程师轻松使用最先进的模型, 抽象掉了框架、架构和管道的复杂性。
通过 Optimum 库,我们让工程师轻松利用他们可用的所有硬件特性, 抽象掉了硬件平台上模型加速的复杂性。
🤗 Optimum 实践:如何为 Intel Xeon CPU 量化模型
🤔 为什么量化很重要但很难做对
像 BERT 这样的预训练语言模型在广泛的自然语言处理任务上取得了最先进的结果, 其他基于 Transformer 的模型如 ViT 和 Speech2Text 分别在计算机视觉和语音任务上取得了最先进的结果: transformers 在机器学习世界中无处不在,并将继续存在。
然而,将基于 transformer 的模型投入生产可能既棘手又昂贵,因为它们需要大量算力才能运行。 为了解决这个问题,存在许多技术,其中最流行的是量化。 遗憾的是,在大多数情况下,量化模型需要大量工作,原因有很多:
- 模型需要被编辑:一些算子需要被替换为它们的量化对应版本,需要插入新的算子(量化和反量化节点), 其他算子需要适应权重和激活值将被量化这一事实。
这部分可能非常耗时,因为像 PyTorch 这样的框架以 eager 模式工作,这意味着上述更改需要添加到模型实现本身。
PyTorch 现在提供了一个名为 torch.fx 的工具,它允许你在无需实际更改模型实现的情况下追踪和转换模型,但当你的模型开箱即不支持追踪时,使用它会很棘手。
除了实际的编辑之外,还需要找出模型的哪些部分需要被编辑, 哪些算子有可用的量化内核对应版本,哪些没有,等等。
一旦模型被编辑完成,还有许多参数需要调整,以找到最佳的量化设置:
- 我应该使用哪种观察器进行范围校准?
- 我应该使用哪种量化方案?
- 我的目标设备支持哪些与量化相关的数据类型(int8、uint8、int16)?
在量化与可接受的精度损失之间取得平衡。
为目标设备导出量化后的模型。
尽管 PyTorch 和 TensorFlow 在简化量化方面取得了巨大进步, 但基于 transformer 的模型的复杂性使得很难开箱即用地使用所提供的工具,并且不付出大量努力就能让某些东西正常工作。
💡 Intel 如何用 Neural Compressor 解决量化等问题
Intel® Neural Compressor(以前称为 Low Precision Optimization Tool 或 LPOT)是一个开源 Python 库,旨在帮助用户部署低精度推理解决方案。 后者为深度学习模型应用低精度配方,以在预期性能标准下实现最佳产品目标, 例如推理性能和内存占用。 Neural Compressor 支持训练后量化、量化感知训练和动态量化。 为了指定量化方法、目标和性能标准,用户必须提供一个指定调优参数的配置 yaml 文件。 该配置文件既可以托管在 Hugging Face 的 Model Hub 上,也可以通过本地目录路径提供。
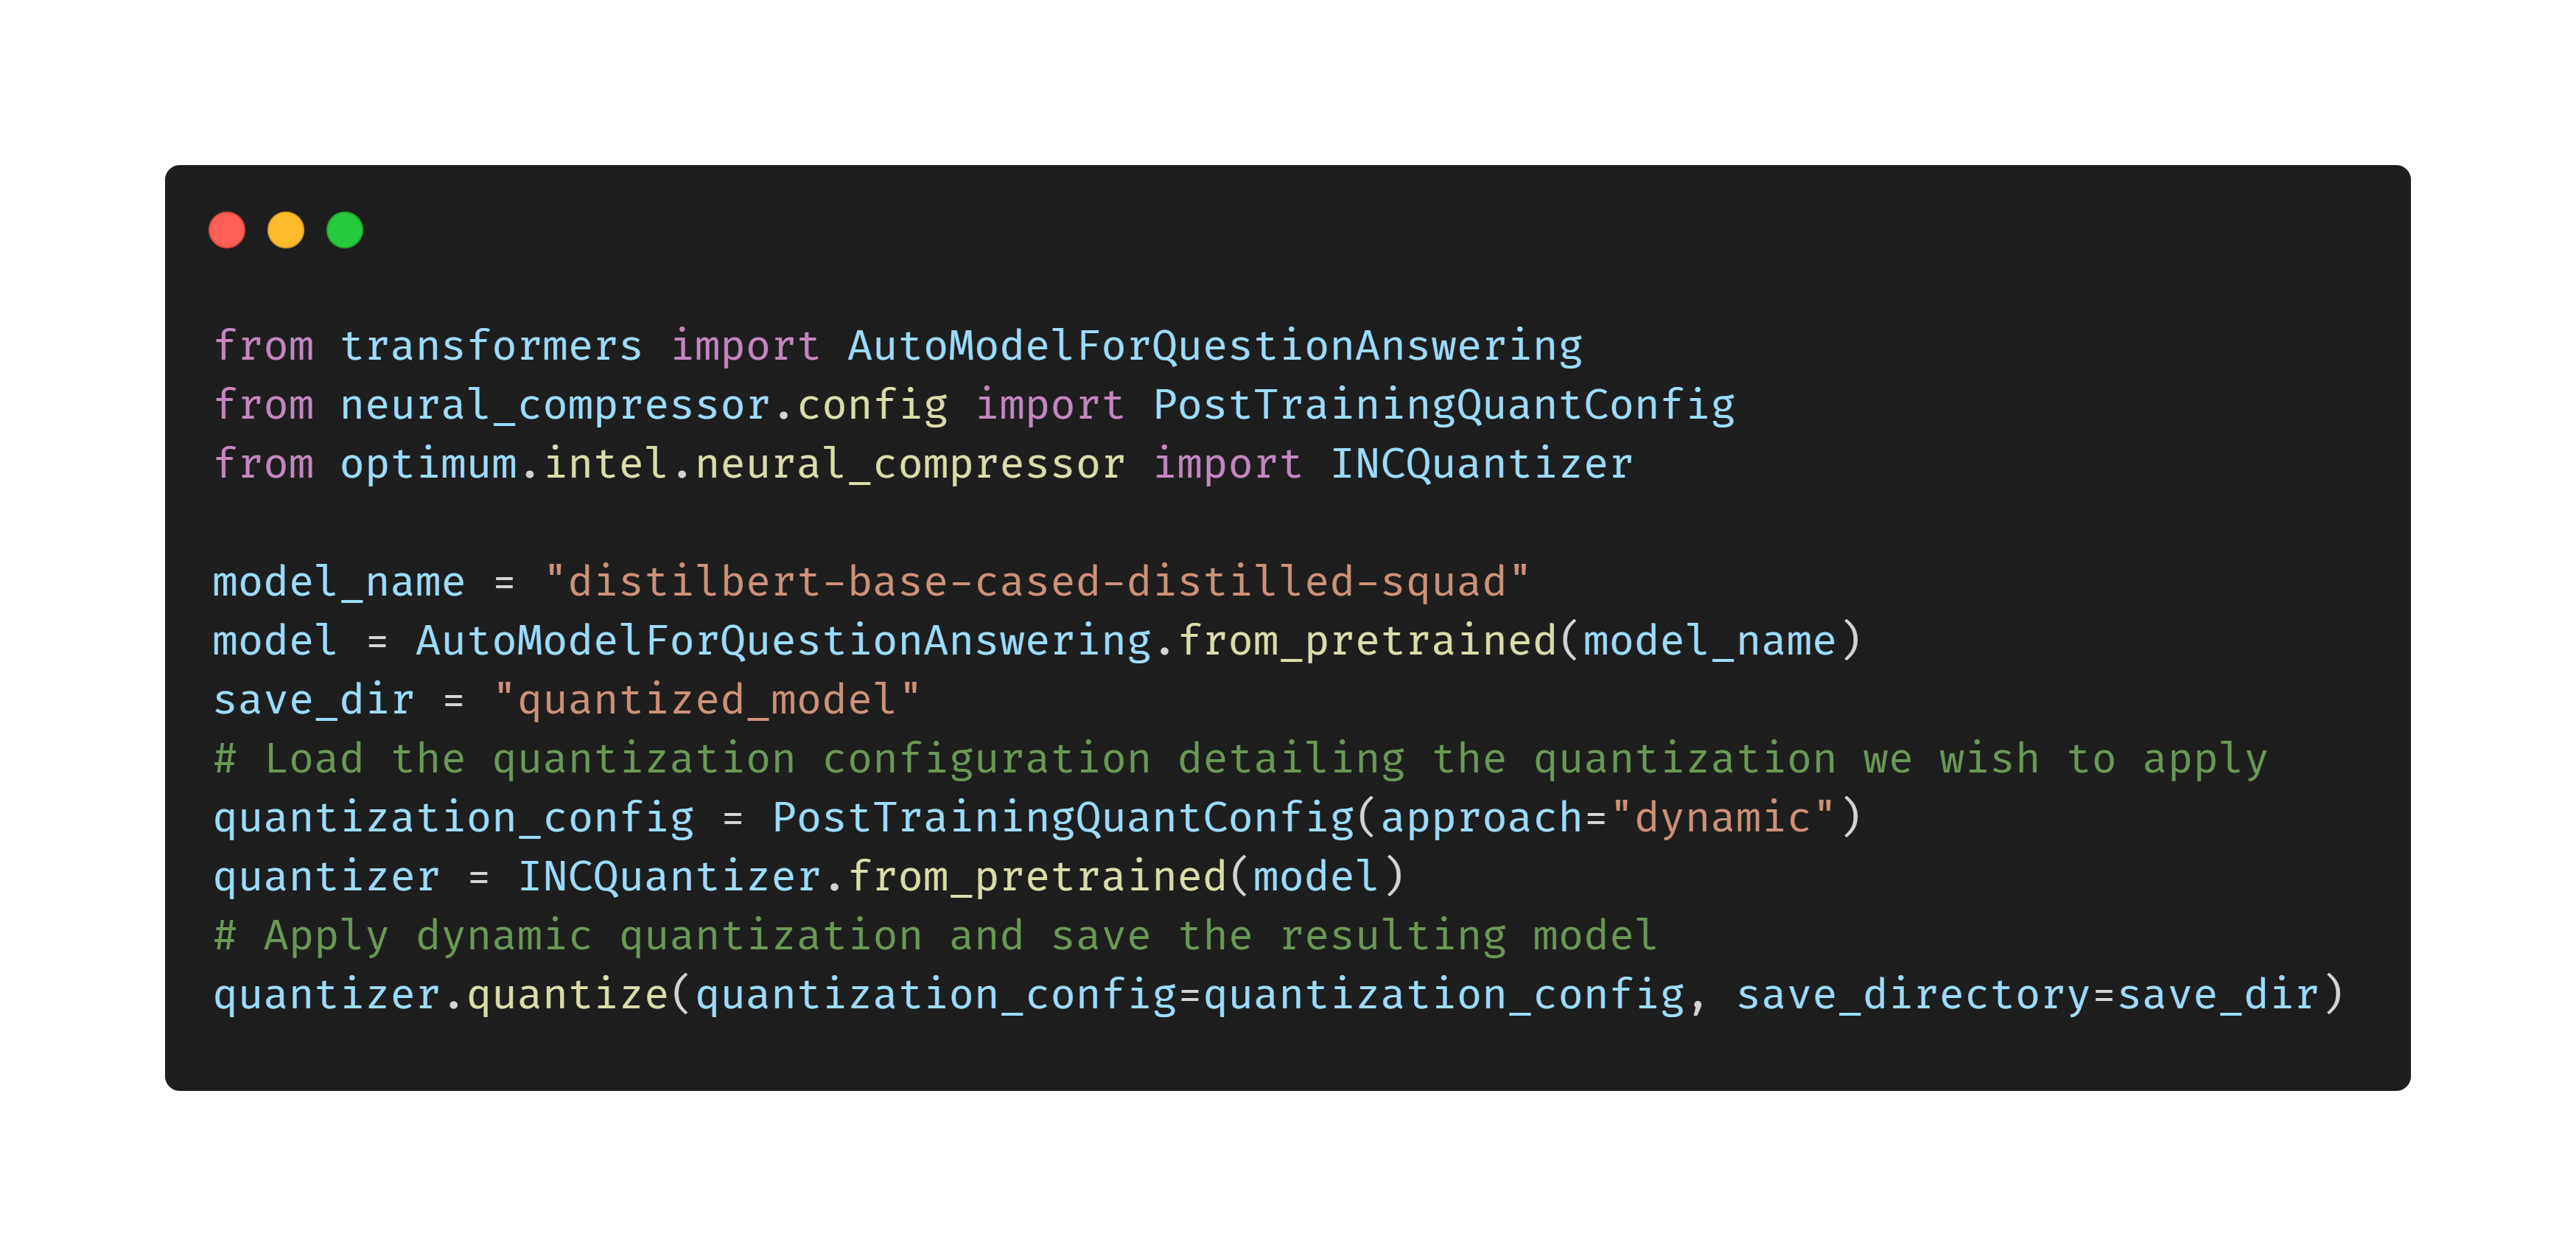
🔥 如何使用 Optimum 轻松为 Intel Xeon CPU 量化 Transformers
关注 🤗 Optimum:一段让 ML 生产性能民主化的旅程
⚡️最先进的硬件
Optimum 将专注于在专用硬件上实现最佳生产性能,在那里可以应用软件和硬件加速技术以实现最大效率。 我们将与我们的硬件合作伙伴携手合作,启用、测试和维护加速,并通过 Optimum 以简单易用的方式交付,正如我们与 Intel 和 Neural Compressor 所做的那样。 我们很快将宣布加入我们迈向机器学习效率之旅的新硬件合作伙伴。
🔮 最先进的模型
与我们的硬件合作伙伴的合作将产生针对特定硬件优化的模型配置和工件, 我们将通过 Hugging Face Model Hub 向 AI 社区提供这些内容。 我们希望 Optimum 和硬件优化模型能够加速在生产工作负载中采用效率优化, 这些工作负载代表了机器学习总能耗的大部分。 最重要的是,我们希望 Optimum 能够加速 Transformers 的大规模采用,不仅是为最大的科技公司,而是为我们所有人。
🌟 合作之旅:加入我们,关注我们的进展
每段旅程都始于第一步,而我们的第一步就是公开发布 Optimum。 加入我们,迈出你的第一步,为这个库点个 Star, 这样你就能跟随我们一同见证新支持的硬件、加速技术和优化模型的推出。
如果你希望在 Optimum 中看到新的硬件和功能得到支持, 或者你有兴趣加入我们,在软件与硬件的交叉领域工作,请通过 hardware@huggingface.co 联系我们。
来源:Hugging Face:Blog(RSS) · huggingface.co