Hugging Face 发布高压缩快速扩散文生图模型 Würstchen
Introducing Würstchen: Fast Diffusion for Image Generation
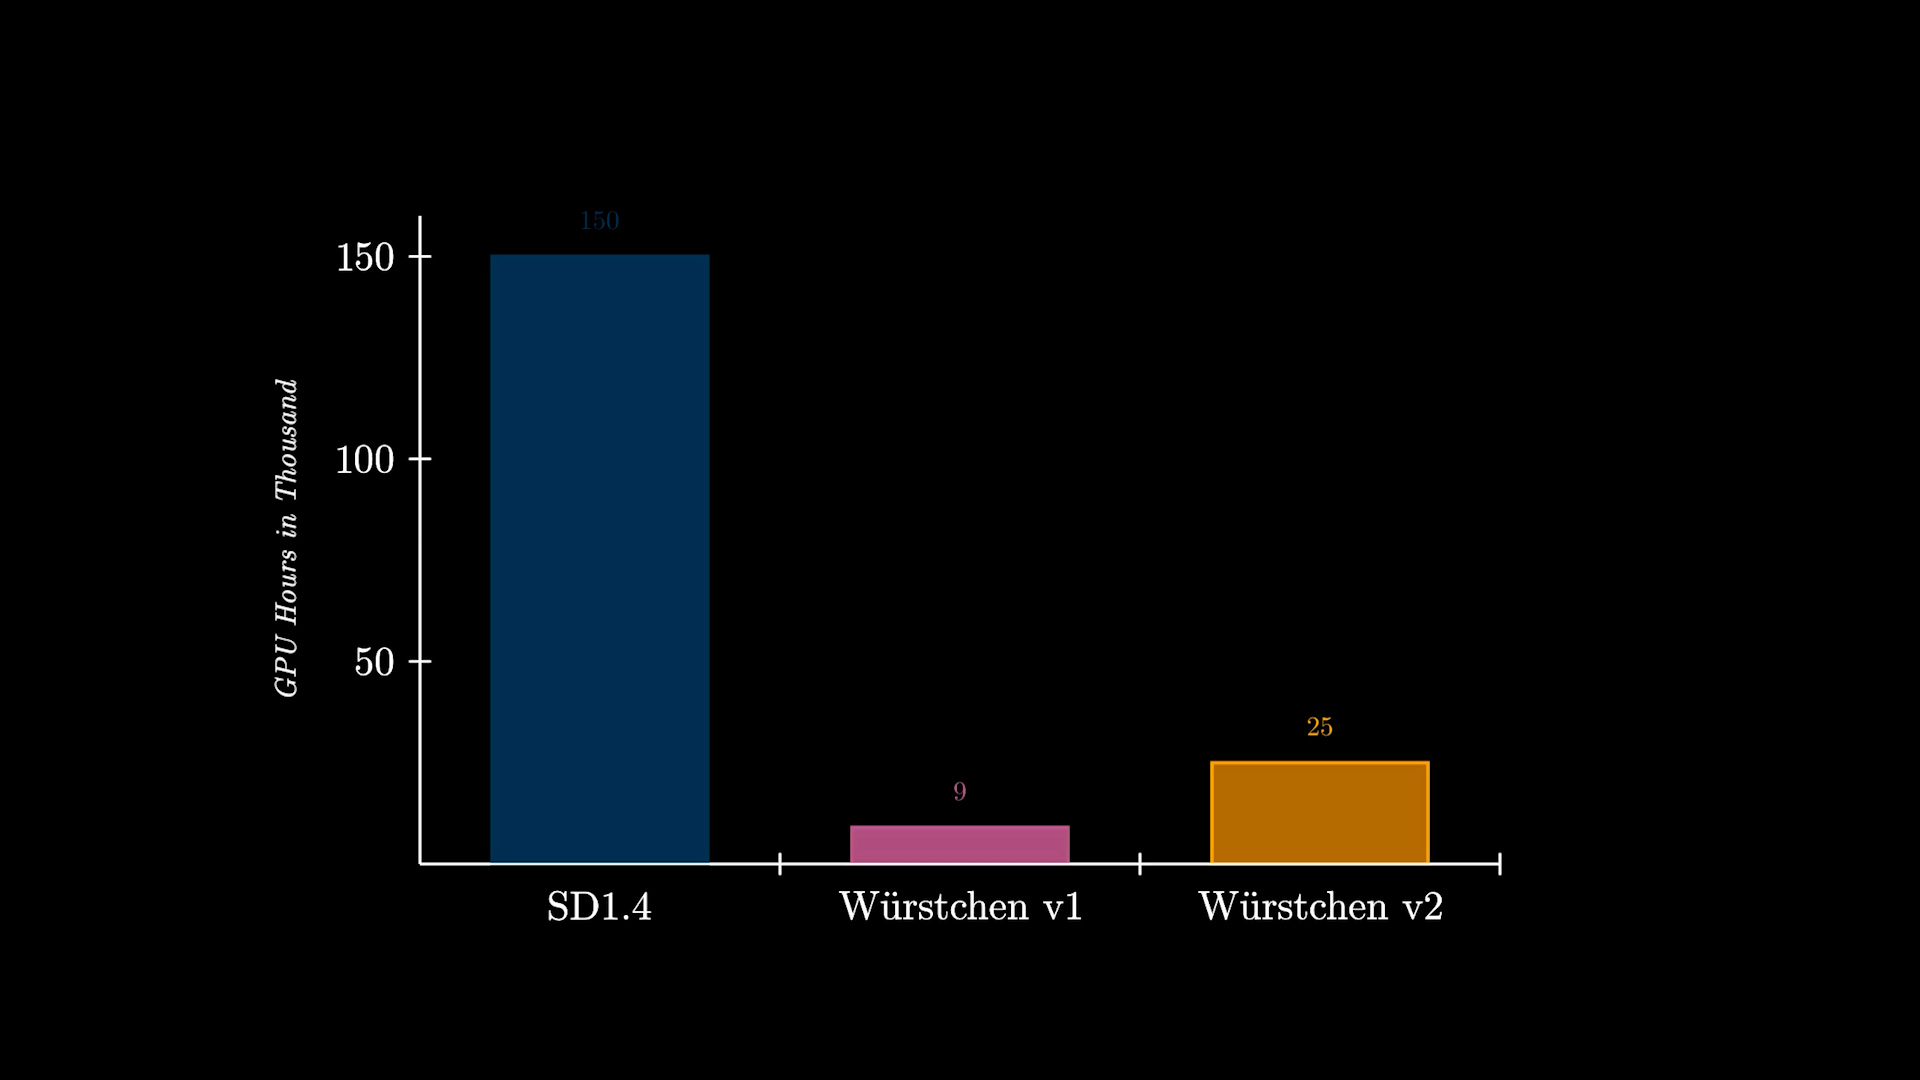
Hugging Face 发布扩散文生图模型 Würstchen,其文本条件组件在 42x 空间压缩的潜空间中工作,生成速度比 SDXL 更快且占用内存更少。Würstchen v1 训练仅用 9,000 GPU 小时,约为 Stable Diffusion 1.4(150,000 GPU 小时)的 1/16;v2 用 24,602 GPU 小时支持最高 1536 分辨率。
原文给出 42x 空间压缩设计和与 SDXL 的训练、推理成本对比,读者可据此评估它在低算力场景的可用性。
什么是 Würstchen?
Würstchen 是一种扩散模型,其文本条件组件在高度压缩的图像潜在空间中工作。为什么这很重要?压缩数据可以将训练和推理的计算成本降低几个数量级。在 1024×1024 图像上训练比在 32×32 上训练昂贵得多。通常,其他工作使用相对较小的压缩,在 4x - 8x 空间压缩范围内。Würstchen 将这一点推向了极致。通过其新颖的设计,它实现了 42x 的空间压缩!这是前所未有的,因为常见方法在 16x 空间压缩后无法忠实重建细节图像。Würstchen 采用两阶段压缩,我们称之为 Stage A 和 Stage B。Stage A 是 VQGAN,Stage B 是 Diffusion Autoencoder(更多细节可在 论文中找到)。Stage A 和 B 一起被称为解码器,因为它们将压缩图像解码回像素空间。第三个模型 Stage C 在那个高度压缩的潜在空间中学习。这种训练所需的计算量仅为当前顶级模型所用计算量的一小部分,同时还允许更便宜和更快的推理。我们将 Stage C 称为先验。
为什么还要另一个文本到图像模型?
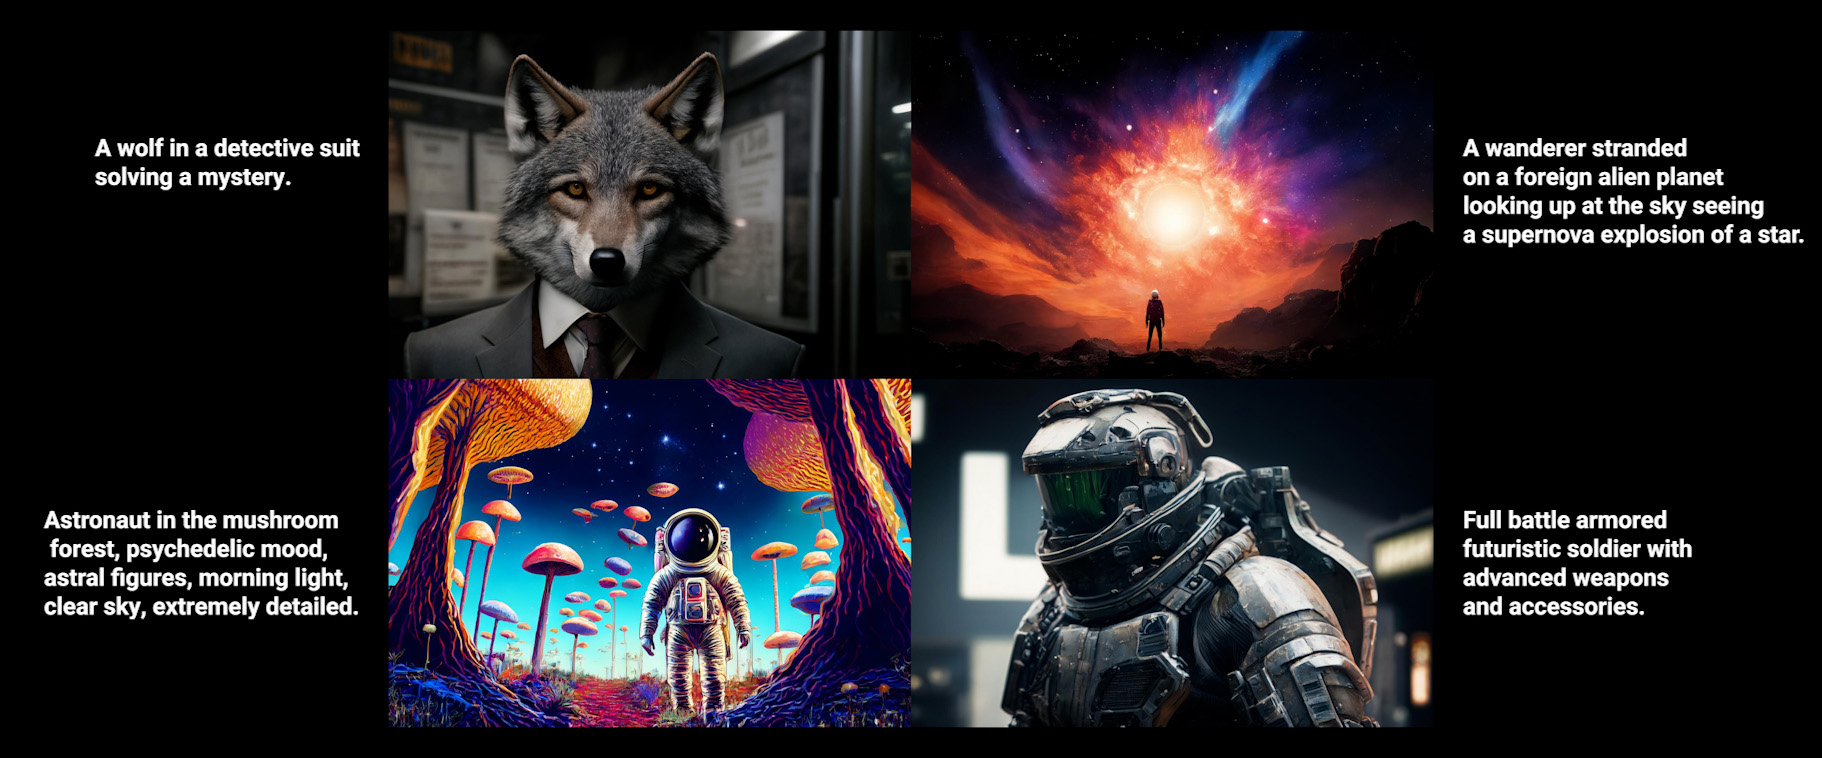
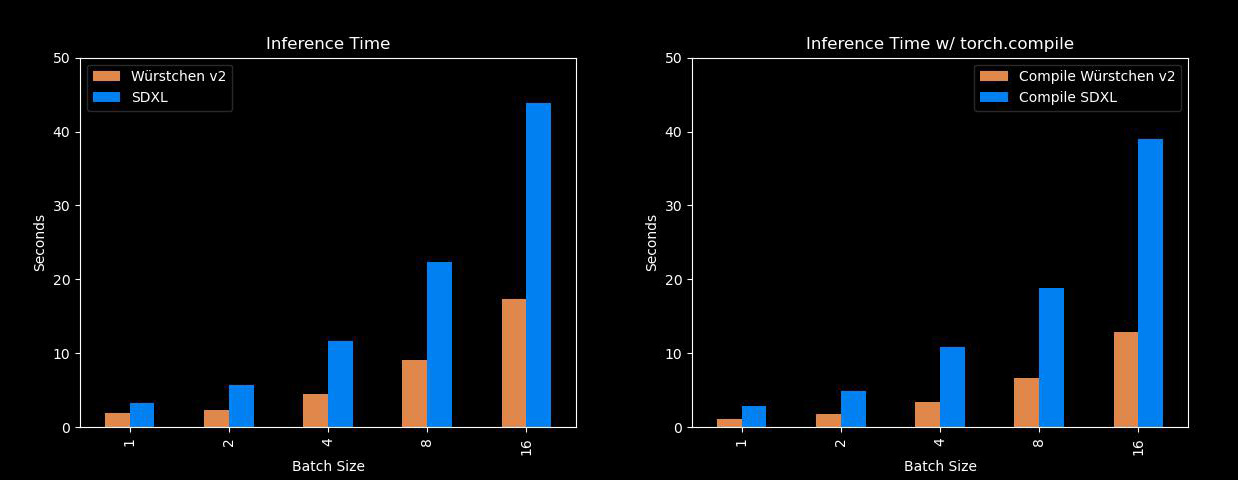
嗯,这个模型非常快速且高效。Würstchen 最大的优势在于它能够比 Stable Diffusion XL 等模型更快地生成图像,同时使用的内存少得多!所以对于我们这些没有 A100 的人来说,这会非常方便。以下是不同批量大小下与 SDXL 的比较:
除此之外,Würstchen 另一个非常重要的优势是降低了训练成本。Würstchen v1 在 512x512 下工作,仅需 9,000 GPU 小时的训练。将其与 Stable Diffusion 1.4 花费的 150,000 GPU 小时相比,表明这种 16 倍的成本降低不仅有利于研究人员进行新实验,还为更多组织训练此类模型打开了大门。Würstchen v2 使用了 24,602 GPU 小时。分辨率高达 1536,这仍然比仅在 512x512 下训练的 SD1.4 便宜 6 倍。
你也可以在这里找到详细的解释视频:
如何使用 Würstchen?
你可以在这里使用演示来尝试:
否则,该模型可通过 Diffusers 库获得,因此你可以使用已经熟悉的接口。例如,这是使用 AutoPipeline 运行推理的方法:
import torch
from diffusers import AutoPipelineForText2Image
from diffusers.pipelines.wuerstchen import DEFAULT_STAGE_C_TIMESTEPS

pipeline = AutoPipelineForText2Image.from_pretrained("warp-ai/wuerstchen", torch_dtype=torch.float16).to("cuda")

caption = "Anthropomorphic cat dressed as a firefighter"
images = pipeline(
    caption,
    height=1024,
    width=1536,
    prior_timesteps=DEFAULT_STAGE_C_TIMESTEPS,
    prior_guidance_scale=4.0,
    num_images_per_prompt=4,
).images
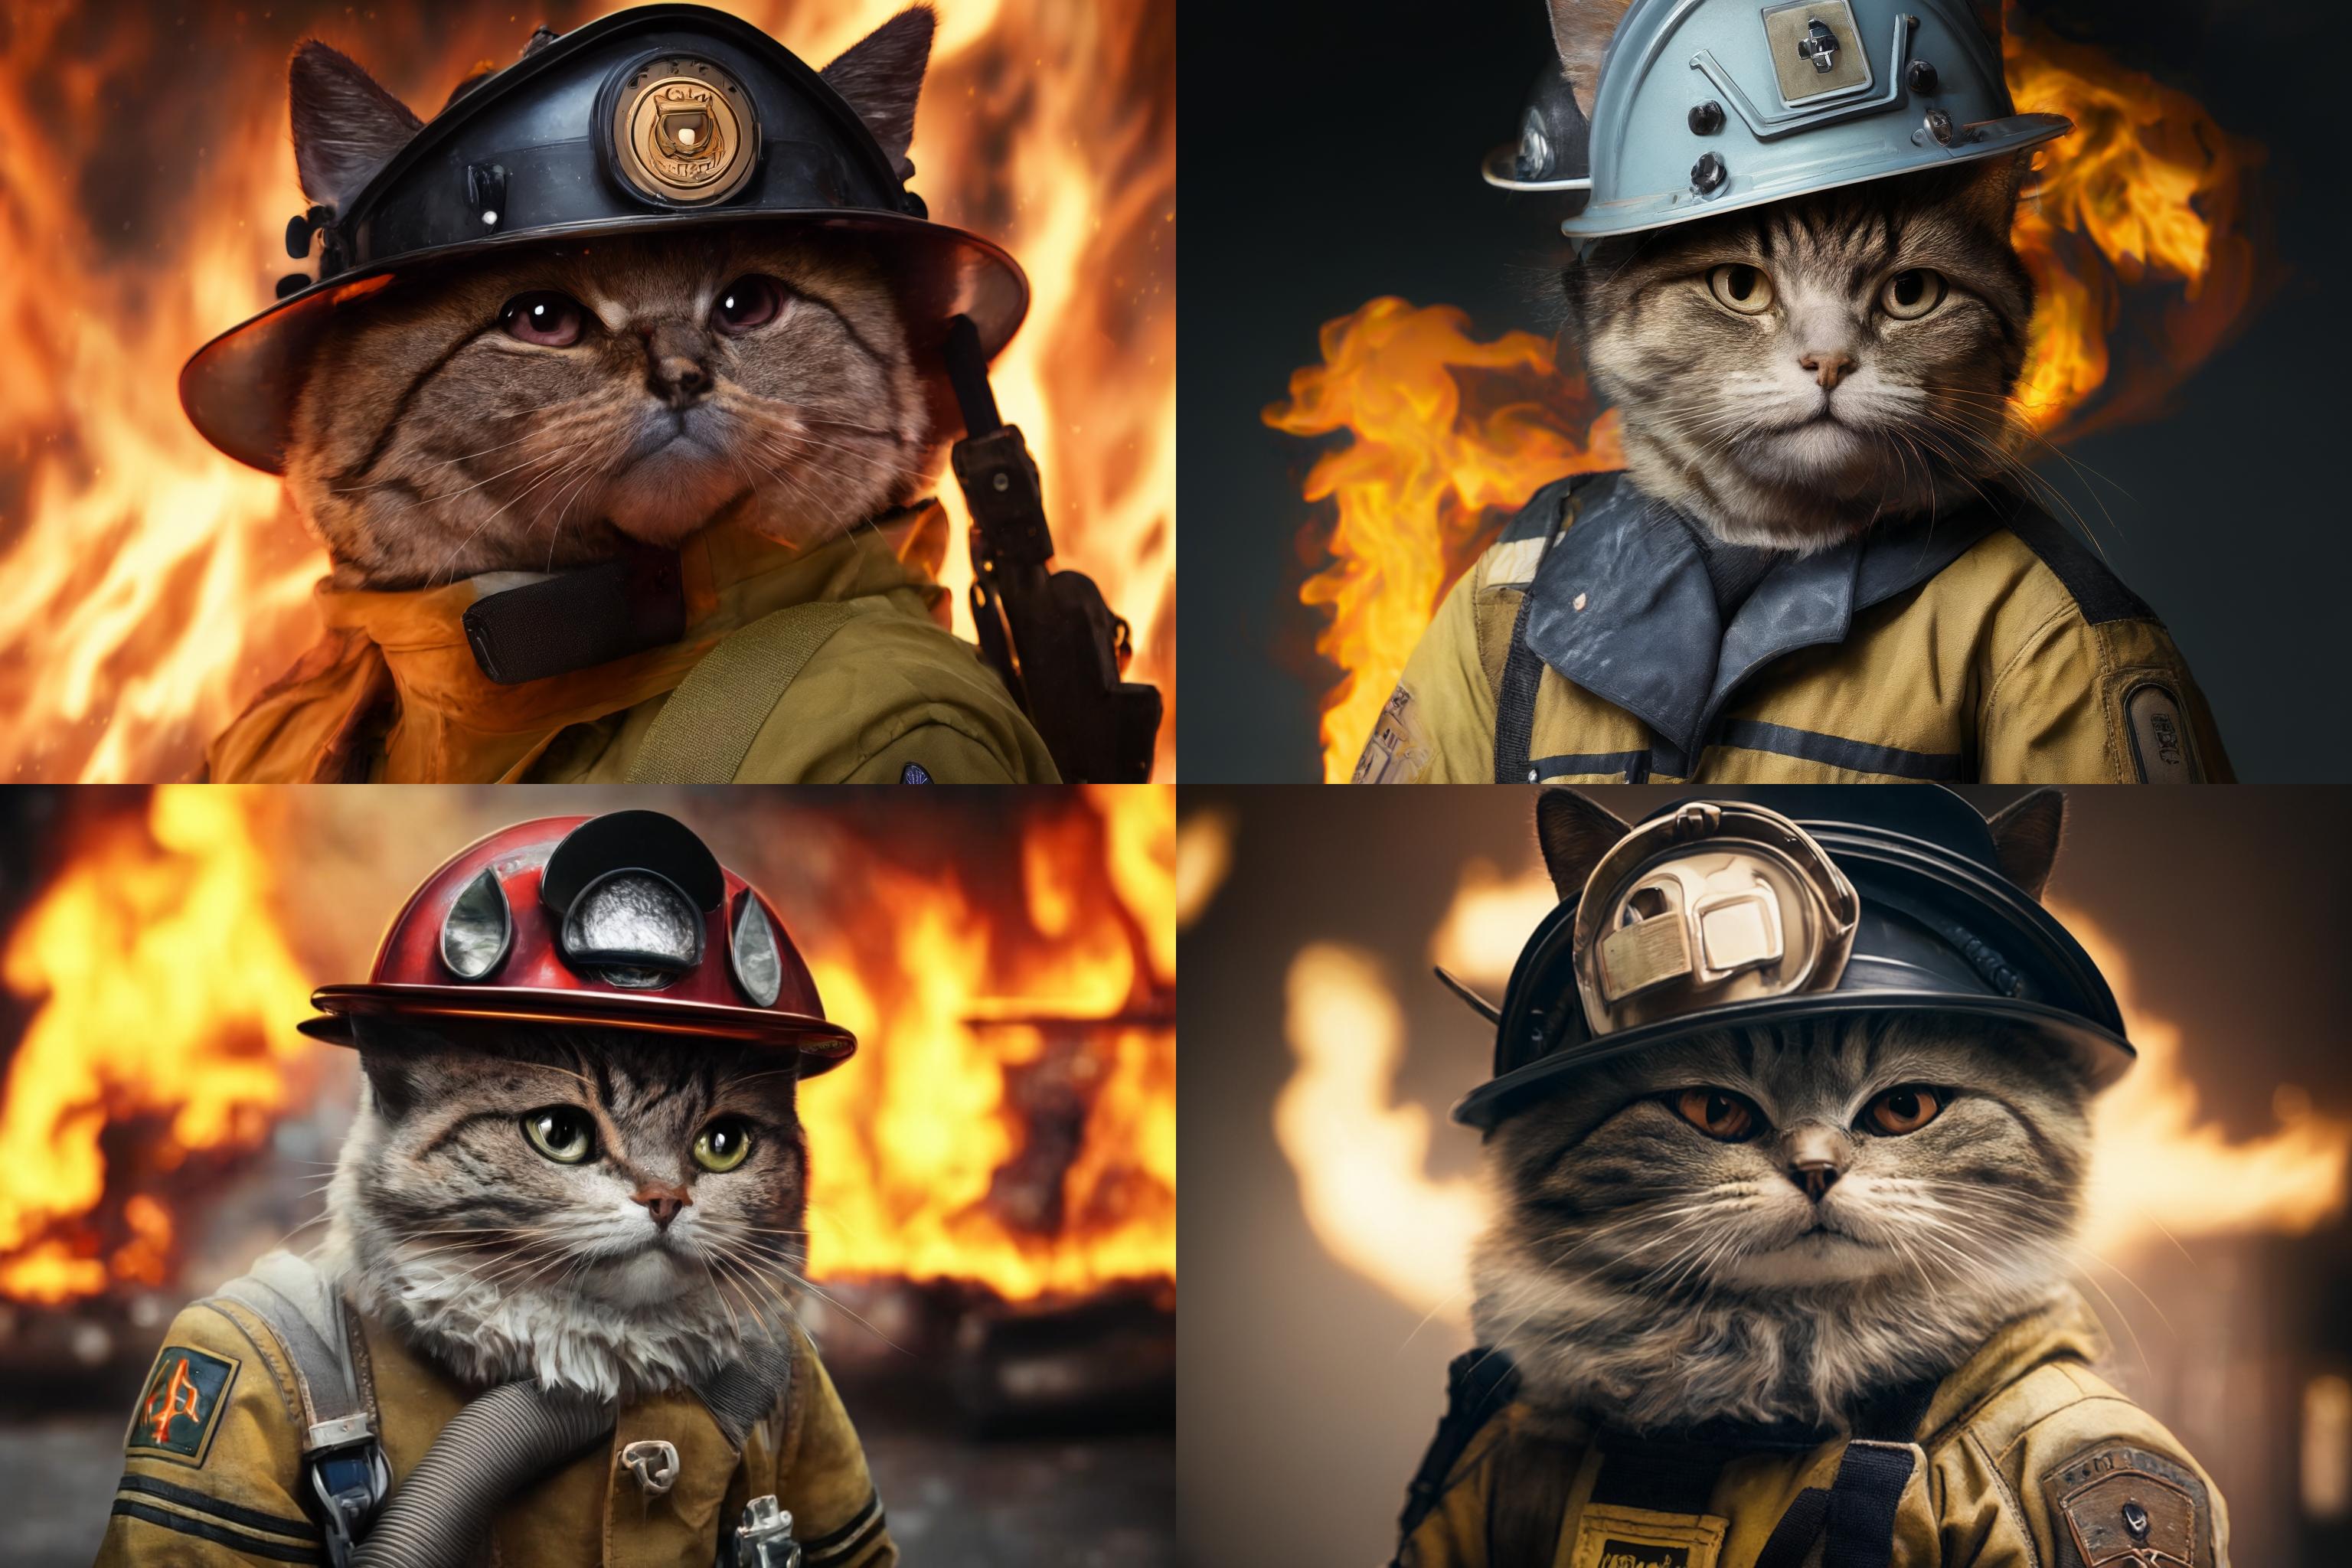
Würstchen 适用于哪些图像尺寸?
Würstchen 在 1024x1024 和 1536x1536 之间的图像分辨率上进行了训练。我们有时也会在 1024x2048 等分辨率下观察到良好的输出。欢迎尝试。
我们还观察到先验(Stage C)对新分辨率的适应速度极快。因此在 2048x2048 下微调它应该在计算上很便宜。

Hub 上的模型
所有检查点也可以在 Huggingface Hub 上查看。多个检查点以及未来的演示和模型权重都可以在那里找到。目前有 3 个先验检查点和 1 个解码器检查点可用。 请查看文档,其中解释了检查点以及不同的先验模型是什么以及可以用于什么。
Diffusers 集成
由于 Würstchen 已完全集成到 diffusers 中,它开箱即用地自带各种实用功能和优化。这些包括:
- 自动使用 PyTorch 2
SDPA加速注意力机制,如下所述。 - 支持 xFormers flash attention 实现,如果你需要使用 PyTorch 1.x 而不是 2。
- 模型卸载,在未使用时将未使用的组件移至 CPU。这可以节省内存,且性能影响可忽略不计。
- 顺序 CPU 卸载,适用于内存非常宝贵的情况。内存使用将被最小化,代价是推理速度变慢。
- 使用 Compel 库进行提示词加权。
- 在 Apple Silicon Mac 上支持
mps设备。 - 使用生成器以实现可复现性。
- 为推理提供合理的默认值,在大多数情况下都能产生高质量的结果。当然,你可以随意调整所有参数!
优化技术 1:Flash Attention
从 2.0 版本开始,PyTorch 集成了一个高度优化且资源友好的注意力机制版本,称为 torch.nn.functional.scaled_dot_product_attention 或 SDPA。根据输入的性质,此函数会利用多种底层优化。其性能和内存效率优于传统的注意力模型。值得注意的是,SDPA 函数与 flash attention 技术的特性相似,正如 Dao 及其团队在论文 Fast and Memory-Efficient Exact Attention with IO-Awareness 中所强调的那样。
如果你将 Diffusers 与 PyTorch 2.0 或更高版本一起使用,并且 SDPA 函数可用,这些增强功能会自动应用。按照官方指南设置 torch 2.0 或更新版本即可开始!
images = pipeline(caption, height=1024, width=1536, prior_timesteps=DEFAULT_STAGE_C_TIMESTEPS, prior_guidance_scale=4.0, num_images_per_prompt=4).images
要深入了解 diffusers 如何利用 SDPA,请查看文档。
如果你使用的是早于 2.0 的 Pytorch 版本,你仍然可以使用 xFormers 库实现内存高效的注意力机制:
pipeline.enable_xformers_memory_efficient_attention()
优化技术 2:Torch Compile
如果你在寻求额外的性能提升,可以使用 torch.compile。最好将其同时应用于先验模型和解码器的主模型,以获得最大的性能提升。
pipeline.prior_prior = torch.compile(pipeline.prior_prior , mode="reduce-overhead", fullgraph=True)
pipeline.decoder = torch.compile(pipeline.decoder, mode="reduce-overhead", fullgraph=True)
请记住,在模型编译期间,初始推理步骤将花费很长时间(最多 2 分钟)。之后你就可以正常进行推理了:
images = pipeline(caption, height=1024, width=1536, prior_timesteps=DEFAULT_STAGE_C_TIMESTEPS, prior_guidance_scale=4.0, num_images_per_prompt=4).images
好消息是,这种编译是一次性执行的。此后,对于相同的图像分辨率,你将持续体验到更快的推理速度。编译的初始时间投入很快就会被随后的速度优势所抵消。要深入了解 torch.compile 及其细节,请查看官方文档。
模型是如何训练的?
训练此模型的能力仅通过 Stability AI 提供的计算资源才得以实现。 我们要特别感谢 Stability,让我们有机会进行这类研究,并有机会让更多人能够使用它!
资源
来源:Hugging Face:Blog(RSS) · huggingface.co