Hugging Face 讲解如何用 LoRA 高效微调 Stable Diffusion
Using LoRA for Efficient Stable Diffusion Fine-Tuning
Hugging Face 在 diffusers 中正式支持用 LoRA 微调 Stable Diffusion,覆盖 Dreambooth 和全量微调两种方式。
原文给出 LoRA 微调 Stable Diffusion 的具体收益和可复现训练脚本,11 GB 显存即可跑通。
LoRA:大型语言模型的低秩适应是微软研究人员提出的一项新技术,用于解决大型语言模型的微调问题。拥有数十亿参数的强大模型(如 GPT-3)为了适应特定任务或领域而进行微调的成本高得令人望而却步。LoRA 提出冻结预训练模型权重,并在每个 transformer 块中注入可训练层(秩分解矩阵)。这大大减少了可训练参数的数量和 GPU 内存需求,因为大多数模型权重不需要计算梯度。研究人员发现,通过专注于大型语言模型的 Transformer 注意力块,使用 LoRA 进行微调的质量与完整模型微调相当,同时速度更快且所需计算量更少。
用于 Diffusers 的 LoRA 🧨
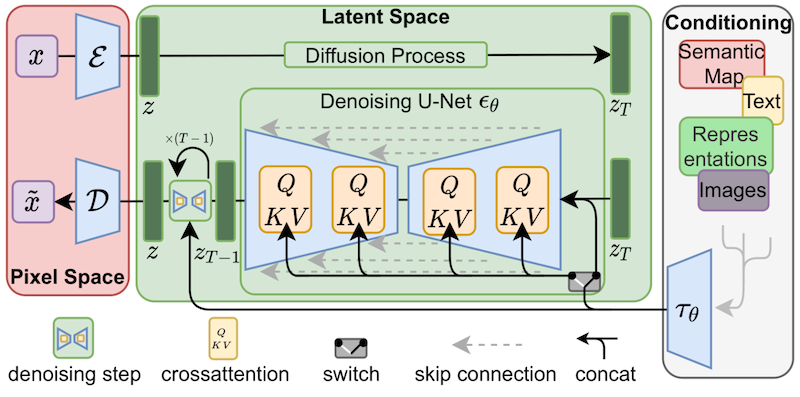
尽管 LoRA 最初是为大型语言模型提出的,并在 transformer 块上进行了演示,但该技术也可以应用于其他地方。在 Stable Diffusion 微调的情况下,LoRA 可以应用于交叉注意力层,这些层将图像表示与描述它们的提示关联起来。下图的细节(取自Stable Diffusion 论文)并不重要,只需注意黄色块是负责建立图像和文本表示之间关系的部分。
据我们所知,Simo Ryu(@cloneofsimo)是第一个提出适用于 Stable Diffusion 的 LoRA 实现的人。请务必查看他们的 GitHub 项目,以了解示例以及许多有趣的讨论和见解。
为了将 LoRA 可训练矩阵注入到模型中与交叉注意力层一样深的位置,人们过去需要以富有想象力(但脆弱)的方式修改 diffusers 的源代码。如果说 Stable Diffusion 向我们展示了一件事,那就是社区总能想出各种方法来弯曲和调整模型以实现创意目的,我们很喜欢这一点!提供操作交叉注意力层的灵活性可能出于许多其他原因而有益,例如更容易采用 xFormers 等优化技术。其他创意项目如 Prompt-to-Prompt 也可以使用一些简单的方式来访问这些层,因此我们决定为用户提供一种通用的方法来实现这一点。我们从 12 月下旬开始测试该拉取请求,它已随我们昨天的 diffusers 发布正式推出。
我们一直在与 @cloneofsimo 合作,在 diffusers 中提供 LoRA 训练支持,适用于 Dreambooth 和完整微调方法!这些技术提供了以下好处:
- 如前所述,训练速度要快得多。
- 计算需求更低。我们可以在具有 11 GB VRAM 的 2080 Ti 上创建一个完整微调的模型!
- 训练后的权重小得多,小得多。因为原始模型被冻结,我们注入新的层进行训练,我们可以将新层的权重保存为单个文件,大小约为 3 MB。这大约比 UNet 模型的原始大小小一千倍!
我们对最后一点感到特别兴奋。为了让用户分享他们出色的微调或 dreambooth 模型,他们必须分享最终模型的完整副本。其他想要尝试这些模型的用户则必须在自己喜欢的 UI 中下载微调后的权重,这加起来会造成巨大的存储和下载成本。截至目前,大约有 1,000 个 Dreambooth 模型注册在 Dreambooth Concepts Library 中,而且可能还有更多未注册在该库中的模型。
借助 LoRA,现在可以发布一个仅 3.29 MB 的文件,让他人使用你微调后的模型。
(感谢 @mishig25,他是我听到的第一个在日常对话中将 dreamboothing 用作动词的人)。
LoRA 微调
过去,对 Stable Diffusion 进行完整模型微调既缓慢又困难,这也是 Dreambooth 或 Textual Inversion 等更轻量级方法变得如此流行的部分原因。借助 LoRA,在自定义数据集上微调模型要容易得多。
Diffusers 现在提供了一个LoRA 微调脚本,它可以在低至 11 GB 的 GPU 内存中运行,而无需借助 8 位优化器之类的技巧。以下是你如何使用它来基于 Lambda Labs Pokémon 数据集微调模型:
export MODEL_NAME="runwayml/stable-diffusion-v1-5"
export OUTPUT_DIR="/sddata/finetune/lora/pokemon"
export HUB_MODEL_ID="pokemon-lora"
export DATASET_NAME="lambdalabs/pokemon-blip-captions"

accelerate launch --mixed_precision="fp16"  train_text_to_image_lora.py \
  --pretrained_model_name_or_path=$MODEL_NAME \
  --dataset_name=$DATASET_NAME \
  --dataloader_num_workers=8 \
  --resolution=512 --center_crop --random_flip \
  --train_batch_size=1 \
  --gradient_accumulation_steps=4 \
  --max_train_steps=15000 \
  --learning_rate=1e-04 \
  --max_grad_norm=1 \
  --lr_scheduler="cosine" --lr_warmup_steps=0 \
  --output_dir=${OUTPUT_DIR} \
  --push_to_hub \
  --hub_model_id=${HUB_MODEL_ID} \
  --report_to=wandb \
  --checkpointing_steps=500 \
  --validation_prompt="Totoro" \
  --seed=1337
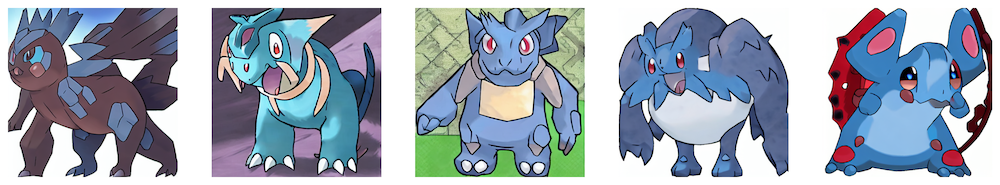
值得注意的是,学习率为 1e-4,远大于常规微调通常使用的学习率(通常约为 ~1e-6)。这是之前那次运行的 W&B 仪表板,在 2080 Ti GPU(11 GB 内存)上大约花了 5 个小时。我没有尝试优化超参数,所以请随意自己试试!Sayak 在 T4(16 GB 内存)上又进行了一次运行,这是他的最终模型,这里是使用它的演示 Space。
有关 diffusers 中 LoRA 支持的更多详细信息,请参阅我们的文档——它将始终与实现保持同步更新。
推理
正如我们讨论过的,LoRA 的主要优势之一是,通过训练比原始模型规模少几个数量级的权重,就能获得出色的结果。我们设计了一个推理流程,允许在未修改的 Stable Diffusion 模型权重之上加载额外的权重。让我们看看它是如何工作的。
首先,我们将使用 Hub API 自动确定用于微调 LoRA 模型的基础模型是什么。从 Sayak 的模型开始,我们可以使用以下代码:
from huggingface_hub import model_info

# LoRA weights ~3 MB
model_path = "sayakpaul/sd-model-finetuned-lora-t4"

info = model_info(model_path)
model_base = info.cardData["base_model"]
print(model_base)   # CompVis/stable-diffusion-v1-4
这段代码将打印他用于微调的模型,即 CompVis/stable-diffusion-v1-4。就我而言,我是从 Stable Diffusion 1.5 版开始训练我的模型的,所以如果你对我的 LoRA 模型运行同样的代码,你会看到输出是 runwayml/stable-diffusion-v1-5。
如果你使用 --push_to_hub 选项,关于基础模型的信息会由我们在上一节中看到的微调脚本自动填充。这会作为元数据标签记录在模型仓库的 README 文件中,如此处所示。
在确定我们用于 LoRA 微调的基础模型后,我们加载一个普通的 Stable Diffusion pipeline。我们将使用 DPMSolverMultistepScheduler 对其进行自定义,以实现非常快速的推理:
import torch
from diffusers import StableDiffusionPipeline, DPMSolverMultistepScheduler

pipe = StableDiffusionPipeline.from_pretrained(model_base, torch_dtype=torch.float16)
pipe.scheduler = DPMSolverMultistepScheduler.from_config(pipe.scheduler.config)
而奇迹就在这里发生。我们从 Hub 加载 LoRA 权重,叠加在常规模型权重之上,将 pipeline 移动到 cuda 设备并运行推理:
pipe.unet.load_attn_procs(model_path)
pipe.to("cuda")

image = pipe("Green pokemon with menacing face", num_inference_steps=25).images[0]
image.save("green_pokemon.png")
使用 LoRA 进行 Dreamboothing
Dreambooth 允许你向 Stable Diffusion 模型“教授”新概念。LoRA 与 Dreambooth 兼容,其过程与微调类似,但有几个优势:
- 训练速度更快。
- 我们只需要少量想要训练的主体的图像(通常 5 或 10 张就足够了)。
- 如果需要,我们可以调整文本编码器,以进一步提高对主体的保真度。
要使用 LoRA 训练 Dreambooth,你需要使用这个 diffusers 脚本。请查看README、文档和我们的超参数探索博客文章以了解详情。
如需一种快速、低成本且简单的方式来使用 LoRA 训练你的 Dreambooth 模型,请查看由 hysts 提供的这个 Space。你需要复制它并分配一个 GPU,以便快速运行。此过程将让你无需设置自己的训练环境,并且你可以在几分钟内训练你的模型!
其他方法
对简单微调的探索并非新鲜事。除 Dreambooth 外,textual inversion 是另一种流行的方法,它尝试向训练好的 Stable Diffusion 模型教授新概念。使用 Textual Inversion 的主要原因之一是训练出的权重也很小且易于分享。然而,它们仅适用于单个主体(或少数几个主体),而 LoRA 可用于通用微调,这意味着它可以适应新的领域或数据集。
Pivotal Tuning 是一种尝试将 Textual Inversion 与 LoRA 结合的方法。首先,你使用 Textual Inversion 技术向模型教授一个新概念,获得一个新的 token 嵌入来表示它。然后,你使用 LoRA 训练该 token 嵌入,以兼得两者之长。
我们尚未探索使用 LoRA 进行 Pivotal Tuning。谁想接受挑战?🤗
来源:Hugging Face:Blog(RSS) · huggingface.co