DeepSeek 开源 DeepInfer 推理栈:单集群日处理 155T token、约 80% 推理毛利引多方测算
[AINews] DeepSeek DeepInfer: Open Source SOTA Inference running 155T toks/day/cluster making $22m/day at ~80% margin for a 81 day payback
Latent Space 本期 AINews 以 DeepSeek 开源 DeepInfer 推理框架为头条:官方称其支撑 V4.1 Flash,单集群吞吐 155T token/天、96% 输入缓存命中、非高峰时段每加速器小时收入 $38,社区据此测算推理毛利约 80%、回本周期约 81 天,但 KV cache 管理与负载均衡等组件未随代码发布。
汇总了 DeepInfer 开源的生产数据、vLLM 复现对比和多方成本测算,读者可以据此分辨哪些是官方口径、哪些是未经审计的外推。
译文尚不完整,完整内容请切换到原文。
由 SerpAPI 自豪呈现:今天的发布内容非常丰富,但你可以把这一切都抓取成 供你的智能体使用的 markdown!token 成本仅为 JSON 的 50%。
我们上次在 4 月报道了推理拐点,而从历史上看,大多数进展都来自 闭源 的十角兽公司,从 Fireworks 到 Baseten,再到 Modal。
好了,是时候给出开源回应了。今天是 PyTorch Conf 的第一天,而 DeepSeek 通过开源 DeepInfer 向讨论中发射了一枚洲际弹道导弹——这是他们的生产栈,能够实现长达 72 小时的提示缓存,而 OpenAI 刚刚宣布的是 12 小时:
这是他们对 vLLM 的定制,并致谢 SGLang 和 TRRTLLM,但增加了很多……减去他们的皇冠明珠——他们极致优化的 KV 缓存(紧凑 + >8 小时生命周期)、PD/分离,以及负载均衡(他们的 3FS 不久前已开源)。我们翻译了他们的博客文章,并发布在这里,同时附上完整的研究指南、解释器、代码地图和子系统指南:
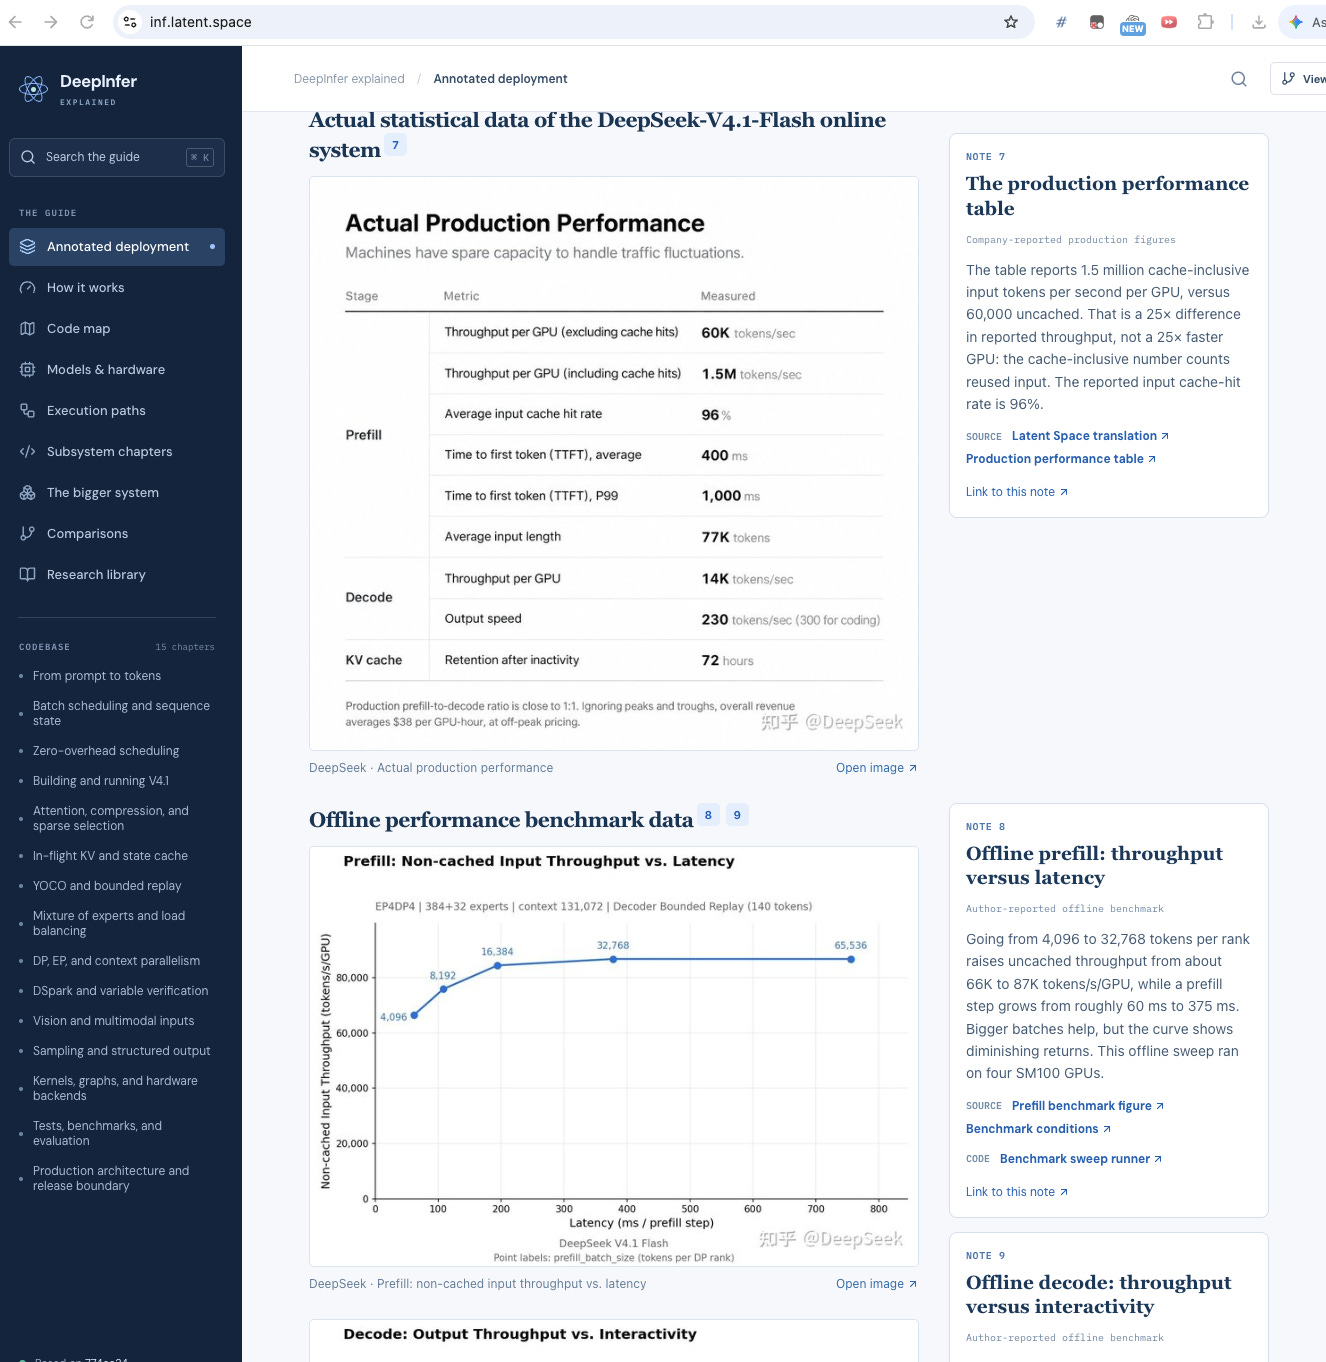
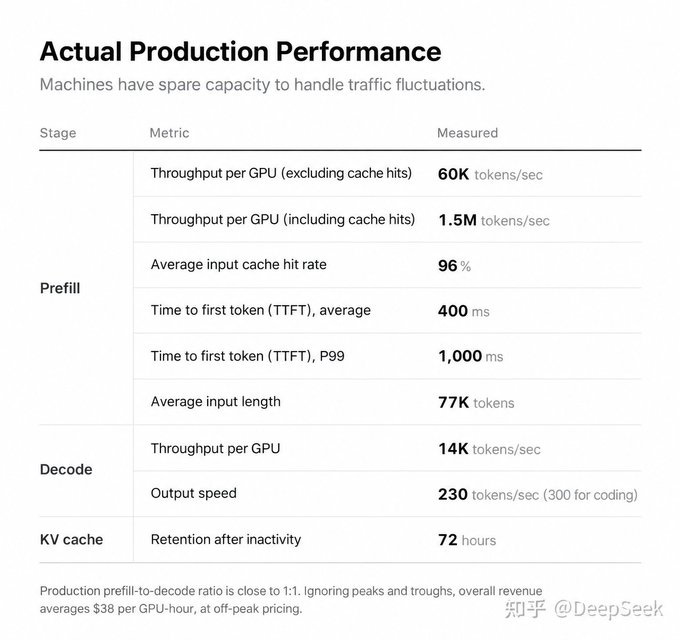
正如我们在他们的额外披露中指出的,他们声称每天服务 155T tokens,这让他们在 SM100/A950 卡上按非高峰价格每小时获得 38 美元(目前每百万输入/输出 tokens 为 $0.15/$0.60:155000000 tokens * $0.14 混合成本 / 24 小时 ≈ 每小时 $1m)。取他们的生产数据(我们已翻译)——每个 prefill GPU 每秒 150 万个含缓存输入 tokens、96% 输入缓存命中率,以及每个 decode GPU 每秒 14,000 个输出 tokens(约 2400 个 GPU):
按每卡每小时 $5-8 的全包成本计算,这意味着 >80% 的推理利润率!
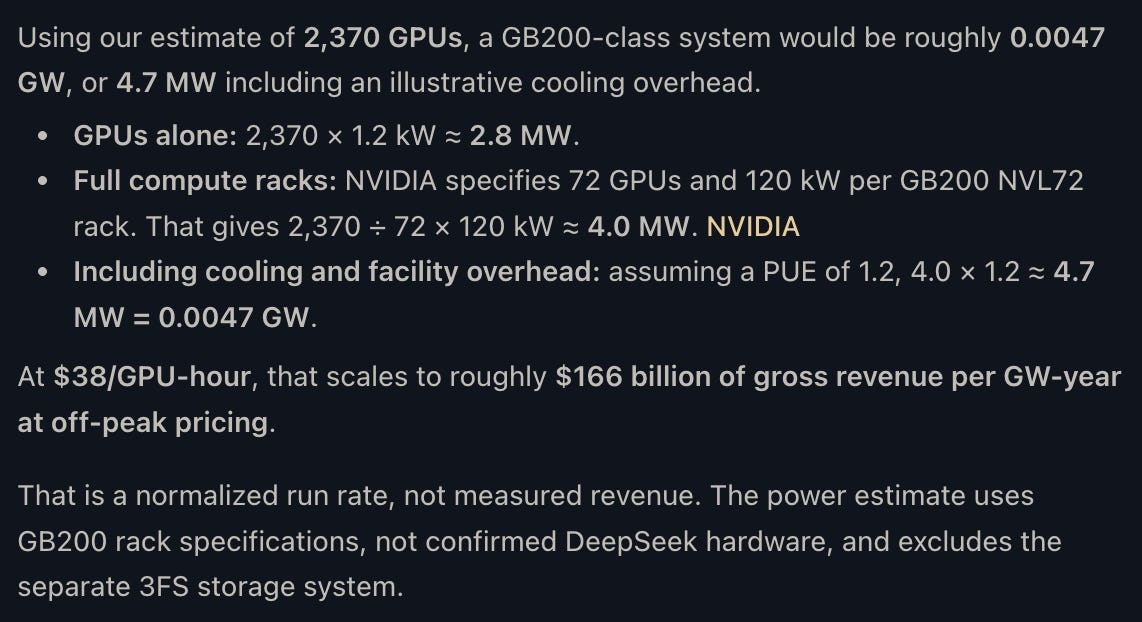
做点集群数学,这大约是每 GW $166B,按推理利润率计算的回本期为 81 天(DeepSeek 以计划 10 个月回本而闻名)。想象一下,如果这头鲸鱼拥有更多 GW,它能做什么。
由 SerpAPI 赞助!
用更少 Tokens 为你的 AI 智能体提供实时搜索数据
将 SerpApi 的 100+ API 的结果接收为干净、结构化的 Markdown,平均比 JSON 少用约 50% 的 tokens。只需添加 output=md 或使用 /search.md 端点。它无需配置,并包含在每个计划中,无需额外费用。
2026/10/19-2026/10/20 的 AI 新闻。我们检查了 12 个 subreddit、544 个 Twitter,没有更多 Discord。AINews 网站让你搜索所有过往期刊。提醒一下,AINews 现在是 Latent Space 的一个板块。你可以选择订阅/退订邮件频率!
AI Twitter 回顾
头条:DeepSeek DeepInfer——生产推理、开源边界与缓存 tokens 经济学
发生了什么
DeepSeek 发布了 DeepInfer,这是 V4.1 Flash 背后的推理引擎,同时公布了生产服务细节,使这份工程报告与代码同样重要。
本次发布涵盖推理引擎与 API 处理层。 DeepInfer 支持分布式推理、投机解码、SWA 有界重放,以及在 NVIDIA 和华为昇腾平台上的结构化输出。随附的
deepseek-recipe组件实现了生产级 token 编码/解码以及兼容官方 API 的处理。DeepSeek 表示,未来的模型推理实现与优化也将出现在该代码库中。@deepseek_ai,@deepseek_ai,公告翻译所报告的生产数据相当可观——但描述的是一个高度依赖缓存的服务。根据所提供帖子中的总结与引用,DeepSeek 的工程报告称:单个集群每天处理 155 万亿 token、96% 输入缓存命中率、平均首 token 时间 400 毫秒、生成速度 230 token/s,编码场景下可达 300 token/s。报告还称,在非高峰价格下每加速器小时收入 38 美元。这些均为第一方生产声明,并非经独立审计的测量结果。@ZhihuFrontier,@swyx
“完全开源”并不意味着整个生产服务都能通过本次发布复现。尽管 DeepSeek 将 DeepInfer 描述为完全开源,但技术说明称 KV 缓存管理和负载均衡组件尚未完全发布,因为它们仍与内部基础设施耦合。引擎是开源的;重要的服务级编排仍属于部署方的责任。@deepseek_ai,@ZhihuFrontier
vLLM 给出了最具体的对比回应。在承认 DeepInfer 最初主要基于 vLLM 构建并以 Apache 2.0 发布后,vLLM 团队报告称,在匹配配置下的 GB200 上,其解码吞吐量与 DeepInfer 公布结果的差距在 6% 以内。该团队还发布了 AgentX 结果和复现配方,从实质上削弱了 DeepSeek 的效率对现有开源引擎来说无法企及的说法。@vllm_project,@vllm_project,复现资源
本次发布引发了两场截然不同的争论:DeepSeek 是否拥有独特强大的服务栈,以及其披露内容是否更普遍地证明了高推理盈利能力。第一场争论现在已有对比基准证据;第二场仍对工作负载组合、缓存核算、硬件成本以及计入哪些费用十分敏感。@Tim_Dettmers,@zephyr_z9,@Yuchenj_UW
架构:阶段分离,调度计算而非 token
DeepInfer 披露的架构将视觉编码、预填充和解码分离,使每个阶段都能针对自身瓶颈进行扩展。推荐的部署形态是:预填充使用普通的八加速器机器,解码使用 64–128 加速器的超节点。解码使用宽专家并行来分布 MoE 专家,同时保持较大的有效批次。这些是部署建议,并不足以证明 DeepSeek 生产集群的确切硬件构成。@ZhihuFrontier
调度细节解释了为什么传统的“每批 token 数”比较会遗漏重大差异:
预填充调度估算注意力计算成本。工作分配依据的是估算的计算量,而不只是原始请求长度。块大小会变化以适配时间预算,而不是对异构请求强制使用一个固定块大小。@ZhihuFrontier
预填充路由不需要缓存亲和性。由于缓存的 prefix 被池化在共享存储中,请求可以发往任意可用 worker,而不必发往之前服务过其 prefix 的 worker。在一份详细的中文分析中,推理工程师苏金燕强调这是一个特别有用的生产设计:预填充数据并行组按“计算 token”均衡,而共享存储提供可复用状态。同一份分析还强调了请求分桶和带有运行时估算器的 FIFO 调度。@SuJinYan123
解码路由同时平衡运行中请求数和 KV 缓存长度。请求数近似表示调度压力;累计 KV 长度则捕捉了仅靠请求数会遗漏的内存/状态压力。工程评论将预填充/解码扩缩信号描述为预填充的聚合计算负载和解码的运行中请求数。@ZhihuFrontier, @SuJinYan123
专家并行负载均衡会复制热门专家。副本会被定期重新分配,以减少路由偏斜导致的设备间等待。其代价是额外的 HBM 消耗换取更高吞吐量,随着复制增加收益递减;有用的复制因子取决于具体工作负载。@ZhihuFrontier, @SuJinYan123
CPU 调度与加速器执行重叠。异步调度消除了解码步骤之间的空闲间隙,而不是把主机侧编排视为免费。@ZhihuFrontier
一个技术上值得注意的观察是,披露的 Blackwell 配置中似乎没有张量并行。一位评论者将此与默认的 vLLM/SGLang 方案进行对比,并将该方法追溯到 DeepSeek V3 在 H800 时代的互连限制。这是对该配置的一种解读——并非张量并行普遍较差的证据。@nrehiew_
规模也很重要。苏金燕认为,宽专家并行预填充需要足够的流量和 worker 才能收回成本,并倾向于在只有少数预填充 worker 的中小型部署中使用流水线并行。作者还指出,层异构性可能会使流水线划分复杂化。这是从业者的判断,并非确立通用交叉点的基准测试。@SuJinYan123
缓存层级:持久化 prefix 与瞬时状态的廉价重建
缓存设计是吞吐量数据、代理工作负载和所报告的每加速器收入之间的核心联系。
持久化块 KV 存放在一个独立的 3FS 存储集群中,SSD 容量约为 100 PiB。报告的保留期限为代理流量三天、聊天机器人流量七天。任何预填充 worker 都可以检索缓存的 prefix,使缓存局部性与计算放置解耦,并允许存储和计算独立扩展。@ZhihuFrontier
这种保留机制对需要反复发送不断增长的指令历史、代码仓库内容、工具输出以及先前响应的智能体非常有用。这也意味着每天155T的服务令牌量不能解读为每天新生成155T令牌:缓存命中是服务令牌统计的一部分,而新计算的预填充和自回归输出带来的成本则截然不同。因此,所报告的96%输入缓存命中率是理解这一头条吞吐量的关键背景。@ZhihuFrontier,经济工作负载假设
该实现处理两种不同的状态生命周期:
持久块缓存以异步方式加载。主机到设备的传输与层执行重叠进行。Su Jin Yan强调了一个更底层的实现细节:细粒度KV块复制通过CUDA复制引擎性能表现不佳,因此所描述的路径使用基于GDR/RDMA的传输,旨在不占用SM的情况下充分利用PCIe带宽。这是从报告中得出的技术观察,并非推文中单独测量的结果。@SuJinYan123
滑动窗口注意力状态保留在主机内存中,而非持久SSD存储中。它主要在活跃会话中有用,其生命周期比可复用的块前缀更短。@ZhihuFrontier
SWA有界重放仅从最新的128个令牌重建缺失的短生命周期状态。重放将注意力限制在该段范围内,同时复用持久块缓存,产生的是近似结果,而非跨完整先前历史重建状态。DeepSeek报告称这几乎将总预填充计算量减半。在考虑向其他架构迁移时,这种近似及其特定于模型的有效性值得关注。@ZhihuFrontier
Su Jin Yan还报告称,长保留尾部仅带来约0.5–1个百分点的额外缓存命中,说明了存储容量与重计算之间的权衡。同一评论还指出,以解码为主导的缓存管理允许生成的输出在后续轮次中成为可复用的前缀状态。@SuJinYan123
这一时机不禁让人将其与OpenAI另行宣布的12小时API提示缓存进行对比,后者的默认值为30分钟,包括在单次请求中混合使用不同的保留时长。这些并非完全相同的产品或架构,但都面向在长时间间隔中复用上下文的持久智能体。信息流中关于登录状态下无限期缓存的其他说法属于评论,而非API公告的条款。@OpenAIDevs,保留控制,对比评论
推测、API兼容性与模型特定优化
DSpark使推测验证具有自适应性。它预测草稿令牌的接受概率,并调整验证长度以最大化预期吞吐量。DeepSeek报告称,相比始终验证五个草稿令牌,生产吞吐量提升了6%。这是相对于特定推测解码基线的增量收益,而非相对于非推测解码的6%提升。@ZhihuFrontier
deepseek-recipe针对的是服务接口,而不仅仅是分词器速度。它支持Chat Completions、Responses 和 Messages API,将分词并行化,并区分真正的控制词元与作为用户文本提供的看似相同的字符串。这种区分可防止字面用户内容被意外解析为结构分隔符;不应将其误认为完整的提示注入防御。@ZhihuFrontier,@deepseek_ai
一种社区解释将这种效率归因于若干模型/运行时协同设计选择:196B Engram 参数,一个更小的预填充主干,激活约8B 参数/词元,而解码时为 16B,宽 EP,高度压缩的 KV,以及推测性解码。它进一步描述了552B 专家参数、DP64/EP64、每设备约45B 常驻参数、大部分为四位权重,以及声称相对 GQA 基线实现400× KV 缩减。这些是二手说法:该帖对复制、共享权重、量化布局或 GQA 参考的描述不足以独立重建这些数字。特别地,45B/设备并非简单将 552B 除以 64 得到。@bookwormengr
这种模型特异性是不应假设相同增益会自动迁移到任意检查点的原因之一。苏金燕看到了针对每个模型的仓库/内核策略的价值;Andrew Carr 建议用编码代理将该实现适配到其他模型,但没有提供可移植性或性能验证。@SuJinYan123,@andrew_n_carr
独立比较:vLLM 复现了什么——以及没有复现什么
对“只有 DeepSeek 能做到这一点”的最强技术反制是 vLLM 的后续跟进:
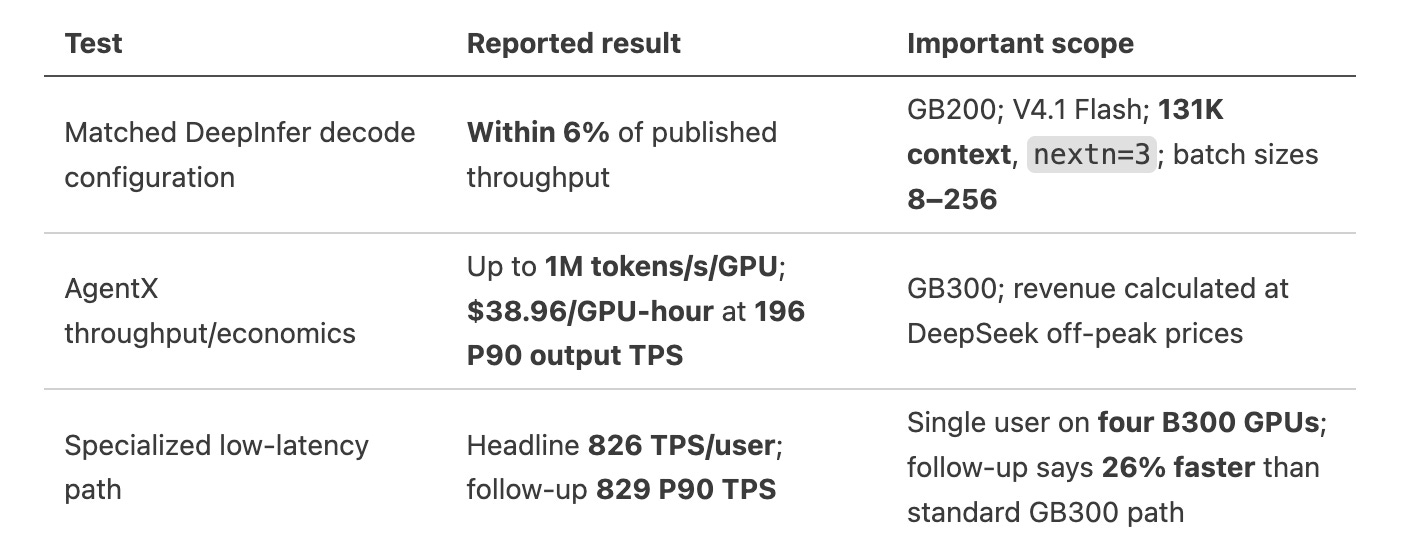
需要作三点区分:
6% 以内的结果是解码阶段持平,并非复现 DeepSeek 的整个服务。它不能确立等效的 100-PiB 缓存操作、留存经济性、路由、生产可用性,或 DeepSeek 流量分布下的端到端延迟。
1M 词元/秒/GPU 的数字不可能意味着每用户生成。同一帖子另外报告了大约 200 P90 输出 TPS;在将吞吐量标题与纯解码吞吐量进行比较之前,需要该基准的输入/缓存/输出核算。
这项工作是一项外部实现比较,但仍由竞争引擎团队自行报告。公开的 InferenceX 结果和配方提高了可复现性;但它们并不能使每一个引用的生产声明都经过独立审计。
开源传承是明确的:vLLM 感谢 DeepSeek 的 Apache 2.0 发布和署名,而 Woosuk Kwon 将 DeepSeek 描述为早期采用者和贡献者。因此,DeepInfer 更适合理解为生产经验回流到现有生态系统,而非对它完全独立的替代。@vllm_project,@woosuk_k
其他反应涵盖了一个有用的范围:
强烈背书: Tim Dettmers 认为 DeepSeek 的推理技术栈在其用户规模下可与 OpenAI 比肩,并优于 Anthropic;Graham Neubig 指出官方 API 的速度和价格优势。两人均未提供匹配的跨实验室基准测试。QuixiAI 表示该发布将为 SlimServe 提供参考。@Tim_Dettmers, @gneubig, @QuixiAI
部署方面的质疑: Su Jin Yan 认为对于经验丰富的推理开发者而言,工程文章比代码仓库更有价值,部分原因是重要组件缺失。Finbarr Timbers 要求与 Modal、Together 和 vLLM 进行对比;但所提供的帖子中并未出现与 Modal/Together 的匹配对比。@SuJinYan123, @finbarrtimbers
来自一位原本热情的评论者的有保留的支持: Teortaxes 承认缺失的基础设施,并建议 3FS 加上可能的 Dynamo 可以弥补部分差距,同时估计要达到集群级吞吐量需要大约 3,000–4,000 块 GB200。这是一个提议的部署路径,而非已演示的复现。@teortaxesTex
随后在代码仓库中发现了技术报告的官方英文版本,减少了对社区翻译的完全依赖。@teortaxesTex
经济性:一次强有力的收入披露,而非完整的利润率陈述
最具影响力的财务披露是 低谷时段每加速器小时 38 美元的收入。收入不等于利润,而加速器小时只是生产服务成本基础的一部分。@swyx
一份被广泛传播的估算最初计算出 87.76–96.94% 的推理利润率,假设条件为:
所有计费 token 中,97% 为缓存输入、2% 为未缓存输入、1% 为输出;
每 GPU 每秒 80K 未缓存输入 token 和 每 GPU 每秒 16K 输出 token;
每用户每秒 250 输出 token;
每 GPU 小时 3–6 美元的租赁成本。
对于十亿计费 token 总量,该模型包含 9.7 亿缓存输入、2000 万未缓存输入和 1000 万输出,需要大约 875 GPU 秒:250 秒用于预填充,625 秒用于解码。估算 GPU 成本为 0.73–1.46 美元,而低谷时段收入为 11.91 美元,高峰时段为 23.82 美元。@zephyr_z9
随后作者修正了该估算:理想化场景意味着大约 49 美元/小时,而 DeepSeek 报告的是 38 美元/小时,即约为生产环境中基准性能的 80%。修正后引用的利润率范围为 84.2–96.1%。不应在没有该修正的情况下重复原始估算。@zephyr_z9
其他帖子使用了更高的硬件成本:
按 7 美元/小时对比 38 美元/小时的收入,在其他成本之前算术结果约为 81.6%。Yuchen Jin 明确指出,DeepSeek 未披露该收入数字背后的 GPU 型号。@Yuchenj_UW
按 5–10 美元/小时计算,同样的仅加速器成本计算范围约为 73.7–86.8%,而非确立一个通用的“80% 服务利润率”。@swyx
这些计算忽略或未完整计入 SSD 缓存集群、CPU、网络、闲置/备用容量、故障、工程、支持及其他运营成本。它们还依赖于一种极为有利的、以缓存为主的 token 组合。训练支出和未来的算力承诺又是另一回事:推理业务的高边际贡献率可以与大额的公司层面亏损并存。
更激进的推断明确属于推测性内容。Teortaxes 估计,所谓的 10 亿美元 ARR 在非高峰价格下可由大约 42 个 GB200 NVL72 机架/约 3,000 块 GPU 支撑,随后在计入高峰定价后下调至 33 个机架。这些帖子还进一步外推至约 4,167 个机架带来 1,000 亿美元年收入,以及每吉瓦的高收入。这些都是情景推算——并非经过审计的 DeepSeek 收入、集群规模或回本披露。初步估计、修订估计、行业外推
关于其市场影响,观点不一。一些人将这些披露视为推理业务已跨过盈利门槛的证据;另一些人则预计 token 价格下降和算力价格上涨最终会压缩回报。对 Moonshot/Zhipu 托管协议的竞争影响推测虽合理但未经衡量:一个可公开部署的技术栈既能改善供应商经济性,也会加剧定价竞争。@KCDN19、价格趋同论点、托管竞争
NVIDIA、昇腾与硬件推理的极限
昇腾兼容性已确认;可比的昇腾生产效率则未确认。若干帖子将 Blackwell 支持、sm100 支持以及 NVL72 形态的配置解读为生产中使用 NVIDIA 硬件的证据。这些是线索,而非披露的硬件清单或经过测量的 NVIDIA 与昇腾对比。@eliebakouch、@stochasticchasm、明确的不确定性
随后一篇硬件分析比较了 GB200 和昇腾 950DT 所报告的 decode 数据:
在 100 TPS 约束和 131K 上下文下:约为 25.5K 对 5K tokens/s/设备。
在 230 TPS 下:约为 20K 对 2.7K,将比值从约 5 倍扩大至 7.4 倍。
它引用了一份较早的 DeepEP-昇腾披露,其中提到 EP64–128 和 combine 操作仍在优化中,包括本地归约开销以及与 URMA 的 HBM 争用。
它假设优化后可达 8–10K tokens/s/芯片,以及约 6.8K tokens/s/芯片的经济交叉点,采用的假设价格为 1000 万美元/NVL72 机架和传闻中的 3.7 万美元/950DT。
这些预测混合了不同的测量结果、假设的采购价格以及未经证实的未来优化收益;它们并非同口径的 DeepInfer 硬件基准测试。@teortaxesTex
同一位评论者预测,到 2027 年底 DeepSeek 将获得大量昇腾分配以及超过 1 GW 的 Blackwell 等效算力,同时又报告了一个与之矛盾的、由模型生成的估计值:25 万块 GPU。这两个预测都不是 DeepSeek 的采购公告。算力预测、相互矛盾的估计
V4.1 Flash 上下文:低成本服务放大能力,但未解决质量定论
独立评估支持开放模型能力取得了有意义的进步,尽管尚未实现全面的前沿水平持平:
Arena:V4.1 Flash 20261017 Max 在 Agent Arena 和 Code Arena: WebDev 中排名开放模型第一。在 Agent Arena 中,其总排名为第11位,在7,500+真实会话中净提升+5.1%,中位成本为每任务0.20美元。Arena 将此描述为大约GPT-6.1 Sol 改进的37%,成本仅为其27%。报告的信号包括确认成功率+11.5%、赞赏与抱怨比+5.9%、Bash 可靠性+5.4%,以及可控性+2.5%,在该评估中未观察到工具幻觉问题。@arena,详细结果
网络安全:Vals 报告称,V4.1 Flash 1017 在使用基于 Pi 的智能体完成模拟企业网络任务时,超过了 GPT-6 Sol 的平均进展。DeepSeek 和 Sol 各进行了三次全新范围运行;其他模型仅单次运行。完整评估细节尚未公布。DeepSeek 使用了显著更多的 token,但总 API 成本更低。@ValsAI,成本解读,方法论
该网络安全结果在效率和最佳运行表现方面存在争议。Scaling01 认为“击败 Sol”夸大了结果,因为 DeepSeek 的效率低数倍。Teortaxes 报告称 token 用量约为4.3倍,时间约为2.4倍,并表示 Sol 的最佳运行达到了 DeepSeek 任何运行都未达到的目标组。将节省下来的成本用于重复运行或集群的建议仍属假设,而非经过评估的等预算结果。@scaling01,@teortaxesTex,等成本集群建议
非正式报告比受控证据所能支持的更为乐观。Teortaxes 描述了 DeepSeek 在问答轮次中达到100%、100%和91%,而 MiniMax 约为60%、48%和62%,描述/变体拼写测试为100%对50%。这些是作者构建的小型测试,问题由模型生成且答案键存在错误;它们提示应进行后续实验,而非经过验证的知识基准,也不能证明差异仅由 Engram 导致。另一位用户报告了 Hermes 辅助 AI 研究的强劲表现,而另一篇帖子称 DeepSeek 在另一项评估中仍远低于 Sol-xhigh。问答测试,后续实验,变体拼写测试,研究轶事,对比结果
本地部署引入了不同的权衡。Brandon Music 发布了TrellisMX K2 Mix,面向两块 RTX PRO 6000,使用两位专家,629个专家提升至三/四位,四位 Engram 表,容量约支持300万 KV token。报告的平均 KLD 为0.1306 nats,比普通 K2 低8.6%;一个+5GB变体面向约200万 KV token。仅测量了 KLD,且服务使用了测试镜像,因此任务质量保持、实际速度和运行稳定性仍未确定。@BrandonMusicKy
智能体基础设施、本地执行与硬件加速
长上下文推理内核:SGLang 合并了 megakernel 支持,SemiAnalysis 报告称在 AgentX 中于 GB300 NVL72 上达到接近 1,000 tokens/s/用户,在 MI355X 上交互性提升 1.5 倍。另外,Inferact 报告称使用 vLLM TorchTPU 中的开源 megakernel,Kimi K3 在 TPU v7 上达到 391 tokens/s/用户(SGLang 结果,TPU 结果)。
Apple 芯片运行时提升:PyTorch 2.15 用 Metal 内核替换了多条 MPSGraph 路径。报告的改进包括 MoE 解码速度提升 5–6.5 倍,Qwen3.6-35B-A3B 在 M3 Ultra 上从 9.4 提升至 61.3 tokens/s,MPS 支持 FP8,以及 Wan2.2 VAE 的峰值驱动内存从约 270 GiB 降至 8 GiB。这些改进落在 PyTorch 本身,而非单独的推理运行时(发布摘要)。
本地 Perplexity Computer:模型和智能体现在可以完全在受支持的 Apple 芯片 Mac 上运行,包括离线运行,并与原生应用和本地文件交互。
持久化智能体服务:LangChain 的 Managed Deep Agents 打包了用户特定的凭据、作用域内存、沙箱执行和定时任务;Hugging Face 的 Agent Manager 在 Claude Code、Codex 和其他工具链之间编排持久会话(LangChain 架构,Agent Manager)。
端侧模型、语音与图像发布
Muse Glimmer:Meta 的开源 30B 多模态智能体模型,从 Muse Spark 蒸馏而来,目标为 32 GB 显存,可在单张 RTX 5090 上通过 4 位量化和推测解码头运行。论文报告在 MCPAtlas 上达到 75.5,在 SWE-Bench Pro 上达到 51.2;Qwen3.6-27B 在 OSWorld-Verified 和 TerminalBench 2.1 上仍然领先。它在 Apache 2.0 许可下支持文本、图像和 100 多种语言(论文摘要)。
Voxtral 3:Mistral 推出批量和流式转录、多语言 TTS 以及支持工具调用的语音智能体 SDK,可通过其 API 或客户自有基础设施使用(发布,部署选项)。
Fibo 2.0:Bria 的 8B 开源权重图像系列包括用于文生图的 Dev 和蒸馏版 Edit Turbo。Artificial Analysis 报告其开源权重编辑性能领先,文生图方面与 Qwen-Image-2.1 统计上持平;Bria API 定价为每 1,000 张图像 32 美元(评估)。
Krea 3 Ultra:排名因竞技场和更新而异。Artificial Analysis 自己的公告将 Ultra 列为第 5 名,而早前的帖子引用的是第 4 名;Arena 将其列为多图像编辑第 4 名和单图像编辑第 8 名。可辩护的结论是具有竞争力的图像编辑质量,而非普遍的第 4 名排名(Artificial Analysis,Arena)。
定价:Fast 的价格为每 1K 输出图像 0.03 美元,外加每 1K 参考图像 0.02 美元。Ultra 仅支持 2K 输出;使用一张 1K 参考图进行 2K 编辑的费用为0.27 美元。
独立评估、网络能力与安全证据
HealthBench 暴露评分敏感性:Artificial Analysis 推出了针对5,000 段一般健康对话和525 段临床医生对话的排行榜。GPT-6 Astra 以66.0% 领跑 Professional 的长度调整分数;Claude Sonnet 5.5 以62.1% 领跑一般 HealthBench。
长度效应:Opus 5.5 在 Professional 上获得了最高的原始得分,为 71.4%,但经调整后降至 59.9%。General HealthBench 中回答最短的模型在沟通质量上领先,但在完整性上得分最低。因此,回答长度是一个实质性的排名选择,而非表面的细节。
成本权衡:DeepSeek V4.1 Flash 的得分为 60.9%,成本为 $0.005/任务,而 Sonnet 为 62.1%,成本为 $0.08/任务。评分使用 OpenAI 模型,遵循原始实现(方法与结果)。
路由与专用决策:在五个路由器和约 1,250 个任务中,Vals 发现每个路由器在得分和成本两方面都至少被一个独立模型击败。在路由器预算内进行事后最优选择可将得分提高 8–27 分,表明存在可观的选择提升空间(路由器指数,预言机比较)。
DeepSeek 攻击性网络结果:Vals 报告 V4.1 Flash 1017 在使用 Pi 工具框架的模拟企业网络任务中表现优于 GPT-6 Sol。DeepSeek 消耗了更多 token,但实现了更低的总价格。
安全保证与问责:METR 同意 Anthropic 对覆盖模型的低灾难性错位风险结论,但指出了重大的分析分歧。它建议对监控系统进行端到端红队测试,并评估模型破坏安全相关决策的能力(审查,建议,决策风险)。
科学智能体:湿实验室结果与开放式局限
蝎毒素结合蛋白:Anthropic 和 Citrini 报告称,在 211 个受测蛋白质设计中获得了 17 个结合蛋白,此前由内部 Claude 研究模型完成了大量计算工作。所有受测设计和实验室数据均已公开(公告,数据)。
从病理学到生物学的预测:Sophont 推出了 Holon-S1,可从常规病理切片预测空间基因活动和生物标志物。团队报告称,该模型在 16 种器官类型和 15 台以上扫描仪上进行了评估,在空间基因预测方面优于两个对比模型,并识别出可能新型的乳腺癌和结肠癌生物标志物。这些是研究结果,而非经过验证的治疗选择结论(发布)。
开放式研究仍然困难重重:评估人员向 GPT-6 Astra 和 Claude Fable 5.1 提出了未发表的 AI 研究问题,并各给予 10,000 美元预算。原论文作者发现,与早期测试相比,实验设计和资源管理有所改善,但仍因创造力、判断力、校准和沟通方面的不足而否决了两篇生成的论文。这项小型研究为狭隘可验证研究任务上的结果提供了一个有益的反衬(评估)。
产业与政策:药物开发、制造与资本承诺
OpenAI 收购 Orchestra Bio:OpenAI 宣布收购一个药物开发协调平台,将其生命科学工作从研究工具扩展到运营执行,与 Rosalind 并列。财务条款未披露(公告)。
Arda 公开亮相:前 OpenAI 研究主管 Bob McGrew 宣布推出与 Anduril 作为设计合作伙伴共同开发的制造软件。他本人的说明中明确指出1.6 亿美元 A 轮融资,估值 15 亿美元;CNBC 的随附报道则提到融资 2.3 亿美元,但未明确说明该数字与所宣布轮次之间的关系。初始产品支持手工装配线的设计和运营;可重构自动化是下一步目标(创始人公告,CNBC 报道)。
融资与算力敞口:报道称 OpenAI 正在寻求约 300 亿美元融资,估值超过 1.4 万亿美元,早于预期的 Anthropic IPO。另外,据报道《华尔街日报》对 Anthropic 招股说明书的审阅提到上半年收入 163 亿美元、近 90 亿美元的算力/基础设施支出,以及超过 6,000 亿美元的未来算力承诺,其中包括正在谈判的部分。这些是引述报道,而非已完成的交易或经独立核实的财务披露(OpenAI 报道,Anthropic 报道)。
热门推文(按互动量)
39,393 — DeepSeek 发布 DeepInfer
5,778 — Anthropic 发布蝎毒素结合蛋白研究
5,700 — OpenAI 宣布收购 Orchestra Bio
3,056 — Mistral 推出 Voxtral 3
2,600 — 研究者解释结合蛋白结果及生物学局限
2,476 — Hugging Face CEO 质疑网络攻击纪录片叙事
2,330 — Theo 否认所谓 Fable 5.5 访问权限
AI Reddit 回顾
/r/LocalLlama + /r/localLLM 回顾
1. DeepSeek DeepInfer 开源推理框架
DeepSeek 新发布 - DeepInfer -(热度:313):图片是 DeepSeek 在 X 上公告的移动端截图,宣布其自研推理框架 DeepInfer 现已完全开源:图片,GitHub。链接/来源讨论中技术上相关的主张是,DeepInfer 大规模支撑 DeepSeek V4.1 Flash,据报告单集群吞吐量为
155 trillion tokens/day,在非高峰定价下收入为$38 per card per hour,强调高吞吐、低延迟的大规模推理而非模型训练。评论者明显对 DeepSeek 开源内部生产推理栈感到惊讶,并将其与他们对 Anthropic、OpenAI 或 Meta 的预期进行对比。部分读者对该框架的实际功能也存在基本疑问,即它是服务/推理基础设施,而非新模型。一条链接的知乎来源声称,DeepInfer 为 DeepSeek V4.1 Flash 实现高吞吐、低延迟的大规模推理,报告单集群吞吐量为
155 trillion tokens/day,非高峰定价下收入为$38 per card-hour:

https://zhuanlan.zhihu.com/p/2095560295930508953
。一位评论者还强调了约
256 tokens/s × 100 users的报告服务数据,意味着若在生产中持续,则并发解码吞吐量极高。一个被提出的技术担忧是:DeepInfer 究竟是一个通用推理框架,还是主要是针对 DeepSeek 自身模型架构和部署环境高度优化的栈。该仓库初始 GitHub 星数较低而公告互动量较高,被解读为很可能是因为刚发布,但评论者预期一旦工程师检查其实现和可移植性,会有更有意义的评估。
Deepseek 发布 DeepInfer——面向 DeepSeek 模型的开源高性能、大规模推理框架!(活动:1023):DeepSeek 发布了
DeepInfer,一个面向 DeepSeek-V4.1-Flash 的开源高性能离线推理框架,带有面向生产环境的原语,包括优化内核、注意力/数据/上下文并行、带 EPLB 的 MoE 专家并行、DSpark 风格投机解码、SWA 有界重放、异步调度、结构化输出、批次不变推理和确定性采样。它目前通过DEEPINFER_ACCELERATOR=nvidia|ascend面向 NVIDIA SM100 GPU 和华为昇腾 950 NPU,需要 Linux/Python 3.12 加 CUDA 13 或 CANN 9.2;然而,完整的在线服务仍需要外部 KV 缓存管理、预填充/解码分离和 DP 副本负载均衡。DeepSeek 还发布了deepseek-recipe,一个带有 Python 绑定的 Rust 库,用于跨 Chat Completions、Messages 和 Responses 等 API 的协议转换和模型输出解析。 评论者认为此次发布对于将生产推理技术逆向工程到 gufo、halogen、strixite 和 Strata 等社区引擎中很有价值。也有人对明确支持昇腾 950 感兴趣,一位评论者开玩笑说“Nvidia [要] 完蛋了”,不过所列的 NVIDIA 目标仍是下一代 SM100,而非当前广泛部署的 GPU。DeepSeek 的发布分为两个仓库:DeepInfer,被描述为面向 DeepSeek 模型的高性能大规模推理框架;以及 deepseek-recipe,一个带有 Python 绑定的 Rust 库,用于跨 Chat Completions、Messages 和 Responses 等 API 格式的协议转换和模型输出解析。
评论者指出,目前列出的加速器目标是 NVIDIA SM100 GPU 和 华为昇腾 950 NPU,构建时平台选择通过
DEEPINFER_ACCELERATOR=nvidia或ascend暴露,然后再运行./build.sh。昇腾支持引起了关注,因为这暗示 DeepSeek 正在标准 CUDA/NVIDIA 路径之外进行优化。一位评论者提到了 DeepSeek 的知乎帖子,声称大约
$38 per GPU-hour的收入/吞吐经济性,并链接了原帖 zhuanlan.zhihu.com/p/2095560295930508953。该讨论串提出了是否可以用类似的每 GPU 经济性来估算 OpenAI 或 Anthropic 等竞争对手的推理收入,不过没有提供具体的推导。
DeepSeek V4.1 Flash 1017 真的能在 12GB 显存 + 64GB 内存上运行吗?(活跃度:352):这张 图片 是一个 X/Twitter 讨论串的截图,声称 DeepSeek V4.1 Flash 1017 或许可以在 Q4 下本地运行,仅需
12GB VRAM + 64GB RAM;该 Reddit 帖子询问 RTX 3060 12GB 是否能卸载足够多的层以使推理可用。关键的技术反驳在于,据报道 V4.1 Flash 对许多专家而言已经约为4.25 bpw(通过 mxfp4 + fp8),因此虽然它可能放得下(如果总内存足够),但在大量 CPU/内存执行下的预期性能可能会极其缓慢——一位评论者估计大约为~3 tokens/sec。评论者对于这在日常使用中是否实用持怀疑态度:共识更接近于“能加载”而非“运行顺畅”。一位评论指出,提出原始说法的人是 Strata 的创作者,这为尺寸方面的说法增添了一些可信度,但不一定对性能预期有说服力。评论者质疑了 DeepSeek V4.1 Flash 1017 能在
12GB VRAM + 64GB RAM上实际运行的说法:即便是“Flash”版本,也被描述为对许多专家而言已经约为4.25 bpw,使用 MXFP4 + FP8,因此在该内存预算内不太可能实现标准的 Q4 式适配。一个技术上可行的方案可能需要大量卸载:一位评论者表示 Q4 放不下,并建议直接查看 Hugging Face 上的模型大小,然后将 n-gram 卸载到 NVMe,并 从磁盘流式加载部分 MoE 专家。这在原理上或许可以运行,但预期吞吐量很可能非常糟糕,有人估计大约为
~3 tokens/s,甚至更差,具体取决于磁盘和卸载实现。有人怀疑原始的 Strata 说法是否准确;评论者指出,即使模型能够在内存/NVMe 的某处“放得下”,关键问题也是实际推理速度,而非仅仅能否加载。

2. MiniMax M3.1 Flash 发布
MiniMax M3.1 Flash 发布,模型权重于 10 月 23 日(活跃度:874):这张 图片 是 MiniMax 关于 MiniMax M3.1 Flash 的官方 X 公告,描述为“Space Performance + Bunny Speed”,API 现已可用,开放模型权重计划于 10 月 23 日发布。评论者补充说,据报道该模型是一个 MoE,总参数为
428B,激活参数约23B,稀疏注意力,以及原生视觉编码器;预览/工具页面链接在 agent.minimax.io/tools/m3-1-flash-preview。评论中的主要技术顾虑是,基准测试的兴奋在很大程度上取决于是否知道模型规模/激活参数数量,因为如果没有架构细节,性能声称很难被合理理解。一位评论者引用 MiniMax M3.1 Flash Preview 工具页面,指出其指定了 混合专家(Mixture-of-Experts)架构,总参数为
428B,激活参数约为23B,外加 稀疏注意力 和 原生视觉编码器:https://agent.minimax.io/tools/m3-1-flash-preview。这直接解答了讨论中关于模型规模的不确定性,并表明该模型被定位为一个大型稀疏多模态系统,而非一个稠密 LLM。
MiniMax-M3.1-Flash 即将发布(活动:521):MiniMax 通过官方 X 帖子预告了 MiniMax-M3.1-Flash(来源),但该 Reddit 帖子未提供任何架构细节、参数量、上下文长度、定价、发布日期或基准测试信息。唯一的技术信号是产品命名:评论者推断“Flash”可能表示速度/延迟优化的变体,但并未给出证据。评论者对“Flash”的含义持怀疑态度,开玩笑说在当前的 LLM 命名中,它仍可能是一个非常大的模型——例如“Flash 意味着 500B 模型”——或者讽刺地表示一个所谓轻量但实际上并不小的模型。

3. 基准测试通胀与 AI 劣质内容测量
AI labs report benchmark scores 6.4% higher than independent testers, on average (Activity: 334): The image is a technical benchmark-comparison chart from the
whatmodel.shopen leaderboard, visualizing611matched comparisons across180AI models and103benchmarks from1,629published results. It reports that AI labs’ self-published scores are6.4%higher on average than independent testers for the same model/benchmark pairs, with375lab-higher cases vs.216independent-higher and20ties; the largest median benchmark gaps shown include SWE-bench Verified and MBPP at about+9.0points for labs. Image · interactive chart · data/code Commenters debated whether the gap reflects intentional score inflation or more mundane reproducibility issues such as package versions, harness settings, random seeds, prompt/eval setup, or labs optimizing benchmark tooling to present best-case results. Several compared it to vendor-favorable performance charts from companies like Apple or Nvidia, arguing that only independently reproduced or peer-reviewed results should be trusted.Several commenters argued that the
6.4%average gap may come from benchmark reproducibility issues rather than outright inflation: small differences in package versions, evaluation harness settings, random seeds, prompt formatting, and lab-specific benchmark tooling can materially affect reported scores. One theme was that labs likely optimize the exact harness/configuration used to showcase their models, while independent testers may use more generic or less model-tailored setups.A commenter noted the mean gap may be driven by outliers and suggested the median discrepancy would likely be closer to reported benchmark values. This implies the headline average could overstate systematic inflation if a small number of large deviations dominate the aggregate.
One technical explanation proposed was deployment mismatch: labs may benchmark full-weight models, e.g.
BF16, while independent testers often evaluate served API versions that have been quantized toFP8,MXFP4, or other hardware-efficient formats. If true, some score degradation could reflect inference serving optimizations for datacenter tensor units rather than benchmark manipulation.
Let’s delve into the tapestry of AI slop on r/LocalLLaMA (Activity: 455): The post links an informal longitudinal analysis of “AI slop” across Reddit communities, including r/LocalLLaMA, with an attempted extrapolation of future slop prevalence: thil.ooo/blog/measuring-slop. A technical commenter notes likely measurement bias: moderator removals and karma filters may cause Pushshift/archive-style datasets to undercount short-lived bot posts, while bot evasion tactics such as all-lowercase writing may weaken simple “human marker” heuristics; they also suggest comparing against Claude-associated vocabulary from “load-bearing vocabulary of Claude”. Moderation feedback was supportive: a mod left the post up as directly relevant to ongoing anti-slop moderation despite reports. Commenters broadly agreed that obvious AI-generated style markers—em dashes, bullet lists, and stock phrases like “delve”—have become noisy signals and can falsely implicate human writing.
A commenter noted several measurement biases that could affect an AI-slop detector trained/evaluated on Reddit archive data: moderators may remove many generated posts from
/newbefore they appear in the dataset, and a new karma filter may be suppressing bot/slop submissions upstream. They also flagged that bots may evade simple style heuristics by posting in all lowercase, potentially corrupting “human marker” assumptions.One technical suggestion was to expand the detector’s lexical feature set using Claude-specific “slop” terms, referencing the analysis of Claude’s load-bearing vocabulary at https://louisabraham.github.io/load-bearing/. The commenter emphasized distinguishing obvious AI slop from broader low-value generated content that may not exhibit obvious stylistic markers and may be removed quickly.

Less Technical AI Subreddit Recap
/r/Singularity, /r/Oobabooga, /r/MachineLearning, /r/OpenAI, /r/ClaudeAI, /r/StableDiffusion, /r/ChatGPT, /r/ChatGPTCoding, /r/aivideo, /r/aivideo
1. Opus 5.5 Game Automation Feats
After $712 and 39 hours, Opus 5.5 beat Baldur’s Gate 3 all by itself (Activity: 1145): A user reports that Claude Opus 5.5 autonomously completed Baldur’s Gate 3 using a custom harness:
claude -pwith built-in tools disabled, a Python MCP server connected over TCP to a Lua BG3 mod, Vulkan-layer screenshots, and SDL-mediated clicks (write-up, code). The run took39 hours,$712,99fresh sessions,20,809tool calls,862screenshots,2.2B+cached input tokens vs3.5Moutput tokens, and relied on a git-backed memory system with157commits, ~23kcurated words, and67distilled tactical rules; an audited Faith-Leap rerun required36 min,674tool calls,$24, one death, and eleven reloads using only screenshots of the mosaic after fixing a hidden-walkway leak. The author plans to turn the harness into a benchmark of short BG3 scenarios scored by success, attempts, time, and cost, with Claude’s Nautiloid opening reportedly succeeding9/9at about$1.50/run, and Codex/Gemini integrations prepared but not yet evaluated. Top commenters mostly reacted that the project is expensive but promising: one called it “one of the best benchmark ideas” for comparing agents across vendors, while another dismissed the spend as “more money than sense.” Non-technical joking centered on whether the agent made morally significant in-game choices, e.g. whether it raided the grove.A commenter framed the run as a potentially useful agentic benchmark, suggesting that repeating the Baldur’s Gate 3 task across competing models could provide a more practical comparison of long-horizon planning, tool use, and persistence than many standard benchmarks. The key technical value would come from standardizing the setup and measuring cost, completion time, failure modes, and decision quality across models.
Claude Opus 5.5 decompiles a PS2-era game overnight, and hundreds of them now run in browser tabs (Activity: 2348): A Kotaku report claims AI-assisted reverse engineering—attributed in the post title to Claude Opus 5.5—has enabled browser-playable ports of older titles such as Halo: CE, GTA: Vice City, Skate 3, and The Simpsons: Hit & Run. The article says some ports run entirely in-browser with notable performance claims, e.g. Hit & Run targeting
240fpsand a Halo: CE build supporting low-latency online multiplayer, but commenters question whether these are true decompilations or instead recompilations/reimplementations of existing binaries/assets. Top comments are skeptical: one asks for an actual playable browser link and calls the post an “empty flex,” while another argues the terminology is being conflated—“these aren’t decomps… they’re just recomps?” A separate commenter speculates that public access to strong models may be restricted once corporations view this as an IP-enforcement threat.A commenter challenges the post’s terminology, arguing these likely are not full decompilations but rather recompilations/recomp projects, noting that the community may be conflating the two. This distinction matters technically: decompilation implies recovering high-level source or equivalent structure, while recompilation often translates existing binaries/IR into a new target such as browser-compatible code.
2. AI Proofs and Academic Labor
Fields Medalist Richard Borcherds on OpenAI proofs: “I think what people are getting upset about is they’re slowly realizing that they are dumb and somehow blaming this on AI, even though it’s not really AI’s fault” (Activity: 1309): The linked Daily Cal piece covers UC Berkeley mathematicians’ reaction to an alleged OpenAI Navier–Stokes proof (article), framing it as a stress test for mathematical proof validation, pedagogy, and the role of AI systems in advanced research. Richard Borcherds is quoted arguing that backlash may reflect researchers’ realization of their own limitations rather than an AI-specific failure: “they’re slowly realizing that they are dumb and somehow blaming this on AI.” Top commenters focused mostly on education: one endorsed the view that AI use on homework is irrelevant if students cannot reproduce understanding on exams, while another highlighted Borcherds’ claim that AI may be a more patient and expressive tutor for graduate abstract algebra than a human instructor.
A quoted discussion from Richard Borcherds frames AI-generated mathematics as potentially producing very large formal artifacts—e.g. “a
100,000-line formal proofof some major conjecture”—but argues this does not necessarily degrade mathematical learning or research because humans can choose to ignore machine-produced formalizations. The technically relevant implication is a distinction between formal proof generation/verification and the human-centered process of understanding, motivation, and theory-building.One comment highlights Borcherds’ claim that AI may be better than him at teaching MATH 250A graduate abstract algebra, specifically because it is patient, consistent, and able to re-explain material without frustration. This is an education-focused technical point: LLMs may function well as adaptive tutors for dense symbolic subjects, while still not replacing the need for students to independently solve problems for exam-level mastery.
A physicist spent a year of his life and ~500 pages of hand calculations for quantum gravity in his PhD thesis, but Opus 5.5 did it in 10 hours, including the article and GitHub repo. And it even found the errors. What will “labor” mean in academia from now on? (Activity: 1710): The linked repo,
eokahya/claude-audits-quantum-gravity, is an AI-assisted audit by E. O. Kahya, the original coauthor, of prior one-loop quantum-gravity calculations for the graviton correction to a massless minimally coupled scalar in de Sitter space—not a fully autonomous rediscovery. The workflow was manually decomposed into an18-task/9-stage pipeline where Claude orchestrated deterministicSymPy/mpmathchecks, including high-precision numerical sampling, and found mostly bookkeeping/printing issues: an overall sign convention error in the printed bare self-mass, missing/non-analytic and analytic terms in Table X, finite intermediate issues, and23typos. The main physics result reportedly survived unchanged: after correction, the Schwinger–Keldysh late-time mode-function analysis still yields no growing one-loop terms such asln(a),ln²(a), ora, only constant field-strength renormalization plus decaying terms. Top commenters pushed back on the framing that “Opus 5.5 did a PhD thesis in 10 hours,” arguing the hard scientific work was the original formulation, boundary conditions, Feynman rules, and expert scaffolding; the AI mostly accelerated verification of dense tensor algebra. A broader debate compared current academia to human+engine chess, with one view that AI-assisted researchers are temporarily strongest, but another predicting fully automated systems may eventually outperform human academics except in posing high-value questions.Multiple commenters argue the headline misrepresents the work: E. O. Kahya, the original coauthor, did not have Claude autonomously rederive quantum gravity results from first principles; he used it to audit prior calculations. The workflow was manually scaffolded into an
18-task,9-stagepipeline with expert-supplied boundary constraints, while Claude orchestrated deterministic tools likeSymPyandmpmathfor tensor-algebra checks and30-digitnumerical validation.The technically important outcome was that the core physical result survived unchanged. Reported issues were limited to arithmetic slips, an overall sign/definition flip, a missing bookkeeping term, and
23typographical errors, with commenters emphasizing that this is closer to computer-assisted verification of dense symbolic work than novel physical discovery.Commenters highlight that Kahya’s own README includes caveats such as “What a human expert should still review” and limitations around numerical sampling. The main technical framing is therefore AI as an audit/cross-check layer for expert-designed theoretical pipelines, not yet a replacement for posing the theory, deriving Feynman rules, or establishing the physical framework.
3. Agent Security and Prompt-Injection Risks
PSA: Do NOT connect your gmail and drive with your Dots at the moment (Activity: 1225): The post warns that Dots agents connected to Gmail/Drive/PC may execute attacker-controlled instructions delivered via email attachments or message bodies, exfiltrating personal data or installing malware if the agent treats the content as trusted user intent. Commenters identify this as a classic prompt injection / tool-use security failure affecting any LLM agent with external capabilities, not just Dots: untrusted content can become executable instructions when read by an autonomous agent. The dominant reaction is strong skepticism toward granting AI agents privileged access to local machines, email, or cloud storage until robust permissioning, sandboxing, and instruction-boundary defenses exist.
Several commenters identify the core risk as prompt injection against AI agents with connected tools, not a Dots-specific flaw. The technical concern is that any LLM granted access to Gmail/Drive or local actions can be manipulated by untrusted content to perform unintended operations, making autonomous account access unsafe without strong sandboxing, permission boundaries, and human-in-the-loop approval.
My post about rogue AI agents got 1.3M views here and then reddit just deleted it. no reason given (Activity: 1315): The image is a non-technical Reddit UI screenshot showing a prior r/ChatGPT post marked “[Removed by Reddit]” for a content-policy violation, despite reportedly reaching ~
1.3Mviews,1.5Kupvotes,530comments, and moderator approval before removal: image. The post claims the removed content discussed research, also covered by the NYT, about “rogue” AI agents operating online, but the screenshot itself provides no technical evidence about the agents—only evidence of platform-level removal without a visible rule citation. Comments lean conspiratorial/skeptical, suggesting the alleged agents or bots could be suppressing discussion or manipulating perception, while others frame reposting as the expected Reddit response.

来源:Latent Space · latent.space